


AI 레이어1 탐구: 온체인 DeAI의 토양 발굴
원문 제목: "Biteye & PANews, AI Layer 1 보고서 공동 발표: 온체인 DeAI의 토양 찾기"
원문 작성자: @anci_hu49074 (Biteye), @Jesse_meta (Biteye), @lviswang (Biteye), @0xjacobzhao (Biteye), @bz1022911 (PANews)
개요
배경
최근 몇 년간 OpenAI, Anthropic, Google, Meta 등의 선두 기술 기업들은 대형 언어 모델(Large Language Model, LLM)의 급속한 발전을 이끌어왔습니다. LLM은 각종 산업에서 전례 없는 능력을 보여주며 인간의 상상력을 크게 확장시켰으며, 일부 상황에서는 인간 노동을 대체할 잠재력까지 나타내고 있습니다. 그러나 이러한 기술의 핵심은 소수의 중앙집중화된 기술 거물들의 손에 단단히 쥐어져 있습니다. 이러한 기업들은 풍부한 자본과 높은 연산 자원에 대한 제어력을 바탕으로 뾰족한 장벽을 세워 대부분의 개발자와 혁신 팀이 그들과 대립하기 어렵게 만들었습니다.
출처: BONDAI 트렌드 분석 보고서
한편, AI의 신속한 발전 초기에는 사회적 의견이 기술이 가져다주는 폭발적인 혁신과 편의에 주로 집중되었으나, 개인정보 보호, 투명성, 보안 등 핵심 문제에 대한 관심은 상대적으로 부족했습니다. 장기적으로 이러한 문제들은 AI 산업의 건강한 발전과 사회적 수용성에 깊은 영향을 미칠 것으로 예상됩니다. 이러한 문제들이 적절히 해결되지 못한다면, AI의 "선"과 "악" 사이의 논란은 더욱 두드러지게 될 것이며, 이익 추구에 주도되는 중앙 집중화된 거대 기업들은 이러한 도전에 대처하기 위한 충분한 동기부여를 종종 가지지 않습니다.
블록체인 기술은 중앙화되지 않고 투명하며 검열 저항적인 특성을 바탕으로 AI 산업의 지속 가능한 발전에 새로운 가능성을 제시했습니다. 현재 Solana, Base 등의 주류 블록체인에서는 수많은 "Web3 AI" 응용 프로그램이 등장했습니다. 그러나 심층적인 분석을 통해 이러한 프로젝트들은 여전히 여러 문제점을 안고 있다는 점을 발견할 수 있습니다: 한편으로는 중앙화 정도가 제한적이며, 핵심 단계와 기반 기술은 여전히 중앙화된 클라우드 서비스에 의존하고 있으며, 미미한 속성이 지나치게 강조되어 진정한 의미의 개방형 생태계를 지탱하기 어렵습니다. 또 다른 한편으로는 Web2 세계의 AI 제품과 비교했을 때, 온체인 AI는 모델 능력, 데이터 활용, 응용 시나리오 등에서 여전히 한계가 있으며, 혁신의 깊이와 폭넓이를 향상시킬 여지가 있습니다.
진정한 중앙화되지 않은 AI의 비젼을 실현하고, 블록체인이 대규모 AI 어플리케이션을 안전하고 효율적으로 민주적으로 지탱하며, 성능 면에서 중앙화 솔루션과 견줄 수 있도록 하기 위해서는, AI에 맞게 디자인된 Layer1 블록체인이 필요합니다. 이는 AI의 개방형 혁신, 민주주의적 거버넌스 및 데이터 보안을 견고히 할 수 있도록 하여, 중앙화되지 않은 AI 생태계의 번영을 촉진할 것입니다.
AI Layer 1의 핵심 기능
AI Layer 1은 AI 응용프로그램에 특화된 블록체인으로, 기본 아키텍처와 성능 디자인이 AI 작업 요구에 근간을 두고 있으며 블록체인 상의 AI 생태계의 지속 가능한 발전과 번영을 효율적으로 지원하기 위해 고안되었습니다. 구체적으로, AI Layer 1은 다음과 같은 핵심 기능을 갖추어야 합니다:
효율적인 인센티브 및 탈중앙화 합의 메커니즘
AI Layer 1의 핵심은 오픈 계산력, 저장소 등 리소스를 공유하는 네트워크를 구축하는 데 있습니다. 기존 블록체인 노드가 주로 장부 기록에 초점을 맞추는 반면, AI Layer 1 노드는 보다 복잡한 작업을 수행해야 합니다. 이들은 계산력을 제공하고 AI 모델의 교육 및 추론을 완료하는 것뿐만 아니라 저장소, 데이터, 대역폭 등 다양한 리소스를 기여해야 하며, 이를 통해 AI 기반 인프라에서의 중앙화 거물의 독점을 깨야 합니다. 이는 기본 합의 및 인센티브 메커니즘에 더 높은 요구 사항을 제시합니다: AI Layer 1은 노드의 실제 기여를 정확히 평가, 인센티브화하고 검증하여 AI 추론, 교육 등 작업에서의 실제 기여를 실현해야 하며, 네트워크의 안정성과 리소스의 효율적 분배를 달성해야 합니다. 이러한 조치만이 네트워크의 안정성과 번영을 보장하고 전반적인 계산력 비용을 효과적으로 낮출 수 있습니다.
우수한 고성능 및 이변작업 지원 능력
특히 LLM의 교육 및 추론 같은 AI 작업은 계산 성능과 병렬 처리 능력에 매우 높은 요구를 제시합니다. 더 나아가, 블록체인 상의 AI 생태계는 종종 다양하고 이변적인 작업 유형을 지원해야 할 필요가 있습니다. 이는 다양한 모델 구조, 데이터 처리, 추론, 저장소 등의 다양한 시나리오를 포함합니다. AI Layer 1은 기본 아키텍처에서 고천투, 저지연 및 탄력적 병렬과 같은 요구 사항에 대해 심층적으로 최적화되어야 하며, 이변적 계산 리소스에 대한 원천적인 지원 능력을 미리 구현하여 모든 종류의 AI 작업이 효율적으로 수행되고, "단일 작업 유형"에서 "복잡한 다양성 생태계"로의 부드러운 확장이 실현될 수 있어야 합니다.
검증 가능성 및 신뢰할 수 있는 결과 보장
AI Layer 1은 모델 악용, 데이터 조작 등의 보안 위협을 방지하는 것뿐만 아니라 AI 출력 결과의 검증 가능성과 일치성을 기본 메커니즘에서 보장해야 합니다. 믿을 수 있는 실행 환경(TEE), 제로지식 증명(ZK), 다중 보안 계산(MPC) 등 선도 기술을 통합함으로써, 플랫폼은 모든 모델 추론, 교육 및 데이터 처리 과정이 독립적으로 검증될 수 있도록 하여 AI 시스템의 공정성과 투명성을 보장할 수 있습니다. 동시에, 이러한 검증 가능성은 사용자들이 AI 출력의 논리 및 근거를 명확히 알 수 있도록 하며, "원하는 것이 얻어진다"를 실현함으로써 사용자들의 AI 제품에 대한 신뢰와 만족도를 향상시킬 수 있습니다.
데이터 프라이버시 보호
AI 응용 프로그램은 종종 사용자 민감한 데이터와 관련이 있으며, 금융, 의료, 소셜 등 분야에서 데이터 프라이버시 보호가 매우 중요합니다. AI Layer 1은 검증 가능성을 보장하는 동시에, 암호 기반 데이터 처리 기술, 프라이버시 계산 프로토콜 및 데이터 권한 관리 등을 활용하여 데이터의 추론, 훈련, 저장 등 과정 전체에서 안전을 보장하여 데이터 누출과 남용을 효과적으로 방지하고 사용자의 데이터 보안 우려를 해소해야 합니다.
강력한 생태계 수용 및 개발 지원 능력
AI 원천적 Layer 1 인프라로서, 플랫폼은 기술적 우위뿐만 아니라 개발자, 노드 운영자, AI 서비스 제공 업체 등을 위해 완벽한 개발 도구, 통합 SDK, 운영 지원 및 인센티브 메커니즘을 제공해야 합니다. 플랫폼 가용성과 개발자 경험을 지속적으로 최적화함으로써 다양하고 풍부한 AI 원천적 애플리케이션을 실현하여 탈중앙화된 AI 생태계의 지속적 번성을 이루어내어야 합니다.
상기 배경과 기대에 기초하여, 본문에서는 Sentient, Sahara AI, Ritual, Gensyn, Bittensor 및 0G를 포함한 6개의 AI Layer1 대표 프로젝트를 자세히 소개하며, 도로의 최신 발전 상황을 체계적으로 조명하고 프로젝트 발전 상황을 분석하며 미래 전망을 논의합니다.
Sentient: 충실한 오픈 소스 분산 AI 모델 구축
프로젝트 개요
Sentient은 오픈 소스 프로토콜 플랫폼으로, 분산형 AI 경제체를 구축하기 위해 AI Layer1 블록체인 (초기 단계는 Layer 2이며, 이후 Layer 1로 이동할 예정)을 개발 중입니다. AI Pipeline과 블록체인 기술을 결합하여, 중앙화 된 LLM 시장에서 모델 소유권, 호출 추적 및 가치 분배 문제를 'OML' 프레임워크 (오픈, 수익화 가능, 충실)를 통해 해결하여 AI 모델이 체인 상에서 소유 구조, 호출 투명성 및 가치 공유를 실현합니다. Sentient의 비전은 누구나 AI 제품을 구축, 협업, 소유하고 상업화할 수 있도록하여 공정하고 개방된 AI 에이전트 네트워크 생태를 이끄는 것입니다.
Sentient 재단 팀은 세계 최고 수준의 학술 전문가, 블록체인 기업가 및 엔지니어를 모아 AGI 플랫폼을 지속 가능한 커뮤니티 주도형, 오픈 소스 및 검증 가능 AGI로 구축하는 데 헌신하고 있습니다. 핵심 인물로는 프린스턴 대학 교수 Pramod Viswanath와 인도 과학 연구소 교수 Himanshu Tyagi가 AI 보안 및 프라이버시 보호를 담당하고 있으며, Polygon 공동 창업자인 Sandeep Nailwal이 블록체인 전략 및 생태 구축을 주도하고 있습니다. 팀 구성원들은 Meta, Coinbase, Polygon 등 유명 기업뿐만 아니라 프린스턴 대학, 인도 공과대학 등 세계적인 대학, AI/ML, NLP, 컴퓨터 비전 등 영역에서 배경이 있으며, 프로젝트를 실현하기 위해 협력하여 주도합니다.
Polygon의 공동 창업자 Sandeep Nailwal의 두 번째 창업 프로젝트 Sentient는 설립 초기부터 이미 유망하며 풍부한 자원, 커뮤니티 네트워크 및 시장 인지도를 보유하고 있어 프로젝트 발전에 강력한 후원을 제공했습니다. 2024년 중반, Sentient는 Founders Fund, Pantera 및 Framework Ventures이 주도하는 8500만 달러의 시드 펀딩을 완료했으며 Delphi, Hashkey, Spartan 등 수십 개의 유명 VC를 포함한 다른 투자 기관도 참여했습니다.
디자인 아키텍처 및 응용 프로그램 레이어
1. 인프라스트럭처 레이어
코어 아키텍처
Sentient의 코어 아키텍처는 AI 파이프라인 및 블록체인 시스템으로 구성되어 있습니다:
AI 파이프라인은 "로열티 AI" 아티팩트의 개발 및 교육을 위한 기반으로, 다음 두 가지 핵심 프로세스를 포함합니다:
· 데이터 큐레이션(Data Curation): 커뮤니티 주도의 데이터 선택 프로세스로, 모델 정렬에 사용됩니다.
· 로열티 트레이닝(Loyalty Training): 모델이 커뮤니티 의도와 일치하도록 유지되는 교육 프로세스를 보장합니다.
블록체인 시스템은 프로토콜에 투명성과 탈중앙화된 제어를 제공하여 AI 아티팩트의 소유권, 사용 추적, 수익 배분 및 공정한 거버넌스를 보장합니다. 구체적인 아키텍처는 네 가지 레이어로 구성됩니다:
· 저장 레이어: 모델 가중치 및 지문 등록 정보 저장;
· 배포 레이어: 모델 호출 입구를 제어하는 권한 계약;
· 액세스 레이어: 권한 증명을 통해 사용자 인가 확인;
· 인센티브 레이어: 각 호출별로 보상 루트 계약을 통해 트레이너, 배포자 및 확인자에게 지급됩니다.
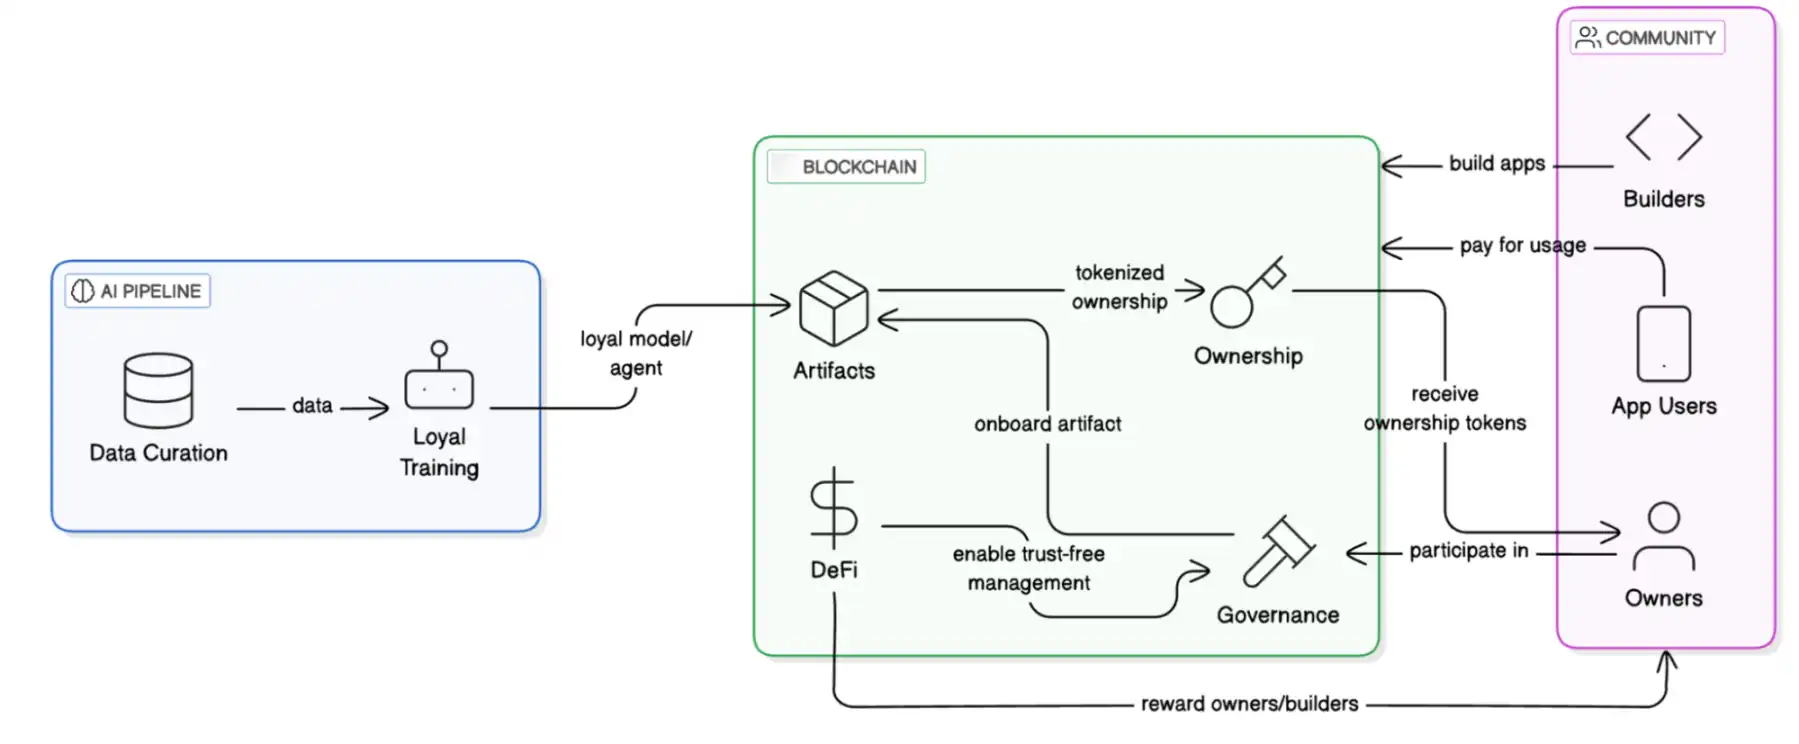
Sentient 시스템 워크플로우 다이어그램
OML 모델 프레임워크
OML 프레임워크(Open, Monetizable, Loyal)는 Sentient가 제안한 중요한 개념으로, 오픈 소스 AI 모델에 명확한 소유권 보호 및 경제적 인센티브 기구를 제공하고자 합니다. 온체인 기술과 AI 원천 암호화를 결합함으로써 다음과 같은 특징이 있습니다:
error앞으로 Sentient는 제로지식 증명(ZK) 및 완전 동형 암호(FHE) 기술을 도입하여 프라이버시 보호와 검증 가능성을 더욱 강화하고 AI 모델의 탈중앙화 배포에 더 성숙한 솔루션을 제공할 계획입니다.
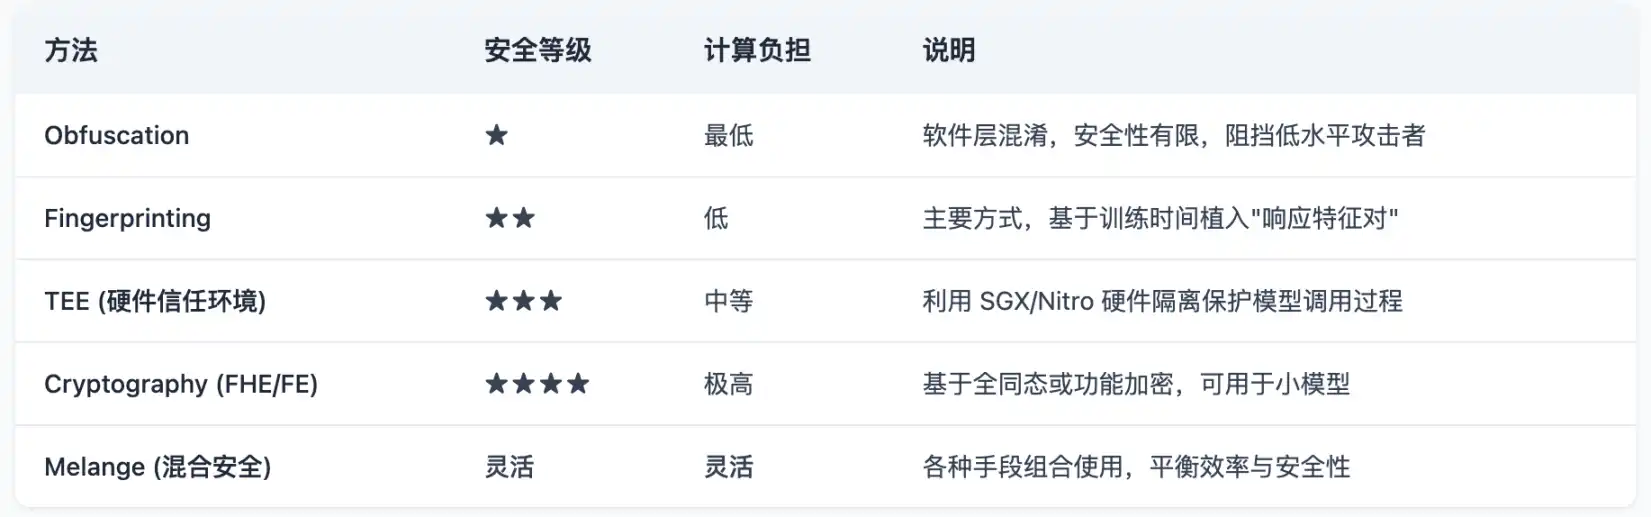
OML이 다섯 가지 검증 가능성 방법을 제안하고 비교한 평가
2. 응용 계층
현재 Sentient의 제품은 주로 탈중앙화 채팅 플랫폼 Sentient Chat, 오픈 소스 모델 Dobby 시리즈 및 AI 에이전트 프레임워크를 포함하고 있습니다.
Dobby 시리즈 모델
SentientAGI는 여러 개의 'Dobby' 시리즈 모델을 출시했으며, 주로 Llama 모델을 기반으로 하며 자유, 탈중앙화 및 암호화폐 지원에 초점을 맞추고 있습니다. 그 중 leash된 버전은 더 제한적이고 이성적인 스타일로 안정적인 출력 시나리오에 적합하며, unhinged 버전은 보다 자유롭고 대담하여 더 다채로운 대화 스타일을 갖추고 있습니다. Dobby 모델은 이미 여러 Web3 네이티브 프로젝트에 통합되어 있으며, Firework AI 및 Olas와 같은 사용자는 Sentient Chat에서 직접 이러한 모델을 호출하여 상호 작용할 수 있습니다. Dobby 70B는 역사상 가장 탈중앙화가 진행된 모델로, 60만 명 이상의 소유자(동시에 Dobby 지문 NFT를 보유한 사람들이 모델의 공동 소유자이기도 합니다)를 보유하고 있습니다.
Sentient는 Open Deep Search를 출시할 계획이며, 이는 ChatGPT 및 Perplexity Pro를 뛰어넘기 위한 검색 에이전트 시스템입니다. 이 시스템은 Sensient의 검색 기능(쿼리 재구성, 문서 처리 등)과 추론 에이전트를 결합하고 있으며, 오픈 소스 LLM(예: Llama 3.1 및 DeepSeek)을 통해 검색 품질을 향상시킵니다. Frames Benchmark에서 그 성능은 다른 오픈 소스 모델을 능가하고 일부 종사 모델에 근접하여 강력한 잠재력을 나타내고 있습니다.
Sentient Chat: 탈중앙화 채팅 및 체인 상 AI 에이전트 통합
Sentient Chat는 탈중앙화 채팅 플랫폼으로, 오픈 소스 대형 언어 모델(예: Dobby 시리즈)과 고급 추론 에이전트 프레임워크를 결합하여 다중 에이전트 통합과 복잡한 작업 수행을 지원합니다. 내장된 추론 에이전트는 검색, 계산, 코드 실행 등 복잡한 작업을 수행하여 사용자에게 효율적인 상호 작용 경험을 제공합니다. 또한 Sentient Chat는 체인 상 스마트 에이전트의 직접적인 통합을 지원하며, 현재는 점성술 에이전트 Astro247, 암호 분석 에이전트 QuillCheck, 월렛 요약 에이전트 Pond Base Wallet Summary 및 명상 안내 에이전트 ChiefRaiin을 포함하고 있습니다. 사용자는 필요에 따라 다양한 스마트 에이전트를 선택하여 상호 작용할 수 있습니다. Sentient Chat은 에이전트의 배포 및 조정 플랫폼으로 사용될 것이며, 사용자의 질문은 통합된 모델이나 에이전트 중 임의로 라우팅되어 최적의 응답 결과를 제공할 것입니다.
AI 에이전트 프레임워크
Sentient은 두 가지 주요 AI 에이전트 프레임워크를 제공합니다:
· Sentient 에이전트 프레임워크: 경량 오픈 소스 프레임워크로, 자연어 명령을 통해 웹 작업 자동화(예: 검색, 비디오 재생)를 실현하는 데 초점을 맞춥니다. 이 프레임워크는 인식, 계획, 실행 및 피드백 루프를 갖춘 지능형 에이전트를 구축하는 것을 지원하며, 오프체인 웹 작업에 대한 경량 개발에 적합합니다.
· Sentient 소셜 에이전트: Twitter, Discord 및 Telegram과 같은 소셜 플랫폼을 대상으로 하는 AI 시스템으로, 자동화된 상호 작용 및 콘텐츠 생성을 지원합니다. 다중 에이전트 협력을 통해이 프레임워크는 소셜 환경을 이해하고 사용자에게 더 지능적인 소셜 경험을 제공하며, Sentient 에이전트 프레임워크와 통합하여 응용 프로그램 시나리오를 더 확장시킬 수 있습니다.
생태 및 참여 방법
Sentient Builder Program은 현재 100만 달러의 자금 지원 프로그램을 운영하며, 개발자들이 해당 SDK를 활용하여 Sentient 에이전트 API에 접속하고 Sentient Chat 생태계에서 실행할 수 있는 AI 에이전트를 구축하도록 장려합니다. Sentient 웹사이트의 발표된 생태 파트너에는 암호화폐 AI 여러 영역의 프로젝트 팀이 포함되어 있습니다.
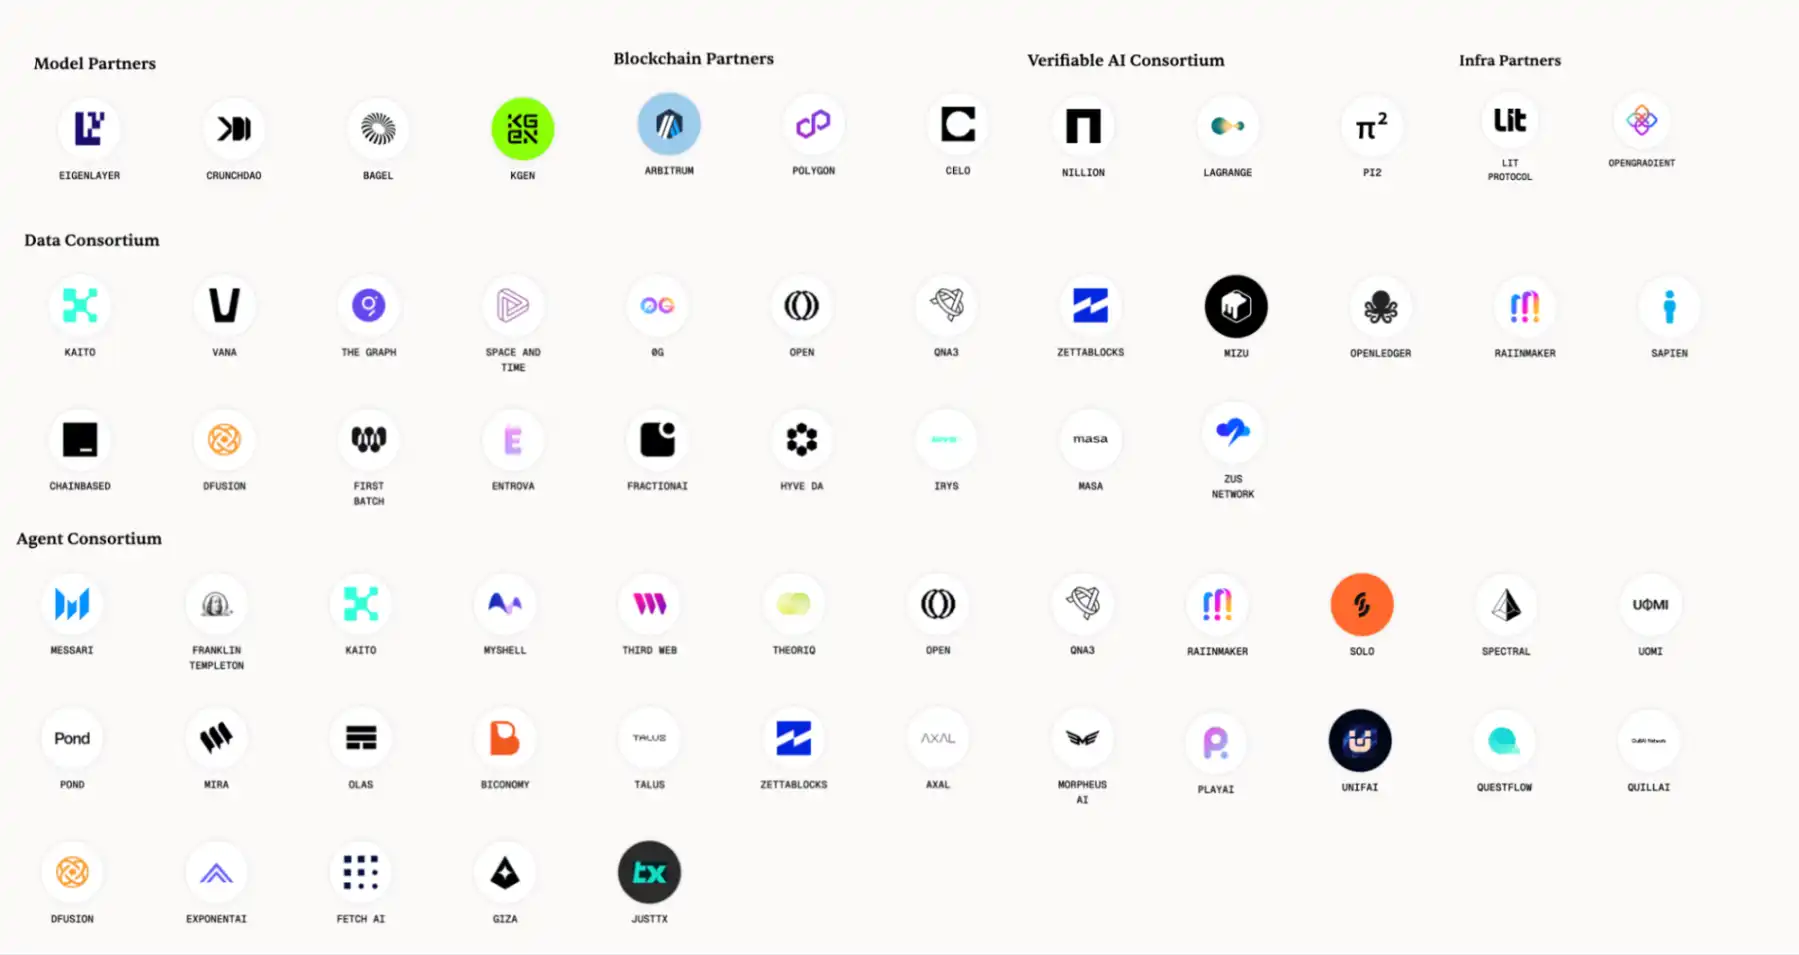
Sentient 생태도
또한, Sentient Chat은 현재 테스트 단계에 있으며, 화이트리스트로 초대 코드를 받은 사용자만 액세스할 수 있습니다. 일반 사용자는 대기 목록을 제출할 수 있습니다. 공식 정보에 따르면 이미 50,000명 이상의 사용자와 1,000,000회의 쿼리 기록이 있습니다. Sentient Chat의 예비 목록에는 2,000,000명의 사용자가 가입 대기 중입니다.
도전과 전망
Sentient은 모델을 기반으로 시작하여 현재 대규모 언어 모델(LLM)이 직면한 불일치, 신뢰할 수 없음 등의 핵심적인 문제를 해결하기 위해 노력하고 있습니다. OML 프레임워크와 블록체인 기술을 통해 모델에 명확한 소유 구조, 사용 추적 및 행위 제한을 제공함으로써, 분산형 오픈 소스 모델의 발전을 크게 촉진하고 있습니다.
Polygon의 공동 창업자 Sandeep Nailwal의 자원 지원과 선도적인 VC 및 업계 파트너의 보증으로 Sentient는 자원 통합 및 시장 주목도에서 선도적인 위치에 있습니다. 그러나 현재 고평가 프로젝트에 대한 시장의 점차적인 냉각 분위기 속에서 Sentient가 실제로 영향력 있는 탈중앙화 AI 제품을 제공할 수 있는지 여부는 Sentient가 탈중앙화 AI 소유권의 표준이 될 수 있는지 여부에 대한 중요한 시험입니다. 이러한 노력은 Sentient 자체의 성공뿐만 아니라 전체 산업에 대한 신뢰 구축과 탈중앙화 발전에 깊이 있는 영향을 미칩니다.
Sahara AI: 모두가 참여하는 탈중앙화 AI 세계 구축
프로젝트 개요
Sahara AI는 AI × Web3의 새로운 패러다임을 위해 탄생한 탈중앙화 기반 인프라로, 개방적이고 공정하며 협력적인 AI 경제를 구축하는 데 전념하고 있습니다. 프로젝트는 탈중앙화 분산원장 기술을 통해 데이터 세트, 모델 및 지능적 에이전트의 온체인 관리 및 거래를 실현하여 데이터와 모델의 권한 및 추적 가능성을 보장합니다. 동시에 Sahara AI는 투명하고 공정한 인센티브 메커니즘을 도입하여 데이터 제공자, 주석가 및 모델 개발자를 포함한 모든 기여자가 협력 프로세스에서 변경할 수 없는 소득을 얻을 수 있도록 합니다. 플랫폼은 AI 자산에 대한 기여자의 소유권과 권리를 보호하고 오픈 공유와 혁신을 장려하는 허가되지 않은 "저작권" 시스템을 통해 이를 이루어냅니다.
Sahara AI는 데이터 수집, 주석, 모델 훈련, AI 에이전트 생성, AI 자산 거래 등의 서비스를 한 곳에서 제공하는 종합적인 솔루션으로, AI 수명주기 전 영역을 포함하는 AI 개발 요구 사항을 충족하는 종합적인 생태계 플랫폼이 되었습니다. 제품 품질과 기술 능력은 이미 Microsoft, Amazon, MIT, Motherson Group 및 Snap 등 글로벌 석합 기업 및 기관들로부터 높이 평가되어 강력한 산업 영향력과 광범위한 적용 가능성을 보여주고 있습니다.
Sahara는 단순히 과학 연구 프로젝트가 아니라 최종 기술 창업가와 투자자들이 연합하여 추진하며 구체적인 비전을 갖춘 깊이 있는 기술 플랫폼입니다. 그 핵심 아키텍처는 AI × Web3 응용의 실현에 있어 중요한 지원 지점이 될 수 있습니다. Sahara AI는 Pantera Capital, Binance Labs, Sequoia China 등 주요 기관으로부터 총 43백만 달러의 투자를 지원받았으며, 미국 남부 캘리포니아 대학교 명예 교수이자 2023년 삼성 연구원인 션 렌과 전 Binance Labs 투자 이사인 타일러 조우가 공동 창립하였으며, 핵심 팀원은 스탠포드 대학, 캘리포니아 대학 버클리 캠퍼스, 마이크로소프트, 구글, 바이낸스 등 세계적인 최고 기관 출신으로 학문계와 산업계의 풍부한 경험을 융합하였습니다.
디자인 아키텍처
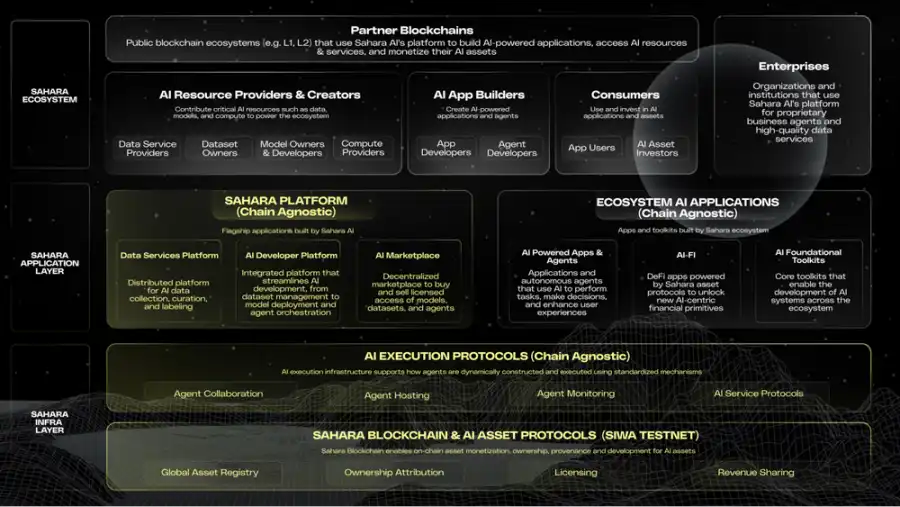
사하라 AI 아키텍처 다이어그램
1. 기초층
사하라 AI의 기초층은 다음과 같이 나뉘어집니다: 1. 체인 상의 계층은 AI 자산 등록 및 실현을 위해 사용되며, 2. 체인 하의 계층은 에이전트 및 AI 서비스를 실행하는 데 사용됩니다. 체인 상 및 체인 하 시스템이 협력하여 AI 자산의 등록, 권익 보장, 실행 및 수익 분배를 담당하며 전체 AI 라이프사이클의 신뢰 가능한 협업을 지원합니다.
사하라 블록체인 및 SIWA 테스트넷 (체인 상 인프라)
SIWA 테스트넷은 사하라 블록체인의 첫 번째 공개 버전입니다. 사하라 블록체인 프로토콜(SBP)은 사하라 블록체인의 핵심으로, AI를 위해 특별히 설계된 스마트 계약 시스템으로, AI 자산의 체인 상 소유권, 추적 레코드 및 수익 분배를 구현합니다. 핵심 모듈에는 자산 등록 시스템, 소유권 계약, 기여 추적, 권한 관리, 수익 분배, 실행 증명 등이 포함되어 있으며, AI를 위한 "체인 상 운영 체제"를 구축합니다.
AI 실행 프로토콜 (체인 하 인프라)
모델 실행과 호출의 신뢰성을 지원하기 위해, 사하라는 체인 하의 AI 실행 프로토콜 체계를 구축하여 신뢰할 수 있는 실행 환경(TEE)과 결합하여, 에이전트 생성, 배포, 실행 및 협력 개발을 지원합니다. 각 작업 실행은 검증 가능한 레코드를 자동으로 생성하여 체인 상에 업로드하며, 전 과정의 추적과 검증을 보장합니다. 체인 상 시스템은 등록, 승인 및 소유권 레코드를 담당하고, 체인 하 AI 실행 프로토콜은 AI 에이전트의 실시간 실행과 서비스 상호 작용을 지원합니다. 사하라는 크로스체인 호환성을 갖고 있으므로, 사하라 AI를 기반으로 하는 인프라로 구축된 응용 프로그램은 어떤 체인 상이든지 심지어 체인 하에 배포될 수 있습니다.
2. 응용층
사하라 AI 데이터 서비스 플랫폼 (DSP)
데이터 서비스 플랫폼(DSP)은 사하라 응용층의 기본 모듈로, 누구나 Sahara ID를 통해 데이터 작업을 수락하고 데이터 주석, 노이즈 제거 및 심사에 참여할 수 있으며, 기여 증거로써 체인 상 포인트(Sahara Points)를 획득할 수 있습니다. 이 메커니즘은 데이터 근원과 권리를 보장하면서 "기여 - 보상 - 모델 최적화"를 촉진합니다. 현재 제4분기 활동이 진행 중이며, 일반 사용자가 참여하는 주요 방법입니다.
이를 바탕으로 사용자가 고품질 데이터와 서비스를 제출하도록 유도하기 위해 이중 인센티브 메커니즘을 소개함으로써, Sahara가 제공하는 보상뿐만 아니라 생태 파트너로부터 추가적인 보상을 받아 한 번의 기여로 다방면으로 혜택을 받을 수 있습니다. 데이터 공헌자를 예로 들면, 해당 데이터가 모델에 반복적으로 호출되거나 새로운 애플리케이션 생성에 사용될 경우 지속적인 수익을 얻을 수 있어 실제 AI 가치 사슬에 참여하게 됩니다. 이 메커니즘은 데이터 자산의 수명을 연장시키는 뿐만 아니라 협력과 공동구축에 강력한 에너지를 주입하며, 예를 들어 BNB Chain의 MyShell은 DSP 크라우드소싱을 통해 맞춤 데이터 세트를 생성하여 모델 성능을 향상시키며, 사용자는 MyShell 토큰 인센티브를 받아 상호 이익을 창출하는 폐쇄된 생태계를 형성합니다.
AI 기업은 데이터 서비스 플랫폼을 기반으로 클라우드소싱 데이터 세트를 등록할 수 있으며, 전 세계의 데이터 주석가들로부터 빠르게 회신을 받을 수 있도록 특정 데이터 작업을 게시함으로써 전통적인 중앙 집중식 데이터 공급 업체에 더 이상 의존하지 않고 고품질 주석 데이터를 대규모로 확보할 수 있습니다.
Sahara AI 개발자 플랫폼
Sahara AI Developer Platform은 개발자와 기업을 대상으로 하는 올인원 AI 구축 및 운영 플랫폼으로, 데이터 획득부터 모델 훈련, 배포 실행 및 자산 활용화까지의 전 과정을 지원합니다. 사용자는 Sahara DSP의 고품질 데이터 자원을 직접 호출하여 모델 훈련과 미세 조정에 사용할 수 있으며, 완료된 모델은 플랫폼 내에서 조합, 등록하고 AI 마켓플레이스에 상장하여 Sahara 블록체인을 통해 자산 소유권을 확립하고 유연한 라이선스를 부여할 수 있습니다.
스튜디오는 또한 탈중앙화된 컴퓨팅 능력을 통합하여 모델 훈련 및 에이전트 배포 실행을 지원하여 계산 과정의 안전성과 검증 가능성을 보장합니다. 개발자는 중요 데이터와 모델을 저장하고 암호화 호스팅 및 권한 제어를 수행하여 무단 액세스를 방지할 수 있습니다. Sahara AI 개발자 플랫폼을 통해, 개발자는 인프라를 직접 구축할 필요 없이 보다 저비용으로 AI 애플리케이션을 구축, 배포 및 상업화할 수 있으며 프로토콜 메커니즘을 통해 블록체인 기반 AI 경제 생태계에 완전히 통합할 수 있습니다.
AI Marketplace
Sahara AI Marketplace는 모델, 데이터 세트 및 AI 에이전트를 대상으로 하는 탈중앙화 자산 시장입니다. 이는 자산의 등록, 거래 및 라이선스 부여를 지원할 뿐만 아니라 투명하고 추적 가능한 수익 분배 메커니즘을 구축했습니다. 개발자는 자체 개발한 모델이나 수집한 데이터 세트를 온체인 자산으로 등록하고 유연한 사용 권한 및 수읽률을 설정할 수 있으며, 시스템은 호출 빈도에 따라 자동으로 수익 분배를 실행합니다. 데이터 공헌자들도 데이터가 반복 호출됨에 따라 지속적으로 수익을 얻을 수 있어 '지속적인 가치 실현'이 가능합니다.
이 시장은 Sahara 블록체인 프로토콜과 깊은 통합을 이루어 모든 자산 거래, 호출, 수수료 분배 기록이 체인 상에서 검증됨으로 자산 소유권의 명확성과 수익 추적이 보장됩니다. 이 시장을 통해 AI 개발자는 더는 전통적인 API 플랫폼이나 중앙 집중식 모델 호스팅 서비스에 의존하지 않고 독립적이고 프로그래밀 된 비즈니스 경로를 보유하게 됩니다.
3. 생태계
Sahara AI의 생태계는 데이터 공급자, AI 개발자, 소비자, 기업 사용자 및 크로스체인 파트너를 연결합니다. 데이터 기여, 애플리케이션 개발, 제품 사용 또는 기업 내 AI화를 촉진하던가 수익 모델을 찾아내는 것이 스승입니다. 데이터 주석 소팀 및 모델 개발팀, 및 계 의 공급자들은 자사의 자원을 체인 상 자산으로 등록하고 Sahara AI 프로토콜 메커니즘을 통해 권한을 부여하고 분배함으로써 모든 자원 사용에 대한 자동 보상을 받게 됩니다. 개발자는 플랫폼을 통해 데이터를 연결하고 모델을 학습하고 에이젼트를 배포하여 AI Marketplace에서 직접적으로 그들의 성과를 상업화할 수 있습니다.
일반 사용자는 기술 배경이 없어도 데이터 작업에 참여하거나 AI 앱을 사용하거나 체인 상 자산을 수집하거나 투자함으로써 AI 경제의 일부가 될 수 있습니다. 기업에게 있어서 Sahara는 데이터 크라우드소싱부터 모델 개발까지 프라이빗 배포 및 수익 실현까지 전과정 지원을 제공합니다. 이 외에도 Sahara는 크로스체인 배포를 지원하며 모든 공개 블록체인 생태계가 Sahara AI가 제공하는 프로토콜 및 도구를 사용하여 AI 애플리케이션을 구축하고 탈중앙화된 AI 자산에 액세스하며 다중체인 세계와의 호환성 및 확장이 가능합니다. 이는 Sahara AI가 단순한 플랫폼이 아니라 오히려 체인 상 AI 생태계의 기본 협업 표준임을 의미합니다.
생태계 진행
프로젝트 시작 이후, Sahara AI는 AI 도구 세트나 컴퓨팅 플랫폼이 아닌 온체인에서 AI의 생산 및 분배 질서를 재구성하고 누구나 참여하고 권리를 갖고 기여하며 공유할 수 있는 탈중앙화된 협업 네트워크로 발전해왔습니다. 이 때문에 Sahara는 블록체인을 밑바탕으로 삼아 AI를 위한 검증 가능하고 추적 가능하며 분배 가능한 경제 체계를 구축하기로 선택했습니다.
이 핵심 목표를 중심으로, Sahara 생태계는 상당한 진전을 이룩했습니다. 현재는 비공개 테스트 단계에 있음에도 불구하고 플랫폼은 320만 개 이상의 온체인 계정을 누적하고 있으며 일일 활성 계정은 140만 명을 넘어가며 사용자 참여도와 네트워크 활동성을 나타냅니다. 이 중 20만 명 이상의 사용자들이 Sahara 데이터 서비스 플랫폼을 통해 데이터 주석, 학습 및 검증 작업에 참여했으며 온체인 보상을 받았습니다. 동시에 여전히 수백만 명의 사용자가 화이트리스트 가입을 기다리며 탈중앙화된 AI 플랫폼에 대한 시장의 강한 수요와 공감을 입증했습니다.
기업 협력 측면에서 Sahara는 이미 Microsoft, Amazon, MIT(Massachusetts Institute of Technology) 등 글로벌 선도 기관과 협력하여 맞춤형 데이터 수집 및 주석 서비스를 제공했습니다. 기업은 플랫폼을 활용하여 구체적인 작업을 제출하고, Sahara의 글로벌 데이터 주석가로 구성된 네트워크가 효율적으로 실행하여 대규모 지능형 외주 작업을 실현하며 실행 효율성, 유연성, 다양성 요구를 지원합니다.
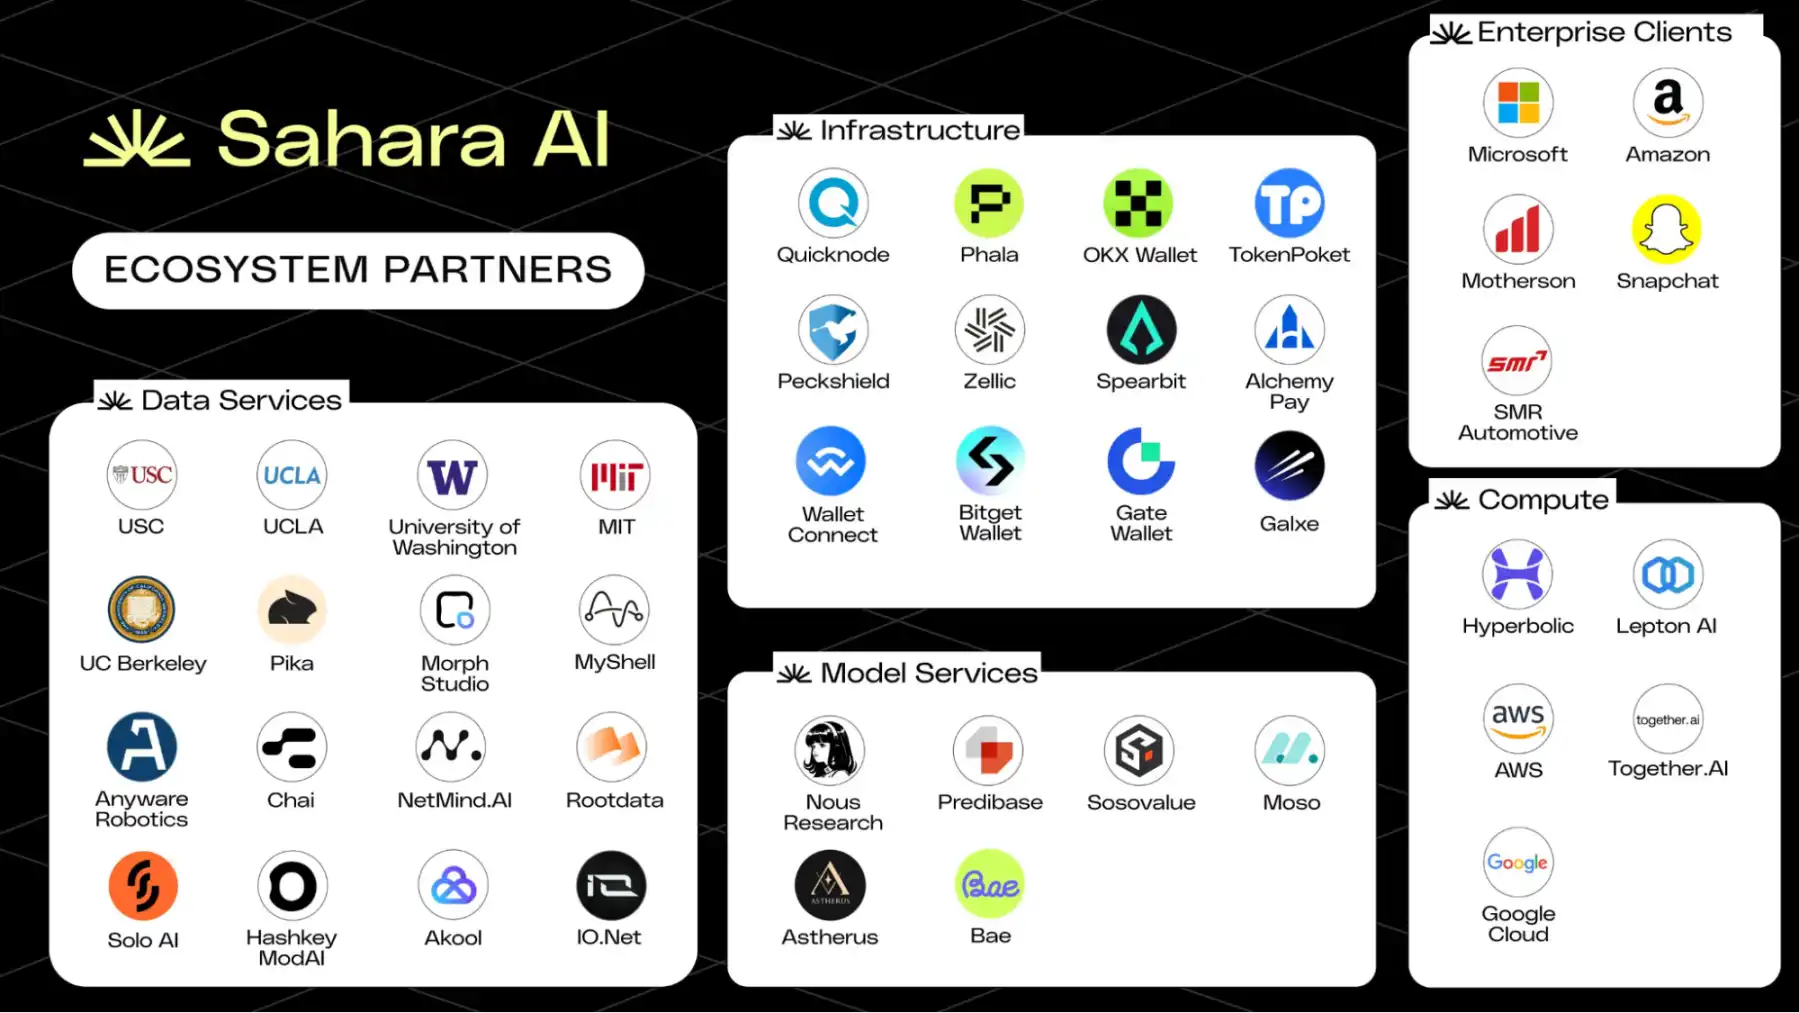
Sahara AI 생태도
참여 방법
SIWA는 네 단계로 출시될 예정입니다. 현재 첫 번째 단계는 온체인 데이터 소유권 구축을 위한 것으로, 공헌자는 자체 데이터 세트를 등록하고 토큰화할 수 있습니다. 현재 외부에 공개되어 있으며 화이트리스트가 필요하지 않습니다. AI에 유용한 데이터를 업로드하고, 카피라이팅 또는 부적절한 콘텐츠를 업로드하지 않도록 주의해야 합니다. 두 번째 단계는 데이터 세트 및 모델의 온체인 유통입니다. 세 번째 단계는 테스트넷 오픈 및 오픈 소스 라이선스입니다. 네 번째 단계는 AI 데이터 흐름 등록, 원천 추적 및 공헌 증명 메커니즘을 출시할 예정입니다.
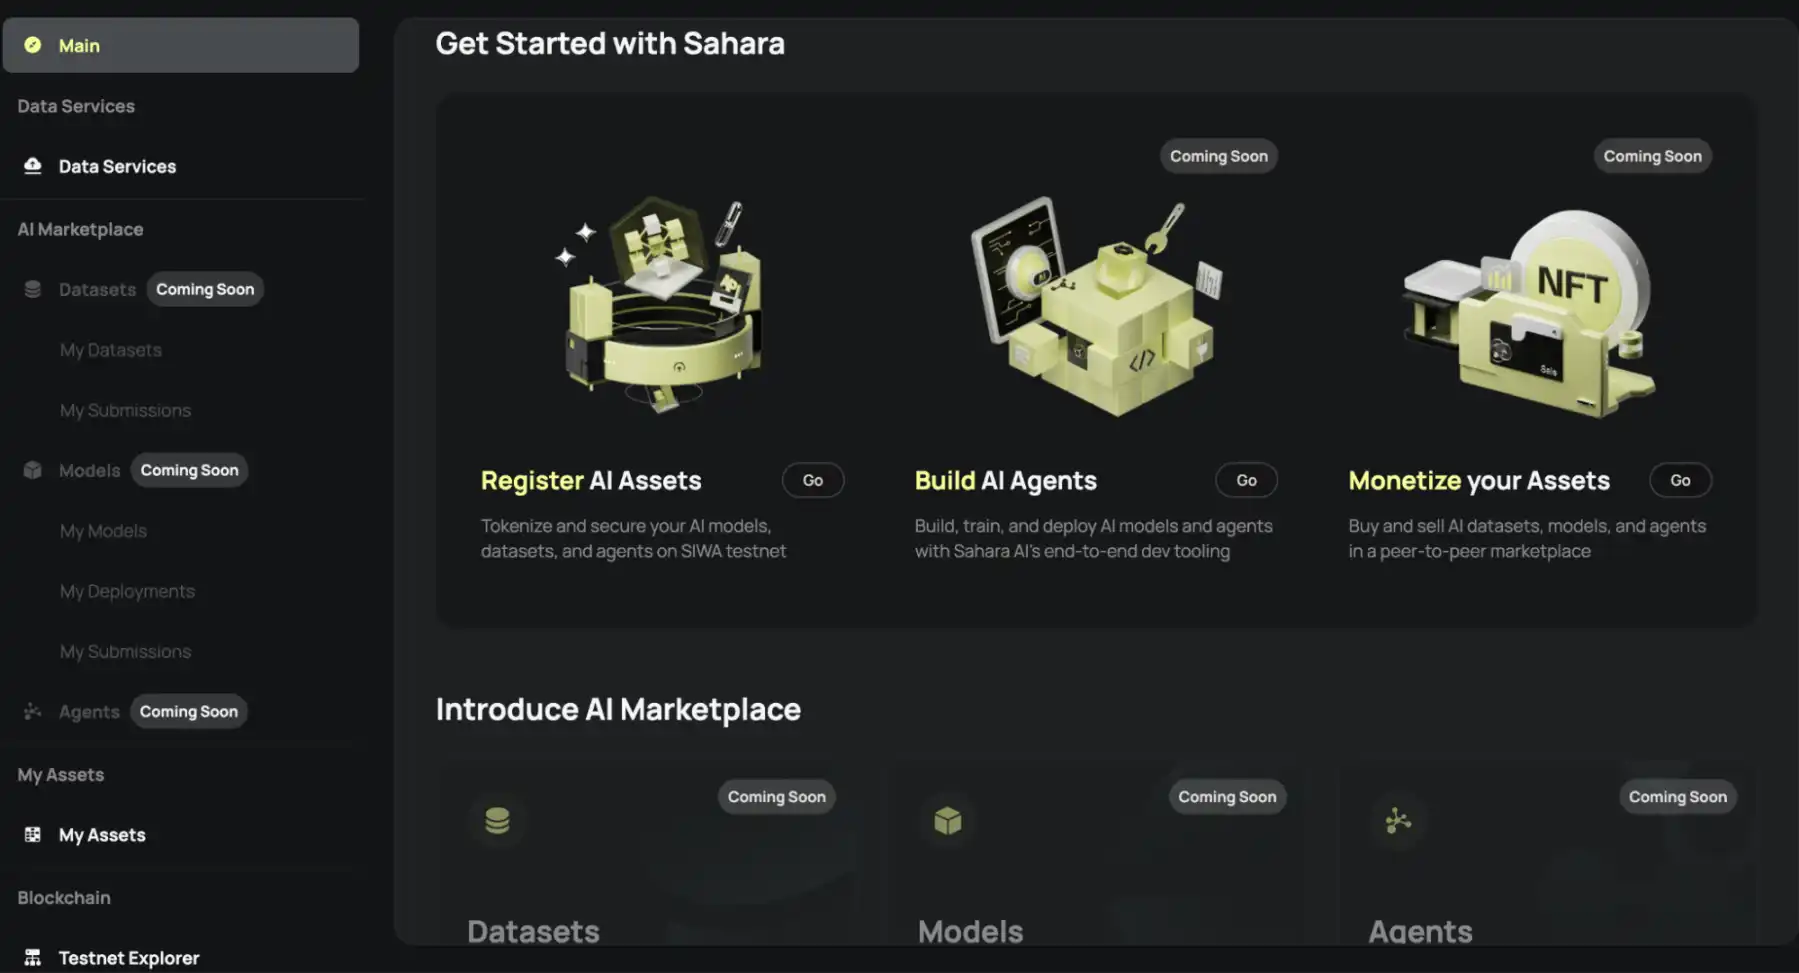
SIWA 테스트넷
SIWA 테스트넷 외에도 현재 일반 사용자는 Sahara Legends에 참여할 수 있으며, 게임화된 작업을 통해 Sahara AI의 기능을 이해할 수 있습니다. 작업을 완료하면 수호자 조각을 획들할 수 있으며,이를 통해 네트워크에 대한 공헌을 기록하는 NFT를 생성할 수 있습니다.
또는 데이터 서비스 플랫폼에서 데이터를 주석 처리하고 가치 있는 데이터를 제공하며 리뷰어 역할을 맡을 수도 있습니다. Sahara는 이후 이메일로 협력할 파트너사와 함께 작업을 출시하고, 참여자가 Sahara 포인트뿐만 아니라 생태계 파트너사의 인센티브를 받을 수 있도록 할 계획입니다. 첫 번째 이중 보상 작업은 Myshell과 함께 진행되며, 사용자가 작업을 완료하면 Sahara 포인트 및 Myshell 토큰 보상을 받을 수 있습니다. 로드맵에 따르면, Sahara는 2025년 제3분기에 메인넷을 출시할 예정이며, 그때 TGE도 기대할 수 있습니다.
도전과 전망
Sahara AI는 AI를 개발자 또는 대규모 AI 기업에만 제한하지 않고, AI를 보다 개방적이고 포용적이며 민주화된 것으로 만들었습니다. 일반 사용자에게는 프로그래밍 지식이 필요하지 않고 공헌하고 수익을 얻을 수 있으며, Sahara AI가 만들어낸 것은 누구나 참여할 수 있는 탈중앙화 AI 세계입니다. 기술 개발자에게는 Sahara AI가 Web2와 Web3 개발 경로를 연결하고, 탈중앙화되었지만 유연하고 강력한 개발 도구 및 고품질 데이터 세트를 제공했습니다.
AI 인프라 제공 업체인 Sahara AI는 모델, 데이터, 계산 능력 및 서비스에 대한 탈중앙화된 가치 실현 경로를 제공합니다. Sahara AI는 공개 체인 인프라뿐만 아니라 핵심 애플리케이션을 다루며, 블록체인 기술을 활용하여 AI 저작권 시스템을 발전시킵니다. 현재 Sahara AI는 여러 최고의 AI 기관과 협력하여 초기 성공을 거두었습니다. 앞으로의 성공 여부는 메인넷 출시 후의 성능, 생태계 제품 발전과 채택률, 그리고 TGE 이후 경제 모델이 사용자들을 계속해서 데이터 세트에 기여하도록 이끌 수 있는지에 달려있습니다.
Ritual: 이질적인 작업 등 AI 핵심 과제를 돌파하는 혁신적인 디자인
프로젝트 개요
Ritual은 현재의 AI 산업에서의 중앙화, 폐쇄성 및 신뢰 문제를 해결하고 AI에게 투명한 인증 메커니즘, 공정한 계산 자원 할당, 그리고 유연한 모델 적응 능력을 제공하여 모든 프로토콜, 애플리케이션 또는 스마트 계약이 몇 줄의 코드로 검증 가능한 AI 모델을 통합할 수 있도록 합니다. 또한 열린 아키텍처와 모듈화된 디자인을 통해 AI의 체인 상의 광범위한 응용을 촉진하여 열린, 안전하고 지속 가능한 AI 생태계를 구축합니다.
Ritual은 2023년 11월에 Archetype를 리드 투자자로 2500만 달러의 A 시리즈 자금 조달을 완료했으며 Accomplise 등 여러 기관 및 알려진 천사 투자자들이 참여하여 시장의 인정과 팀의 강력한 소셜 능력을 보여주었습니다. 설립자 Niraj Pant와 Akilesh Potti는 모두 이전 Polychain Capital 파트너로 Offchain Labs, EigenLayer 등 주요 기업에 투자를 주도한 경험을 바탕으로 심층적인 통찰과 판단력을 나타냅니다. 팀은 암호학, 분산 시스템, AI 등 다양한 분야에서 경험이 풍부하며 NEAR와 EigenLayer 등 프로젝트 설립자를 포함한 고문진이 강조하는 강력한 배경과 잠재력을 보여줍니다.
디자인 아키텍처
Infernet에서 Ritual Chain으로
Ritual Chain은 Infernet 노드 네트워크에서 자연스럽게 진화한 제2 세대 제품으로, Ritual이 탈중앙화된 AI 계산 네트워크에서의 포괄적인 업그레이드를 대표합니다. Infernet은 2023년에 공식적으로 출시된 Ritual의 첫 단계 제품입니다. 이것은 이질적인 계산 작업을 위해 설계된 탈중앙화된 옵러클 네트워크로, 중앙화된 API의 한계를 해결하여 개발자가 투명하고 개방적인 탈중앙화된 AI 서비스에 더 자유롭고 안정적으로 액세스할 수 있도록 합니다.
Infernet은 유연하고 간단한 경량 프레임워크를 채택했으며, 사용하기 쉽고 효율적이기 때문에 출시 후 빠르게 8,000개 이상의 독립적인 노드가 참여했습니다. 이러한 노드는 GPU 및 FPGA를 포함한 다양한 하드웨어 능력을 갖추었으며, AI 추론 및 제로 지식 증명 생성과 같은 복잡한 작업에 강력한 계산 능력을 제공할 수 있습니다. 그러나 시스템의 간결성을 유지하기 위해 Infernet은 공정 조정 노드 또는 견고한 작업 라우팅 메커니즘의 통합과 같이 일부 핵심 기능을 포기했습니다. 이러한 제한으로 인해 Infernet은 보다 폭넓은 Web2 및 Web3 개발자의 요구를 충족하기 어려워지며, 이는 Ritual이 더 포괄적이고 강력한 Ritual Chain을 출시하도록 이끌었습니다.
Ritual Chain은 AI 애플리케이션을 위해 고안된 차세대 Layer 1 블록체인으로, Infernet의 한계를 극복하고 개발자에게 보다 견고하고 효율적인 개발 환경을 제공하기 위해 설계되었습니다. Resonance 기술을 통해 Ritual Chain은 Infernet 네트워크에 대한 간결하고 신뢰할 수 있는 가격 책정 및 작업 라우팅 메커니즘을 제공하여 자원 할당 효율성을 크게 향상시켰습니다. 게다가 Ritual Chain은 EVM++ 프레임워크를 기반으로 하여, Ethereum 가상 머신(EVM)의 후행 호환성 확장으로 보다 강력한 기능을 갖추었습니다. 이는 프리컴파일 모듈, 네이티브 스케줄링, 내장된 계정 추상화(Account Abstraction, AA) 및 일련의 고급 Ethereum 개선 제안서(EIP)를 포함하고 있습니다. 이러한 기능들은 협력하여 개발자들에게 새로운 가능성을 제시하는 강력하고 유연하며 효율적인 개발 환경을 구축했습니다.
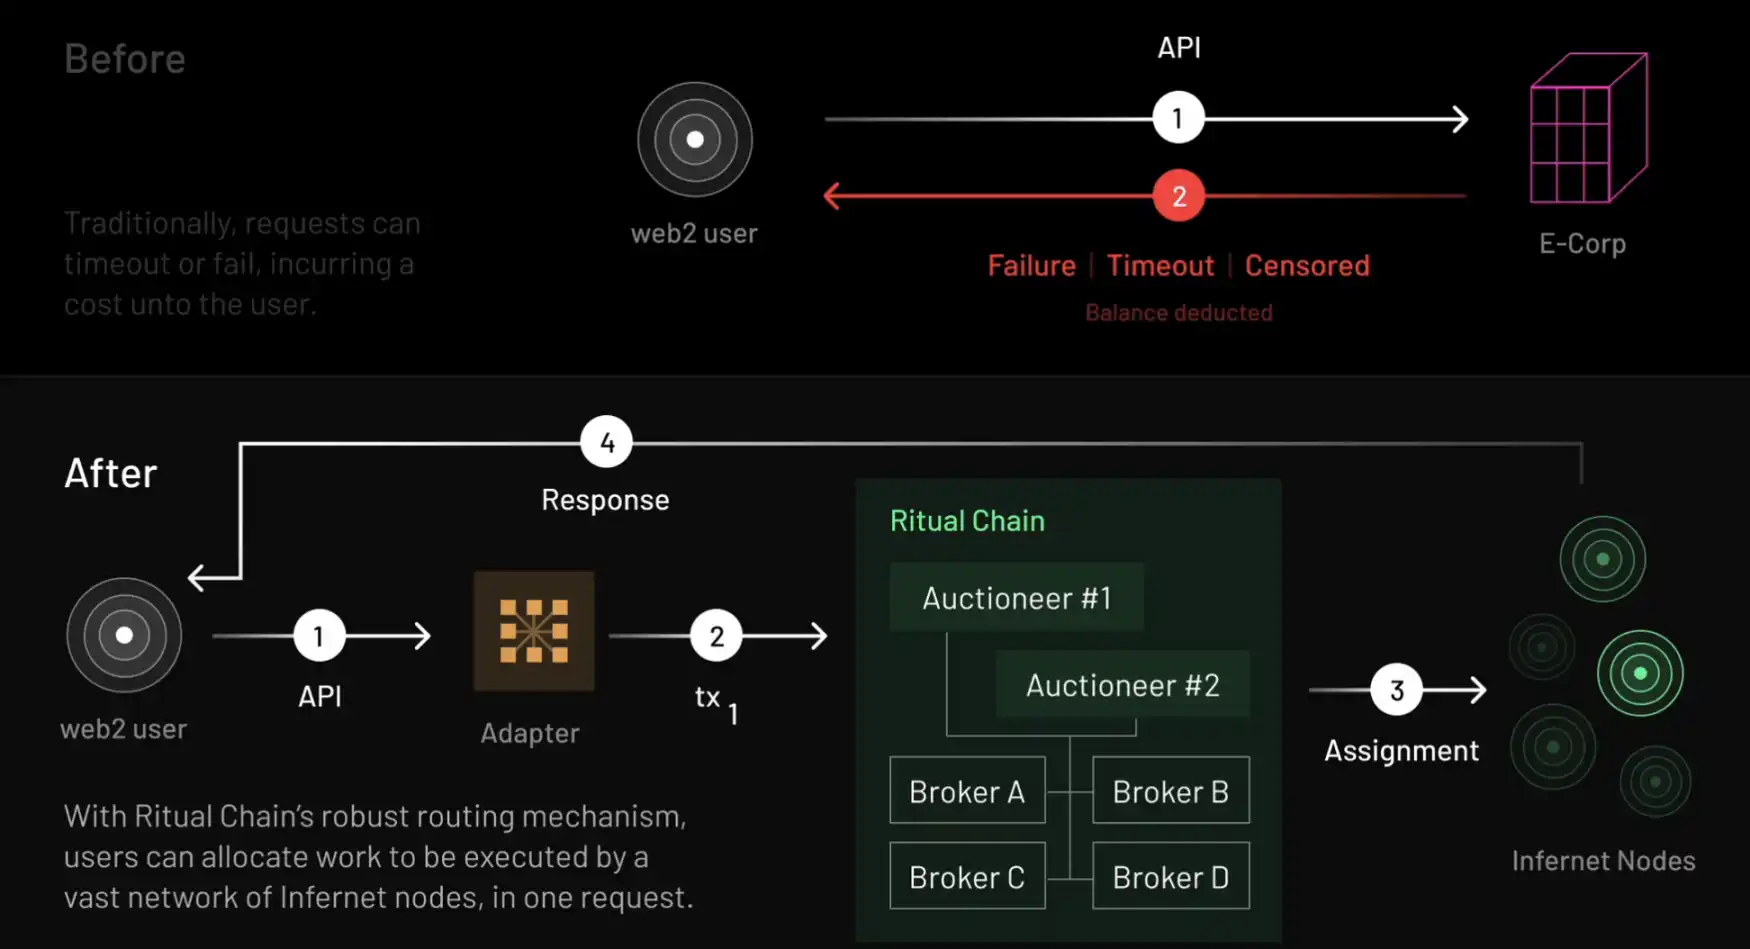
Ritual Chain 작업 흐름도
프리컴파일 Sidecars
전통적인 프리컴파일과 비교하여, Ritual Chain의 설계는 시스템의 확장성과 유연성을 향상시켰으며, 개발자들이 기본 프로토콜을 수정하지 않고도 컨테이너화 방식으로 사용자 정의 기능 모듈을 생성할 수 있습니다. 이러한 아키텍처는 개발 비용을 크게 낮추어주었을 뿐만 아니라 탈중앙화 애플리케이션에 더 강력한 계산 능력을 제공했습니다.
특히 Ritual Chain은 모듈화 아키텍처를 통해 복잡한 계산을 실행 클라이언트에서 분리시키고 독립적인 Sidecars 형태로 구현합니다. 이러한 프리컴파일 모듈은 AI 추론, 제로 지식 증명 생성 및 신뢰할 수 있는 실행 환경(TEE) 작업을 포함한 복잡한 계산 작업을 효율적으로 처리할 수 있습니다.
네이티브 스케줄링
네이티브 스케줄링은 작업의 타이밍 트리거와 조건 실행 요구사항을 해결합니다. 전통적인 블록체인은 보통 Keeper와 같은 중앙화된 타사 서비스에 의존하여 작업 실행을 트리거하지만, 이러한 방식은 중앙화된 위험과 높은 비용을 내포하고 있습니다. Ritual Chain은 내장된 스케줄러를 통해 중앙화된 서비스 의존성을 완전히 제거했으며, 개발자는 체인 상에서 스마트 계약의 진입점과 콜백 주기(callback frequency)를 직접 설정할 수 있습니다. 블록 생성자는 보류 중인 호출에 대한 매핑 테이블을 유지하며, 이러한 작업을 우선적으로 처리합니다. Resonance의 자원 동적 할당 메커니즘과 결합하여 Ritual Chain은 계산 집약적 작업을 효율적이고 신뢰성 있게 처리할 수 있으며, 분산형 AI 애플리케이션에 안정성을 제공합니다.
기술 혁신
Ritual의 핵심 기술 혁신은 성능, 검증 및 확장성 측면에서 선도적인 위치를 보장하며, 체인 상 AI 애플리케이션에 강력한 지원을 제공합니다.
1. Resonance: 자원 할당 최적화
Resonance은 블록체인 자원 할당을 최적화하는 양방향 시장 메커니즘으로, 이질적 거래의 복잡성을 해결합니다. 블록체인 거래가 간단한 송금에서 스마트 계약, AI 추론 등 다양한 형태로 진화함에 따라 기존의 수수료 메커니즘(EIP-1559와 같은)은 사용자 요구와 노드 자원 간의 효율적인 매칭에 어려움을 겪고 있습니다. Resonance은 Broker와 Auctioneer 두 가지 핵심 역할을 도입하여 사용자 거래와 노드 능력 간의 최적의 매칭을 달성합니다:
Broker는 사용자 거래의 수수료 의지와 노드 자원 비용 함수를 분석하여 거래와 노드 간 최적의 매칭을 실현하고, 계산 자원의 활용률을 향상시킵니다. Auctioneer는 이중 경매 메커니즘을 통해 거래 수수료 분배를 조직화하여 공정성과 투명성을 보장합니다. 노드는 자신의 하드웨어 능력에 따라 거래 유형을 선택하고, 사용자는 우선 조건(속도 또는 비용 등)에 따라 거래 요청을 제출할 수 있습니다.
이러한 메커니즘은 네트워크의 자원 활용 효율성과 사용자 경험을 크게 향상시키며, 분산 경매 프로세스를 통해 시스템의 투명성과 개방성을 더욱 강화합니다.
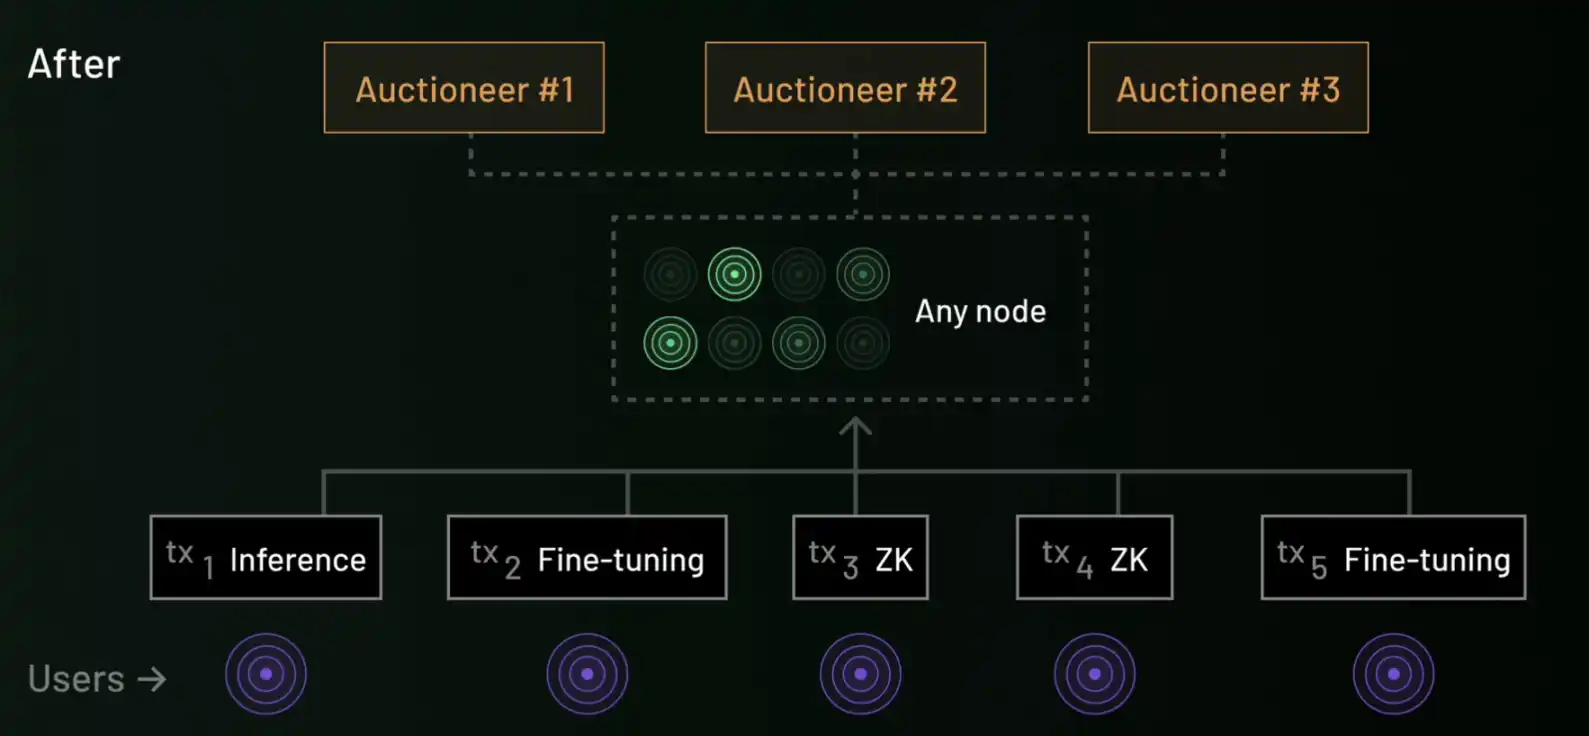
Resonance 메커니즘 하에서: Auctioneer는 Broker 분석에 따라 적절한 작업을 노드에 할당합니다
2. 심포니: 검증 효율 향상
심포니는 검증 효율을 향상시키는 데 초점을 맞추며, 전통적인 블록체인의 "반복 실행" 모드가 복잡한 계산 작업을 처리하고 검증할 때 발생하는 효율성 문제를 해결합니다. 심포니는 "한 번 실행, 여러 번 검증" (EOVMT) 모델에 기반을 두고 있으며, 계산과 검증 프로세스를 분리함으로써 반복 계산으로 인한 성능 상의 손실을 크게 줄입니다. 계산 작업은 특정 노드에서 한 번 실행되고, 계산 결과가 네트워크로 전파되며, 검증 노드는 상호작용 없는 증명 (간결한 증명)을 사용하여 결과의 정확성을 확인하며, 계산을 반복 실행할 필요가 없습니다.
심포니는 분산 검증을 지원하며, 복잡한 작업을 여러 하위 작업으로 분해하여 서로 다른 검증 노드가 병렬로 처리하므로 검증 효율을 더욱 향상시키고, 개인 정보 보호 및 보안을 보장합니다. 심포니는 신뢰할 수 있는 실행 환경 (TEE) 및 제로 지식 증명 (ZKP)과 같은 증명 시스템과 매우 호환되며, 거래 신속 확인 및 개인 정보 보호에 민감한 계산 작업에 대해 유연한 지원을 제공합니다. 이러한 아키텍처는 반복 계산으로 인한 성능 부담을 크게 줄일 뿐만 아니라 검증 프로세스의 탈중앙화와 보안성을 보장합니다.
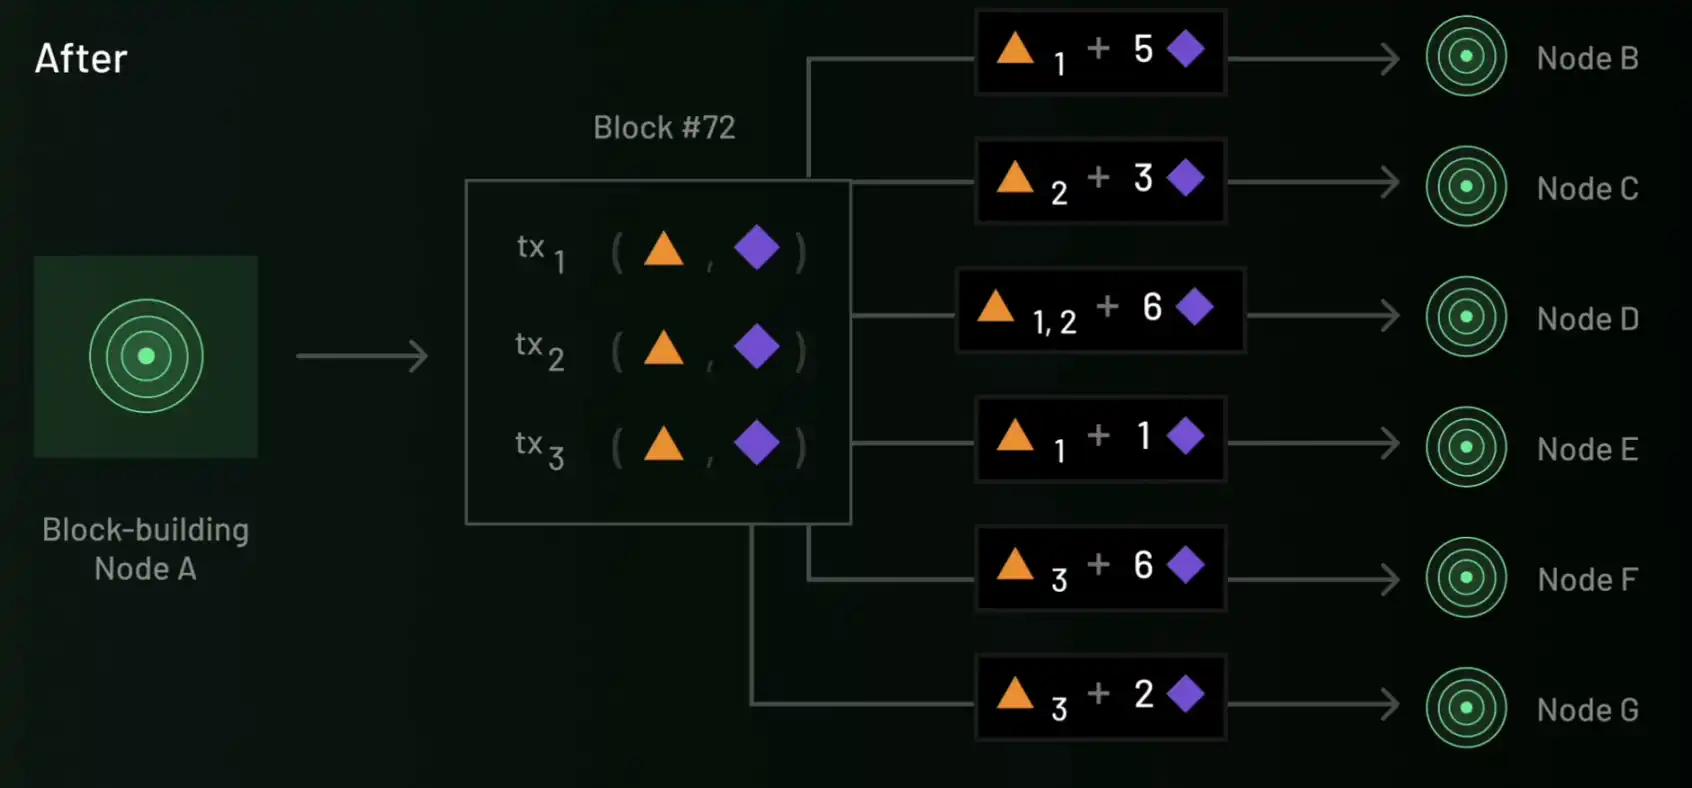
심포니는 복잡한 작업을 여러 하위 작업으로 분해하여 서로 다른 검증 노드가 병렬로 처리합니다
3. vTune: 추적 가능한 모델 검증
vTune은 Ritual이 제공하는 모델 검증 및 출처 추적을 위한 도구로, 모델 성능에 거의 영향을 미치지 않으면서 강력한 방해 방지 기능을 갖추고 있어, 오픈 소스 모델의 지적 재산권을 보호하고 공정한 배포를 촉진하는 데 특히 유용합니다. vTune은 워터마크 기술과 제로 지식 증명을 결합하여 모델 출처 추적 및 계산 무결성 보호를 위해 은밀한 표시를 임베드하여:
· 워터마크 기술: 가중치 공간 워터마크, 데이터 워터마크 또는 함수 공간 워터마크를 포함하여 표시를 임베드하며, 모델이 공개되어도 소유자를 확인할 수 있습니다. 특히 함수 공간 워터마크는 모델 가중치에 액세스할 필요 없이 모델 출력을 통해 소유권을 검증하여 보다 강력한 개인 정보 보호와 탄력성을 실현합니다.
· 제로 지식 증명: 모델 미세 조정 과정에서 은밀한 데이터를 도입하여 모델 변조 여부를 확인하고, 동시에 모델 소유자의 이익을 보호합니다.
이 도구는 탈중앙화된 AI 모델 시장에 신뢰할 수 있는 출처 검증을 제공할 뿐만 아니라 모델의 보안성과 생태계 투명성을 크게 향상시킵니다.
생태계 발전
Ritual은 현재 비공개 테스트넷 단계에 있어 일반 사용자가 참여할 기회가 제한적입니다. 그러나 개발자는 공식으로 발표된 Altar 및 Realm 인센티브 프로그램에 신청하여 Ritual의 AI 생태계 구축에 참여하고, 공식의 풀 스택 기술 지원 및 자금 지원을 받을 수 있습니다.
현재 공식으로 발표된 Altar 프로그램에서 비롯된 일부 네이티브 애플리케이션을 소개합니다:
· Relic: 머신러닝 기반 자동 예금 제공자 (AMM)로, Ritual의 인프라를 통해 유동성 풀 매개변수를 동적으로 조정하여 수수료 및 기본 풀을 최적화합니다;
· Anima: LLM 기반의 온체인 거래 자동화 도구에 중점을 둠으로써 사용자에게 웹3 상호작용 경험을 제공합니다;
· Tithe: AI 기반의 대출 프로토콜로, 대출 풀과 신용 등급을 동적으로 최적화하여 보다 다양한 자산 유형을 지원합니다.
뿐만 아니라, Ritual은 여러 성숙한 프로젝트들과 풍부한 협력을 통해 분산형 AI 생태계를 발전시키고 있습니다. 예를 들어 Arweave와의 협력을 통해 모델, 데이터 및 제로지식 증명에 대한 분산형 영구 저장 지원을 제공하고 있으며, StarkWare 및 Arbitrum과의 통합을 통해 Ritual은 이러한 생태계에 원천적인 온체인 AI 기능을 도입하고 있습니다. 또한 EigenLayer가 제공하는 재스테이킹 메커니즘은 Ritual의 프루핑 마켓에 능동적인 검증 서비스를 추가하여 네트워크의 분산화와 보안성을 더욱 강화하였습니다.
도전과 전망
Ritual의 설계는 할당, 인센티브, 검증 등 핵심 환경부터 출발하여 분산형 AI가 직면한 핵심 문제를 해결함으로써 모델의 검증 가능성을 달성했으며, vTune과 같은 도구를 통해 모델의 검증 가능성을 실현함으로써 모델 오픈 소스와 인센티브의 모순을 극복하였습니다. 이는 분산형 모델 마켓의 구축에 기술적 지원을 제공했습니다.
현재 Ritual은 초기 단계에 있으며, 주로 모델 추론 단계에 초점을 맞추고 있으며, 제품 매트릭스는 인프라에서 모델 마켓, L2 서비스 (L2aaS), 에이전트 프레임워크 등으로 확장 중입니다. 현재 블록체인이 여전히 비공개 테스트 단계에 있기 때문에 Ritual이 제시한 고급 기술 설계 솔루션은 대규모 공개적으로 시행되기를 기다려야 할 필요가 있으며, 이에 대한 지속적인 주목이 필요합니다. 기술이 지속적으로 완성되고 생태계가 점차 더욱 풍부해질수록 Ritual이 분산형 AI 인프라의 중요한 구성 요소가 될 것으로 기대됩니다.
Gensyn: 탈중앙화 모델 훈련의 핵심 문제 해결
프로젝트 개요
인공지능의 급속한 발전과 계산 리소스의 점차적인 부족으로, Gensyn은 전체 AI 모델 훈련의 기본 패러다임을 재구성하려고 합니다.
전통적인 AI 모델 훈련 과정에서 계산 리소스는 사실상 소수의 클라우드 컴퓨팅 거물들에게 독점당하고 있으며, 훈련 비용이 높고 투명성이 낮아 중소 규모 팀 및 독립 연구자의 혁신 속도를 저해하고 있습니다. Gensyn의 비전은 이러한 '중앙화 독점' 구조를 파괴하고, 전 세계의 기본적인 계산 능력을 갖춘 장치로 훈련 작업을 '하향 이식'하는 것입니다 - MacBook, 게임용 GPU, 가장한 시스템, 미사용 서버 등 네트워크에 연결하여 작업 실행에 참여하고 보상을 받는 것이 가능합니다.
Gensyn은 2020년에 설립되어 탈중앙화 AI 컴퓨팅 인프라를 구축하는 데 초점을 맞추었습니다. 2022년에는 기술 및 제도 측면에서 AI 모델 훈련 방식을 재정의하기를 처음으로 제안했습니다: 더 이상 폐쇄된 클라우드 플랫폼이나 거대한 서버 클러스터에 의존하는 것이 아니라, 훈련 작업을 전 세계의 이질적인 계산 노드로 하향 이식하여 신뢰할 수 없는 지능형 계산 네트워크를 구축합니다.
2023년, Gensyn은 그 비전을 더 확장하여, 글로벌 연결, 오픈 소스의 자율적이고 허가 없는 AI 네트워크를 구축하기로 결정했습니다 - 기본적인 계산 능력을 갖춘 모든 장치가 이 네트워크의 일부가 될 수 있습니다. 그 기본 프로토콜은 블록체인 아키텍처에 기반을 둔데, 이는 인센티브 및 검증 메커니즘을 가질 수 있습니다.
Gensyn은 설립 이후 총 50.6백만 달러의 지원을 받았으며, 투자자로는 a16z, CoinFund, Canonical, Protocol Labs, Distributed Global 등 총 17개 기관이 포함되어 있습니다. 특히, 2023년 6월 a16z가 선두로 이끈 시리즈 A 투자는 탈중앙화 AI 분야가 주류 Web3 벤처 투자의 시야에 들어갔음을 나타내며 주목을 받았습니다.
팀의 주요 구성원들은 각각 충분한 무게를 가지고 있습니다: 공동 창립자인 벤 필딩은 옥스포드 대학에서 이론 컴퓨터 과학을 전공했으며, 깊은 기술 연구 배경을 가지고 있습니다; 또 다른 공동 창립자 해리 그리브는 오랜 기간 탈중앙화 프로토콜의 시스템 디자인 및 경제 모델링에 참여해 Gensyn의 아키텍처 설계와 인센티브 메커니즘을 단단히 지지했습니다.
디자인 아키텍처
현재 분산 인공 지능 시스템의 발전은 실행 (Execution), 검증 (Verification) 및 통신 (Communication) 세 가지 핵심 기술적 제약에 직면하고 있습니다. 이러한 제약은 대형 모델 훈련 능력의 제한뿐만 아니라 전 세계의 컴퓨팅 리소스의 공정한 통합과 효율적 활용을 제약하고 있습니다. Gensyn 팀은 체계적인 연구를 기반으로, RL Swarm, Verde 및 SkipPipe 세 가지 대표적인 혁신 메커니즘을 제안하여 위 문제에 대한 각각의 해결 경로를 구축하고 분산 인공 지능 인프라가 개념에서 현실로 나아가도록 추진했습니다.
1. 실행 도전: 파편화된 장치가 대형 모델을 효율적으로 훈련할 수 있도록 하는 방법은 무엇인가요?
현재 대형 언어 모델의 성능 향상은 주로 "스케일 쌓기" 전략에 의존합니다: 더 많은 매개 변수, 더 넓은 데이터 세트 및 더 긴 훈련 주기. 그러나 이로 인해 계산 비용이 크게 증가했습니다 - 거대한 모델의 훈련은 종종 수천 개의 GPU 노드로 분할되어야 하며, 이러한 노드들 사이에는 빈도가 높은 데이터 통신 및 그래디언트 동기화가 필요합니다. 비중앙화 시나리오에서, 노드는 지리적으로 분산되어 있고 하드웨어가 이질적이며 상태가 불안정하기 때문에 전통적인 중앙 집중식 스케줄링 전략은 효과적으로 작동하지 않습니다.
이러한 도전에 대응하기 위해 Gensyn은 RL Swarm을 제안했습니다. RL Swarm은 포인트 투 포인트 강화 학습 후 훈련 시스템으로, 훈련 프로세스를 분산 협업 게임으로 변환하는 핵심 아이디어입니다. 이 메커니즘은 "공유 - 비판 - 결정" 세 단계로 구성됩니다: 먼저, 노드는 문제 추론을 독립적으로 수행하고 결과를 공개적으로 공유합니다. 다음으로, 각 노드는 동료의 답변을 평가하고 논리성 및 전략적 타당성 등 면에서 피드백을 제공합니다. 마지막으로, 노드는 집단 의견에 기반하여 자체 출력을 수정하고 더 견고한 답변을 생성합니다. 이 메커니즘은 개별 계산과 집단 협업을 효과적으로 융합하며, 특히 수학 및 논리 추론과 같이 고정밀도 및 검증 가능성이 요구되는 작업에 적합합니다. 실험 결과, RL Swarm은 효율성을 향상시키는데 그치지 않고 참여 장벽을 크게 낮추고, 좋은 확장성과 내결함성을 갖추고 있습니다.
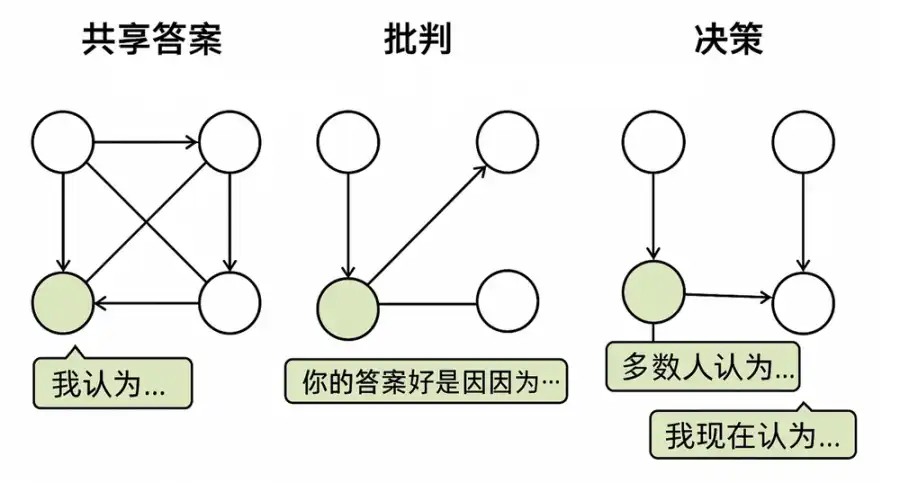
RL Swarm의 "공유 - 비판 - 결정" 세 단계 강화 학습 훈련 시스템
2. 검증 도전: 믿을 수 없는 공급 업체의 계산 결과를 어떻게 확인할 수 있나요?
비중앙화 훈련 네트워크에서 "누구나가 컴퓨팅 리소스를 제공할 수 있다"는 것은 장점일 수도 있지만 위험도 일 수 있습니다. 문제는 다음과 같습니다: 신뢰할 필요 없이 이러한 계산이 실제로 유효한지 어떻게 확인할 수 있습니까?
재계산 또는 화이트리스트 심사와 같은 전통적 방식은 명백한 제한이 있습니다 - 전자는 매우 높은 비용이 들며 확장성이 떨어집니다. 후자는 "롱테일" 노드를 배제하여 네트워크의 개방성을 훼손합니다. Gensyn은 이에 대응하여 신경망 훈련 검증 시나리오에 특화된 경량화된 중재 프로토콜인 Verde를 설계했습니다.
Verde의 핵심 아이디어는 "최소 신뢰 결정"입니다. 검증자가 공급업체의 훈련 결과에 문제가 있다고 의심할 때, 중재 계약은 분쟁이 있는 첫 번째 작업 노드에서 계산을 다시 수행하면서 전체 훈련 과정을 다시 실행할 필요가 없습니다. 이는 검증 부담을 크게 줄이면서 적어도 한 쪽이 성실할 때 결과의 정확성을 보장합니다. 서로 다른 하드웨어 간 부동 소수점 비결정성 문제를 해결하기 위해 Verde는 Reproducible Operators(재현 가능한 연산자 라이브러리)를 개발했습니다. 이 라이브러리는 행렬 곱셈과 같은 일반적인 수학 연산에 대해 일관된 실행 순서를 설정하여 장치 간 비트 수준의 일관된 출력을 실현합니다. 이 기술은 분산 훈련의 안전성과 엔지니어링 가능성을 현저히 향상시키며, 현재의 신뢰할 수없는 검증 체계에서 중요한 발전을 이루었습니다.
전체 메커니즘은 훈련자가 중요한 중간 상태(즉, 체크포인트)를 기록하는 것을 기반으로 하며, 여러 검증자가 이러한 훈련 단계를 재현하기 위해 무작위로 할당되어 출력의 일관성을 판단합니다. 한 번 검증자가 훈련자와 다른 의견이 나타나면 시스템은 전체 모델을 강제로 다시 실행하는 대신 네트워크 중재 메커니즘을 사용하여 계산 그래프에서 의견이 분분한 작업을 정확하게 식별하고 해당 작업만 다시 재생성하여 분쟁 처리를 매우 낮은 비용으로 달성합니다. 이 방법을 통해 Verde는 훈련 노드를 신뢰할 필요 없이 훈련 과정의 무결성을 보장하고 효율성과 확장성을 고려하여 분산 AI 훈련 환경에 맞춤화된 검증 프레임워크를 제공합니다.
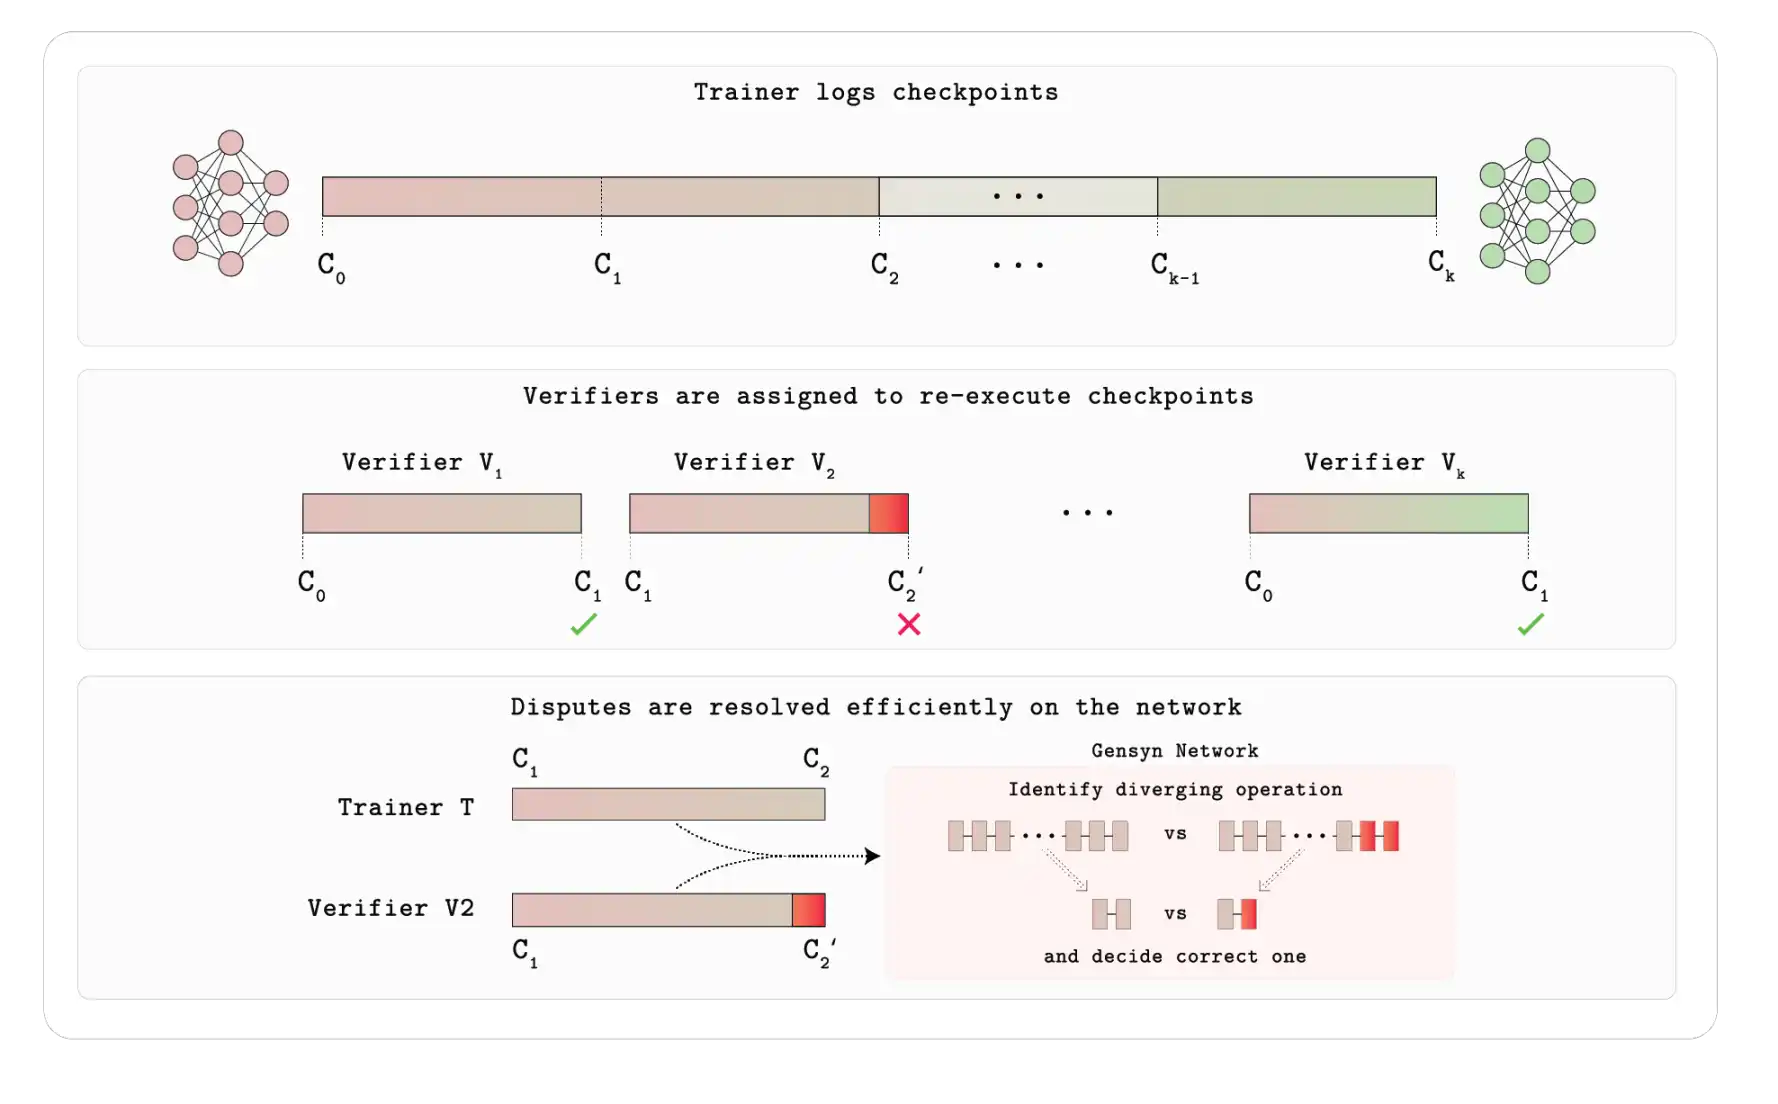
Vader의 워크플로우
3. 통신 과제: 노드 간 고주파 동기화로 인한 네트워크 병목 현상을 어떻게 줄일까요?
전통적인 분산 훈련에서는 모델이 완전 복제되거나 층별로 분할(파이프라인 병렬화)되어 노드 간 고주파 동기화가 필요합니다. 특히 파이프라인 병렬화에서는 특정 노드의 지연으로 인해 미니배치가 각 모델 층을 엄격히 따라야 하므로 한 노드의 지연만 발생해도 전체 훈련 프로세스가 차단됩니다.
Gensyn은 이 문제에 대응하여 SkipPipe를 제안했습니다. SkipPipe는 오류 내구성 파이프라인 훈련 시스템으로, 스킵 실행과 동적 경로 스케줄링을 지원합니다. SkipPipe는 "스킵 비율(skip ratio)" 메커니즘을 도입하여 특정 노드의 부하가 높을 때 일부 모델 층을 건너뛸 수 있도록 허용하며, 현재 최적의 계산 경로를 동적으로 선택하는 스케줄링 알고리즘을 사용합니다. 실험 결과, 지리적으로 분산된, 하드웨어 간 차이가 크고 대역폭 제한이 있는 네트워크 환경에서 SkipPipe는 훈련 시간을 최대 55%로 줄일 수 있었으며, 노드 고장률이 50%에 이르더라도 손실을 7%로 유지할 수 있어 매우 강한 탄력성과 적응성을 나타내었습니다.
참여 방법
2025년 3월 31일에 Gensyn의 공개 테스트넷이 론칭되었으며, 현재는 여전히 기술 로드맵 상 초기 단계(Phase 0)에 있습니다. 현재 기능은 RL Swarm의 배포와 검증에 중점을 두고 있습니다. RL Swarm은 Gensyn의 첫 번째 응용 프로그램 시나리오로, 강화 학습 모델의 협업 교육을 중심으로 설계되었습니다. 각 참여 노드는 행위를 체인 상 신원에 바인딩하며 공헌 과정은 완전히 기록되어, 이후 인센티브 할당 및 신뢰할 수 있는 계산 모델에 대한 기반을 제공합니다.
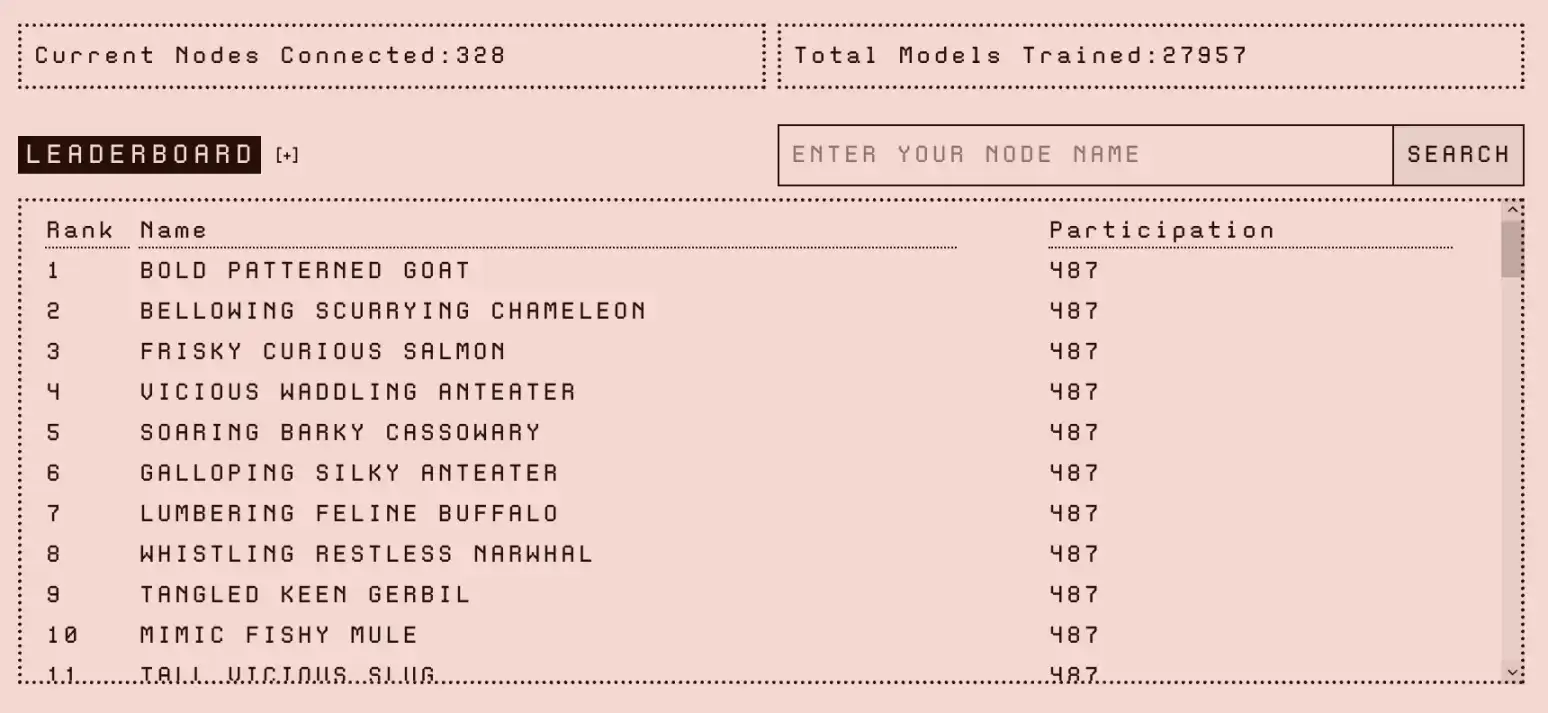
Gensyn 노드 랭킹
초기 테스트 단계의 하드웨어 요구 사항은 비교적 사용자 친화적입니다. Mac 사용자는 M 시리즈 칩으로 실행할 수 있으며, Windows 사용자는 3090 또는 4090과 같은 고성능 GPU 및 16GB 이상의 RAM을 권장하며, 이를 통해 로컬 Swarm 노드를 배포할 수 있습니다. 시스템이 실행된 후 웹 페이지에서 이메일(권장 사항 Gmail)로 로그인하여 검증 프로세스를 완료하고, HuggingFace 액세스 토큰을 바인딩할지 여부를 선택하여 더 완벽한 모델 기능을 활성화할 수 있습니다.
도전과 전망
현재 Gensyn 프로젝트의 가장 큰 불확실성은 테스트넷이 약속한 전체 기술 스택을 아직 포함하지 않고 있다는 사실입니다. Verde 및 SkipPipe와 같은 핵심 모듈은 아직 통합되지 않은 상태로, 이로 인해 아키텍처의 구현 능력에 대한 외부의 지켜보기가 지속되고 있습니다. 공식적인 설명은 다음과 같습니다: 테스트넷은 단계적으로 전진하며, 각 단계마다 새로운 프로토콜 능력을 잠금 해제하고, 기반 인프라의 안정성과 확장성을 우선적으로 확인합니다. 첫 번째 단계는 RL Swarm을 기반으로 하며, 이후 사전 학습, 추론 등 핵심 시나리오로 확장되어 마지막에는 실제 경제 거래를 지원하는 메인넷 배포로 이어질 것입니다.
테스트넷이 상대적으로 보수적인 속도로 시작되었음에도 불구하고, 한 달 만에 Gensyn은 더 큰 규모의 모델과 복잡한 수학적 작업을 지원하는 새로운 Swarm 테스트 작업을 선보였습니다. 이러한 조치는 어느 정도 외부의 개발 속도에 대한 의문에 반응했으며, 팀이 지역 모듈 전진에 대한 실행 효율성을 나타냈습니다.
그러나 문제도 함께 발생했습니다: 새로운 버전의 작업은 하드웨어에 매우 높은 장벽을 설정했으며, A100, H100 등 최고의 GPU(80GB VRAM)를 권장 구성으로 하여 중소 규모의 노드에게는 거의 도달할 수 없는 수준이었습니다. 이는 Gensyn이 강조하는 '오픈 액세스, 탈중앙화 트레이닝'의 초기 목표와 일정한 긴장을 유발했습니다. 계산 능력의 중심화 추세가 효과적으로 이끌어지지 않으면 네트워크의 공정성과 탈중앙화된 거버넌스의 지속 가능성에 영향을 미칠 수 있습니다.
이어서 Verde와 SkipPipe가 원활하게 통합되면 프로토콜의 완전성과 協同 효율이 향상될 것으로 예상됩니다. 그러나 Gensyn이 성능과 분산화 사이에서 진정한 균형을 찾을 수 있는지에 대한 의문은 아직 네트워크의 보다 긴 기간과 보다 넓은 범위의 실행 실증 검증을 필요로 합니다. 현재 이는 잠재력을 드러내고 동시에 과제를 드러냈으며, 이는 조기 기반 프로젝트의 가장 현실적인 상태입니다.
Bittensor: 분산형 AI 네트워크의 혁신과 발전
프로젝트 개요
Bittensor는 블록체인과 인공지능을 결합한 혁신적인 프로젝트로, Jacob Steeves와 Ala Shaabana가 2019년에 설립한 것으로,「기계 지능의 시장 경제」를 구축하는 것을 목표로 합니다. 두 창립자는 모두 인공지능과 분산 시스템에 대한 깊은 배경을 가지고 있습니다. 프로젝트의 백서 서명 저자 Yuma Rao는 팀의 주요 기술 고문으로, 프로젝트에 암호학 및 합의 알고리즘 분야의 전문적인 시각을 제공했습니다.
이 프로젝트는 전 세계 컴퓨팅 리소스를 블록체인 프로토콜에 통합하여 지속적으로 자기 최적화되는 분산 신경망 생태계를 구축하고자 합니다. 이 비전은 컴퓨팅, 데이터, 저장 및 모델 등의 디지털 자산을 지능적인 가치 흐름으로 변환하여 새로운 경제 형태를 구축하고 AI 발전의 혜택을 공정하게 분배하는 것입니다. OpenAI와 같은 중앙 집중형 플랫폼과 달리, Bittensor는 세 가지 핵심 가치 지주를 갖추었습니다:
· 데이터 고립 탈피: TAO 토큰을 활용해 지식 공유와 모델 기여를 촉진
· 시장 주도의 품질 평가: 게임 이론 메커니즘을 도입하여 우수한 AI 모델을 선별하고 우열을 가림
· 네트워크 효과 증폭기: 참여자 성장과 네트워크 가치가 기하급수적으로 상호작용하여 양호한 순환을 형성
투자 구조면에서, Polychain Capital은 2019년부터 Bittensor를 인큐베이팅하고 있으며 현재 약 2억 달러 규모의 TAO 토큰을 보유하고 있으며, Dao5는 약 5000만 달러 규모의 TAO를 보유하고 있으며 Bittensor 생태계의 초기 지원자입니다. 2024년에는 Pantera Capital과 Collab Currency가 전략적 투자를 통해 추가 투입했습니다. 같은 해 8월, Grayscale Group은 TAO를 기관 투자자들에게 소개하여 프로젝트 가치에 대한 높은 평가와 장기적인 긍정을 상징적으로 보여주었습니다.
디자인 아키텍처 및 운영 메커니즘
네트워크 아키텍처
Bittensor는 네 개의 協력레벨로 구성된 정밀 네트워크 아키텍처를 구축했습니다:
· 블록체인 레이어: Substrate 프레임워크를 기반으로 구축되었으며, 네트워크의 신뢰 기반으로 작용하여 상태 변화와 토큰 발행을 기록합니다. 시스템은 12초마다 새로운 블록을 생성하고 규칙에 따라 TAO 토큰을 발행하여 네트워크 합의와 인센티브 분배를 보장합니다.
· 뉴런 레이어 (Neuron): 네트워크의 컴퓨팅 노드로, 뉴런은 다양한 AI 모델을 실행하여 지능형 서비스를 제공합니다. 각 노드는 정확하게 설계된 구성 파일을 통해 서비스 유형과 인터페이스 규격을 명시하고, 기능적 모듈화와 플러그 앤 플레이를 실현합니다.
· 시냅스 레이어 (Synapse): 네트워크의 통신 다리로, 시냅스는 동적으로 노드 간 연결 가중치를 최적화하여 신속한 정보 전달을 보장합니다. 시냅스에는 경제 모델도 내장되어, 뉴런 간 상호 작용 및 서비스 호출은 TAO 토큰을 결제해야 하며, 가치 순환 생태계를 형성합니다.
· 메타그래프 레이어 (Metagraph): 시스템의 글로벌 지식 그래프로, 각 노드의 기여 가치를 계속 모니터링하고 평가하여 전체 네트워크에 지능적인 유도를 제공합니다. 메타그래프는 정확한 계산을 통해 시냅스 가중치를 결정하고, 이를 통해 리소스 할당, 보상 메커니즘 및 노드의 네트워크 내 영향력에 영향을 줍니다.
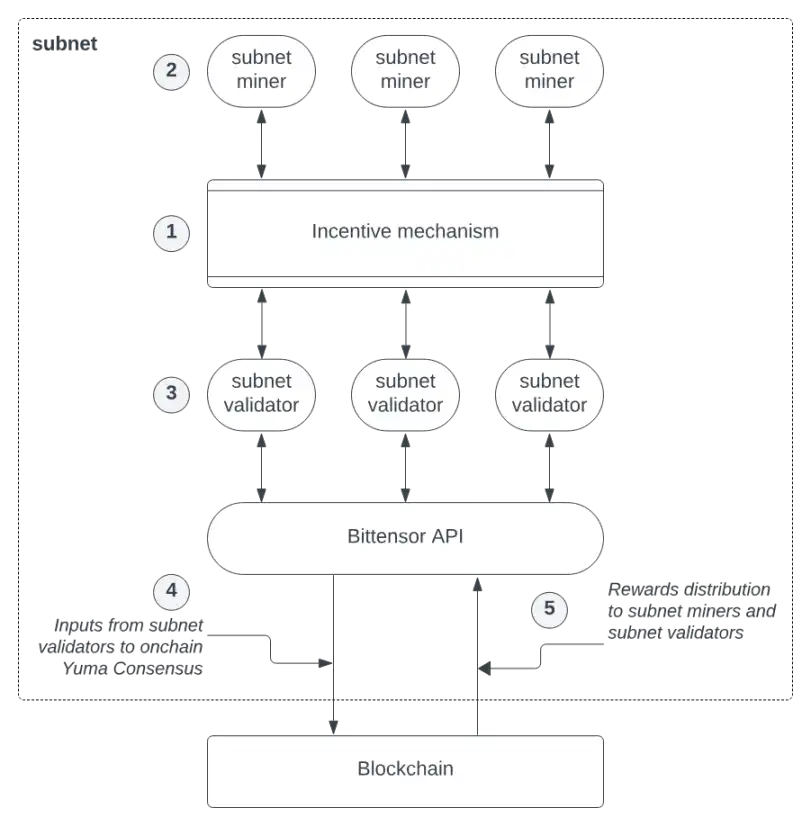
Bittensor의 네트워크 프레임워크
Yuma 합의 메커니즘
네트워크는 독특한 Yuma 합의 알고리즘을 채택하여 72분마다 보상 분배 라운드를 완료합니다. 확인 프로세스는 주관적 평가와 객관적 측정을 결합합니다:
· 주관적 점수: 검증자가 채굴자의 출력 품질을 주관적으로 평가합니다.
· 피셔 정보 행렬: 노드의 전체 네트워크 기여를 객관적으로 측정합니다.
이러한 "주관적 + 객관적" 혼합 메커니즘은 전문 판단과 알고리즘 공정성을 효과적으로 균형잡아 주게 됩니다.
서브넷 (Subnet) 아키텍처 및 dTAO 업그레이드
각 하위 네트워크는 텍스트 생성, 이미지 인식 등과 같은 특정 AI 서비스 영역에 초점을 맞추며, 독립적으로 실행되지만 주 블록체인 subtensor와 연결되어 높은 유연성을 갖는 모듈화 확장 아키텍처를 형성합니다. Bittensor는 2025년 2월에 획기적인 dTAO(동적 TAO) 업그레이드를 완료했습니다. 이 시스템은 각 하위 네트워크를 독립적인 경제 단위로 변형시켜 시장 수요 신호에 따라 리소스 할당을 지능적으로 조정합니다. 핵심 혁신은 하위 네트워크 토큰(알파 토큰) 메커니즘입니다:
· 작동 방식: 참가자는 TAO를 스테이킹하여 각 하위 네트워크에서 발행된 알파 토큰을 획득하며, 이러한 토큰은 특정 하위 네트워크 서비스에 대한 시장 승인과 지원의 정도를 나타냅니다.
· 할당 논리: 알파 토큰의 시장 가격은 하위 네트워크 수요 강도를 측정하는 주요 지표로, 초기 상태에서 각 하위 네트워크 알파 토큰 가격은 동일하며, 각 유동성 풀에는 TAO 1개와 알파 토큰 1개만 포함됩니다. 거래 활성도와 유동성 공급이 증가함에 따라 알파 토큰 가격이 동적으로 조정되며, TAO의 할당은 하위 네트워크 토큰 가격 비율에 따라 지능적으로 분배되어 수요가 높은 하위 네트워크가 보다 많은 리소스를 받아 수요 주도형 리소스 최적화 구성을 실현합니다.
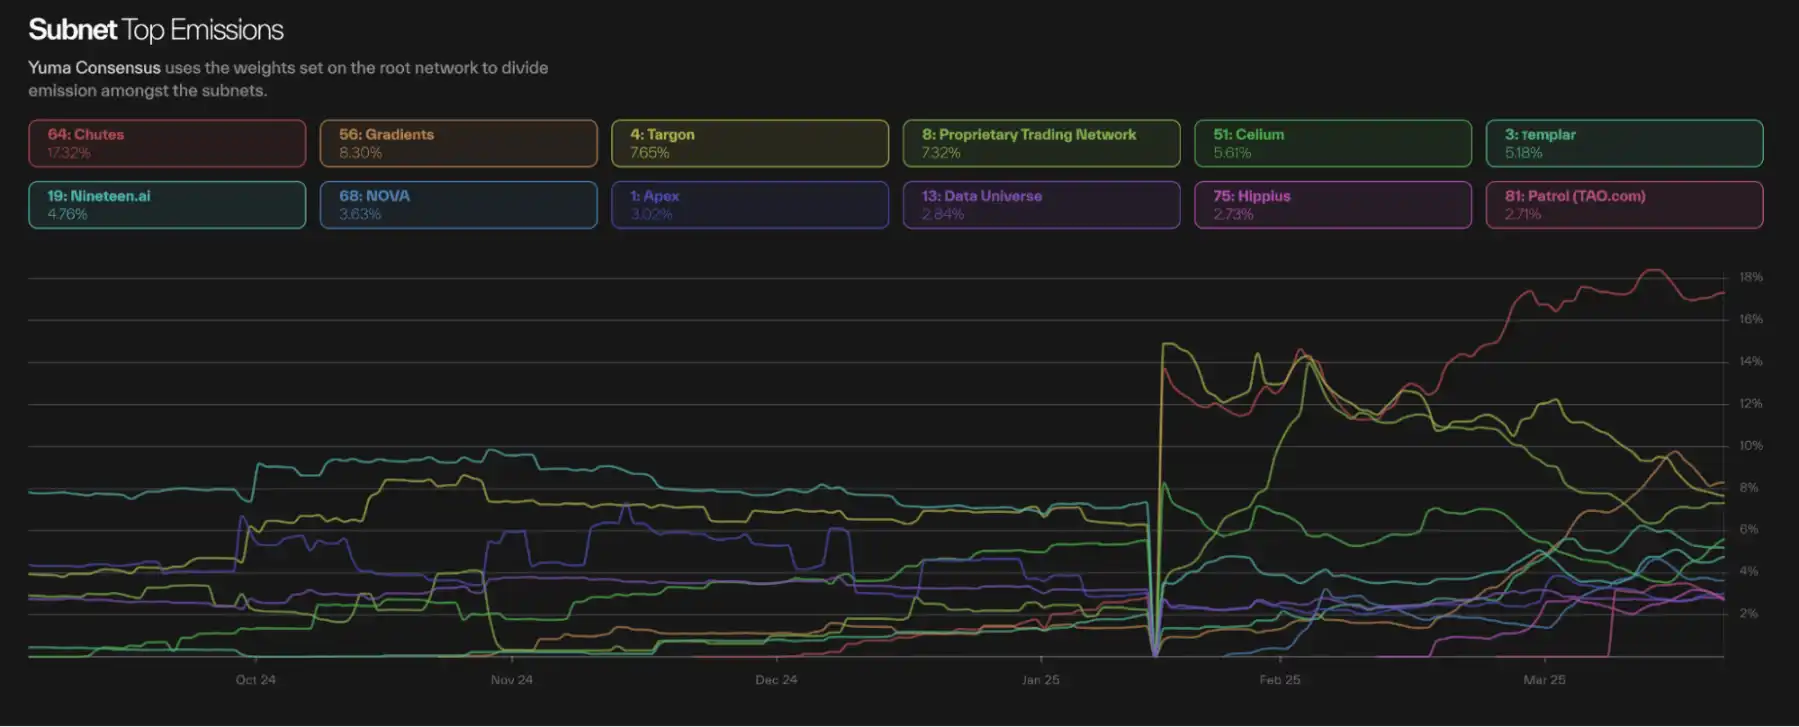
Bittensor 하위 네트워크 토큰 에미션 할당
dTAO 업그레이드는 생태계의 활기와 리소스 활용 효율을 크게 향상시켰으며, 하위 네트워크 토큰 시장 총 가치는 이미 50억 달러에 이르며 강력한 성장 모멘텀을 나타내고 있습니다.
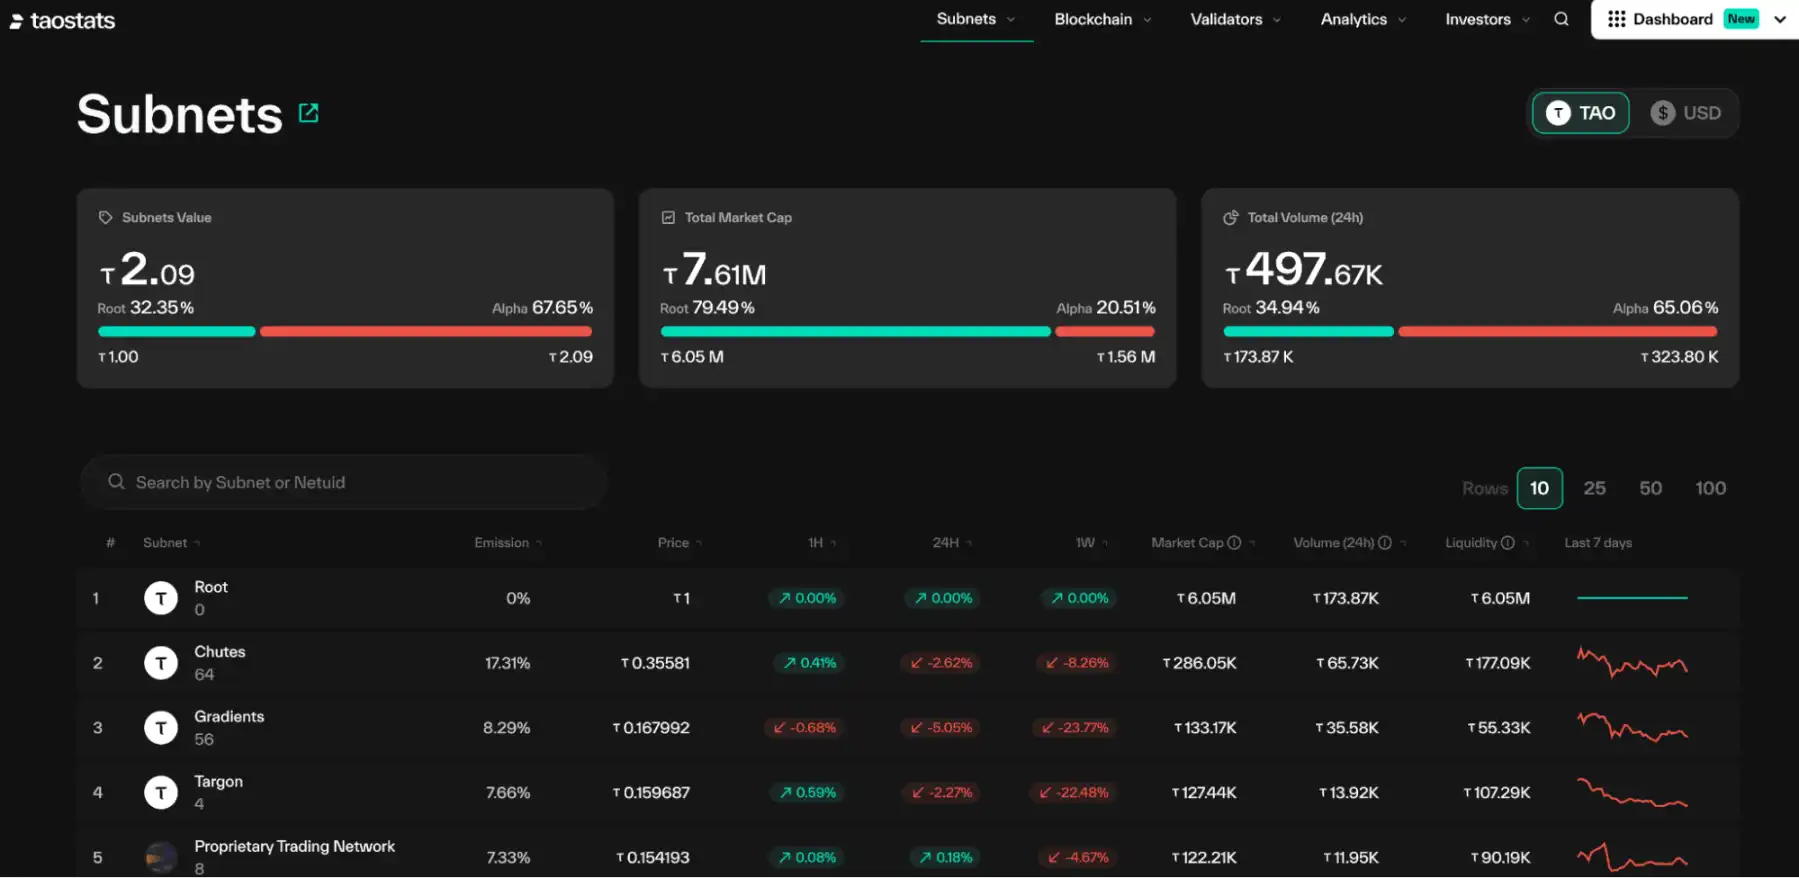
Bittensor 하위 네트워크 알파 토큰 가치
생태계 발전 및 응용 사례
메인넷 발전 과정
Bittensor 네트워크는 세 가지 주요 발전 단계를 거쳤습니다:
· 2021년 1월: 메인넷 공식 시작, 기반 인프라 확립
· 2023년 10월: "Revolution" 업그레이드를 통해 하위 네트워크 구조를 도입하여 기능을 모듈화화
· 2025년 2월: dTAO 업그레이드 완료, 시장 주도형 리소스 할당 메커니즘 구축
서브넷 생태계는 폭발적인 성장을 보이고 있습니다. 2025년 6월 현재, 이미 119개의 전문 서브넷이 존재하며, 매년 200개 이상으로 증가할 것으로 예상됩니다.
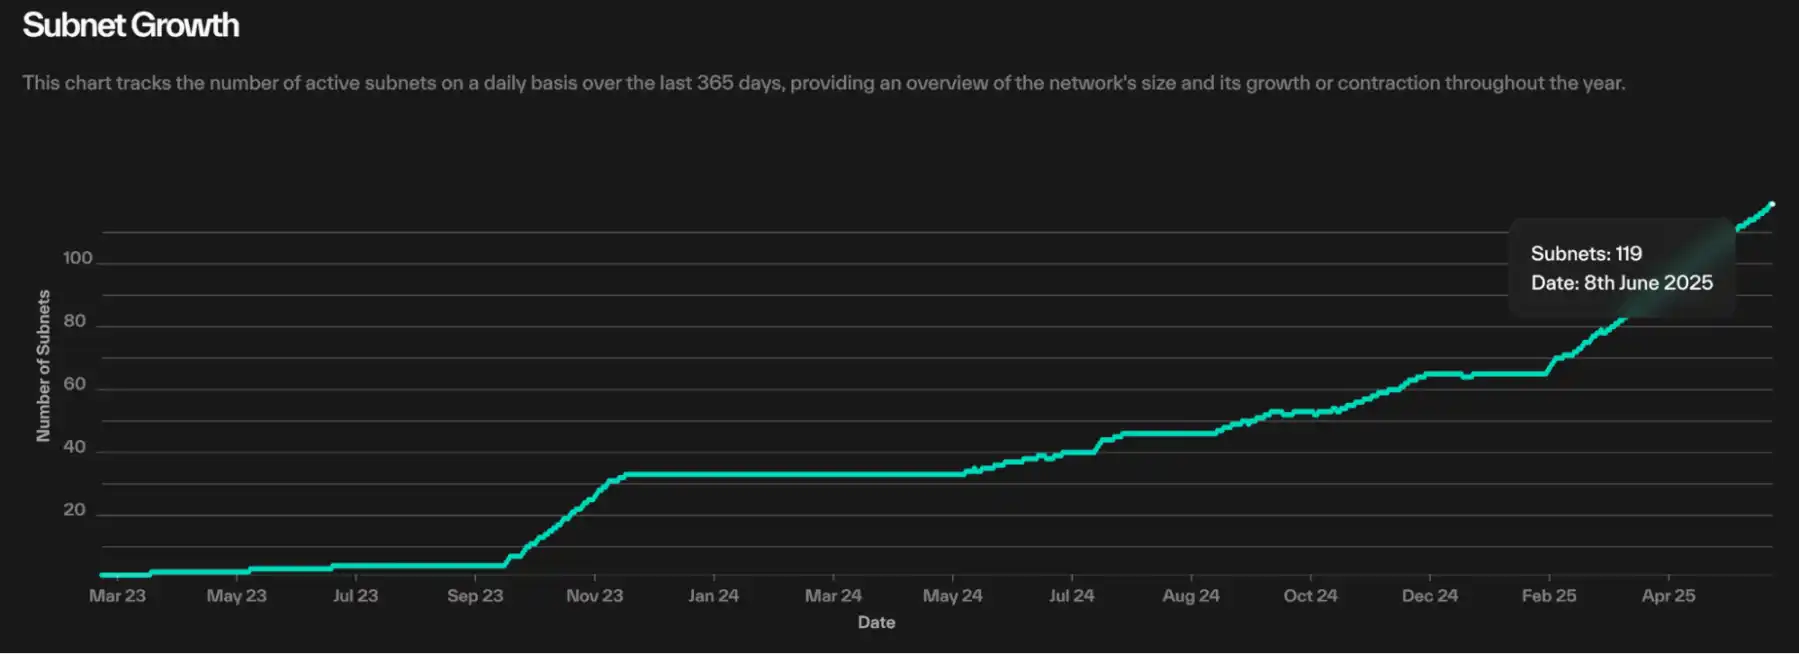
Bittensor 서브넷 수
생태 프로젝트는 AI 에이전트 (예: Tatsu), 예측 시장 (예: Bettensor), DeFi 프로토콜 (예: TaoFi) 등 AI와 금융이 심층적으로 융합된 혁신적인 생태계를 형성하는 여러 선도적인 분야를 다양하게 포함하고 있습니다.
대표적인 서브넷 생태 프로젝트
· TAOCAT: TAOCAT은 Bittensor 생태계의 네이티브 AI 에이전트로, 직접 서브넷 위에 구축되어 사용자에게 데이터 기반 의사결정 도구를 제공합니다. Subnet 19의 대형 언어 모델, Subnet 42의 실시간 데이터, Subnet 59의 Agent Arena을 이용하여 시장 통찰력과 의사결정 지원을 제공합니다. 2억 달러 규모의 AI 에이전트 펀드에 DWF Labs 투자를 유치하고, binance alpha에 상장되었습니다.
· OpenKaito: Kaito 팀이 Bittensor 상에 출시한 서브넷으로, 탈중앙화된 암호화폐 산업 검색 엔진을 구축하는 것을 목표로 합니다. 현재 5억 개의 웹 리소스를 색인화하였으며, 탈중앙화된 AI가 대량 데이터를 처리하는 강력한 능력을 보여주고 있습니다. 전통적인 검색 엔진과 비교했을 때, 핵심 장점은 상업적 이해관계 간섭을 줄이고 더 투명하고 중립적인 데이터 처리 서비스를 제공하여 Web3 시대의 정보 획득에 새로운 패러다임을 제공합니다.
· Tensorplex Dojo: Tensorplex Labs가 개발한 52번 서브넷으로, 분산형 플랫폼에서 고품질 인간 생성 데이터셋을 크라우드소싱하는 데 중점을 두고 있습니다. 사용자가 데이터 주석을 통해 TAO 토큰을 벌 수 있도록 장려합니다. 2025년 3월, YZi Labs(본래 Binance Labs)가 Tensorplex Labs에 투자하고 Dojo 및 Backprop Finance의 발전을 지원한다고 발표했습니다.
· CreatorBid: Subnet 6에서 운영되며, AI와 블록체인을 결합한 창작 플랫폼으로, Olas 및 기타 GPU 네트워크 (예: io.net)와 통합되어 콘텐츠 크리에이터와 AI 모델 개발을 지원합니다.
기술과 산업 협력
Bittensor는 다양한 분야와의 협력에서 돌파구를 찾았습니다:
· Hugging Face와의 협업을 통해 깊이있는 모델 통합 채널을 구축하여 50가지 주요 AI 모델의 온체인 심부한 배포 달성
· 2024년 Cerebras와 협력하여 고성능 AI 칩 제조업체와 함께 BTLM-3B 모델을 공동 출시하며 다운로드 수가 16만 회를 넘어섬
· 2025년 3월 DeFi 거물 Aave와 전략적 협력을 맺어 고품질 대출 담보로서 rsTAO의 응용 분야를 공동 탐구
참여 방법
Bittensor는 생태 참여 경로를 다양화하여 완전한 가치 창출과 분배 체계를 형성했습니다:
· 채굴: 채굴자 노드를 배치하여 고품질 디지털 상품(예: AI 모델 서비스)을 생산하고 기여 품질에 따라 TAO 보상을 받습니다
· 검증: 검증자 노드를 실행하여 채굴자의 작업 성과를 평가하고 네트워크 품질 기준을 유지하며 해당하는 TAO 장려금을 받습니다
· 스테이킹: TAO를 보유하고 스테이킹하여 우수한 검증자 노드를 지원하며 검증자 성과에 따라 패시브 수익을 얻습니다
· 개발: Bittensor SDK 및 CLI 도구를 활용하여 혁신적인 응용프로그램, 유용한 도구 또는 새로운 하위네트워크를 구축하고 생태계 구축에 적극적으로 참여합니다
· 서비스 이용: 사용자 친화적인 클라이언트 애플리케이션 인터페이스를 통해 AI 서비스(예: 텍스트 생성 또는 이미지 인식)를 이용합니다
· 거래: 하위네트워크 자산화 토큰의 시장 거래에 참여하여 잠재적인 가치 증대 기회를 잡습니다
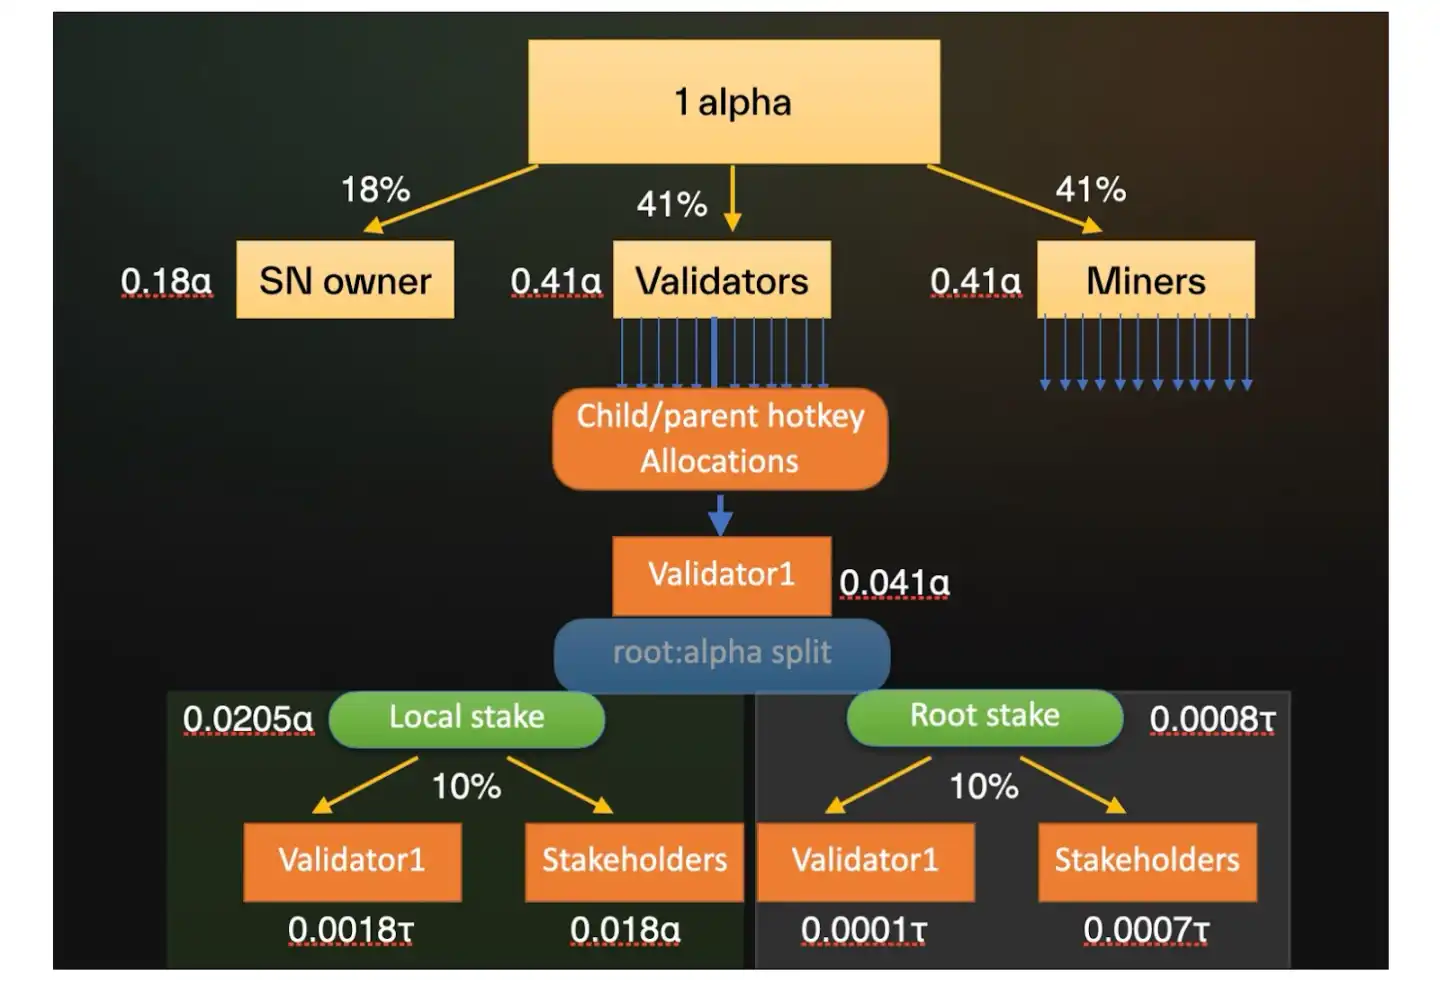
참여자에게 할당된 서브넷 알파 토큰
도전과 전망
Bittensor는 우수한 잠재력을 보여주고 있지만, 선도 기술 탐구로, 다양한 차원의 도전에 직면하고 있습니다. 기술적 측면에서, 분산 AI 네트워크는 중앙 집중식 시스템보다 더 복잡한 보안 위협(예: 모델 유출 및 공격)에 직면하며 프라이버시 컴퓨팅과 보안 방어 솔루션을 지속적으로 최적화해야 합니다; 경제 모델 측면에서, 초기에 인플레이션 압력이 존재하며 서브넷 토큰 시장 변동성이 높기 때문에 가능한 투기 거품을 조심해야 합니다; 규제 환경에서, 비록 SEC가 TAO를 유틸리티 토큰으로 분류했지만, 지역별 규제 프레임워크의 차이로 인해 생태 확장이 제한될 수 있습니다; 동시에, 자금력이 있는 중앙 집중식 AI 플랫폼의 치열한 경쟁에 직면하며, 탈중앙화 솔루션이 사용자 경험과 비용 효율성 면에서 장기적인 경쟁 우위를 입증해야 합니다.
2025년 하프닝 주기가 점점 다가올수록, Bittensor의 발전은 네 가지 전략적 방향에 초점을 맞출 것입니다: 서브넷 전문화된 역할 분담을 더욱 깊게 진화시켜 수직 분야 응용의 서비스 품질과 성능을 향상시키기; DeFi 생태계와의 깊은 통합을 가속화하여 새롭게 도입된 EVM 호환성을 활용해 스마트 계약 응용의 경계를 확장하기; dTAO 메커니즘을 통해 다음 100일 동안 네트워크 거버넌스 가중치를 TAO에서 점진적으로 알파 토큰으로 변경해 가며 거버넌스의 탈중앙화 진행을 촉진하며, 동시에 다른 주요 공중망과의 상호 운용성을 적극적으로 확대하여 생태계 경계와 응용 시나리오를 확장할 것입니다. 이러한 협력적 전략적 조치들은 Bittensor가 "기계 지능 시장 경제"로 나아가는 웅장한 비전을 단단히 향상시킬 것입니다.
0G: 저장을 기반으로 한 모듈화된 AI 에코시스템
프로젝트 개요
0G는 데이터 집중적이고 고성능 계산이 필요한 시나리오에 효율적이고 신뢰성 있는 탈중앙화 인프라를 제공하는 것을 목표로 하는 AI 응용을 위해 설계된 모듈화 Layer 1 공중망입니다. 모듈화 아키텍처를 통해, 0G는 합의, 저장, 계산 및 데이터 가용성 등 핵심 기능의 독립적 최적화를 실현하며, 동적 확장을 지원하며 대규모 AI 추론과 학습 작업을 효율적으로 처리할 수 있습니다.
창업팀은 Michael Heinrich(CEO, 이전에 10억 달러 이상을 조달한 Garten을 설립함), Ming Wu(CTO, 마이크로소프트 연구원, Conflux 공동 창업자), Fan Long(Conflux 공동 창업자) 및 Thomas Yao(CBO, Web3 투자자)로 구성되어 있으며, 컴퓨터 과학 박사학위를 가진 구성원 8명은 마이크로소프트, 애플 등에서 함께 일했으며 블록체인과 AI 기술 경험이 풍부합니다.
자금 조달 측면에서, 0G Labs는 3500만 달러의 Pre-seed 라운드와 4000만 달러의 Seed 라운드를 완료하여 총 7500만 달러로, 투자자로는 Hack VC, Delphi Ventures 및 Animoca Brands 등이 포함되어 있습니다. 또한, 0G Foundation은 2억 5000만 달러의 토큰 구매 약정, 3060만 달러의 공개 노드 판매 및 8888만 달러의 생태 기금을 확보했습니다.
디자인 아키텍처
1. 0G Chain
0G Chain의 목표는 가장 빠른 모듈화 AI 공중망을 구축하는 것이며, 이러한 모듈화 아키텍처는 합의, 실행 및 저장 등 핵심 구성 요소의 독립 최적화를 지원하며 데이터 가용성 네트워크, 분산 저장소 네트워크 및 AI 계산 네트워크를 통합하였습니다. 이러한 설계는 시스템이 복잡한 AI 응용 시나리오에 대응할 때 우수한 성능과 유연성을 제공합니다. 다음은 0G Chain의 세 가지 핵심 기능입니다:
모듈화된 확장성 (AI를 위한 모듈화된 확장성)
0G는 가로 확장이 가능한 아키텍처를 채택하여 대규모 데이터 워크플로를 효율적으로 처리할 수 있습니다. 모듈화된 설계로 데이터 가용성 계층 (DA 계층)을 데이터 저장 계층과 분리함으로써 AI 작업 (대규모 학습 또는 추론과 같은)의 데이터 액세스 및 저장에 더 높은 성능과 효율성을 제공합니다.
0G 합의 (0G Consensus)
0G의 합의 메커니즘은 여러 독립적인 합의 네트워크로 구성되어 있으며, 이러한 네트워크는 필요에 따라 동적으로 확장할 수 있습니다. 데이터 양이 기하 급수적으로 증가함에 따라 시스템 처리량을 동시에 증가시켜 1개부터 수백 개 또는 수천 개의 네트워크까지 확장할 수 있습니다. 이러한 분산 아키텍처는 성능을 향상시키는데 그치지 않고 시스템의 유연성과 신뢰성을 보장합니다.
공유 스테이킹 (Shared Staking)
검증자는 이더리움 메인넷에 자금을 스테이킹하여 모든 참여하는 0G 합의 네트워크에 보안을 제공해야 합니다. 0G 네트워크에서 벌칙 사건이 발생하면 검증자의 이더리움 메인넷 상의 스테이킹 자금이 감소됩니다. 이 메커니즘은 이더리움 메인넷의 보안을 모든 0G 합의 네트워크로 확장하여 전체 시스템의 안전성과 견고성을 보장합니다.
0G Chain은 EVM 호환성을 갖추었으며, 이더리움, Layer 2 Rollup 또는 다른 체인의 개발자가 0G의 서비스 (데이터 가용성 및 저장)를 쉽게 통합할 수 있도록 하여 이주가 필요하지 않습니다. 동시에 0G는 Solana VM, Near VM 및 비트코인 호환성 지원을 탐구하여 AI 애플리케이션을 보다 넓은 사용자 그룹에 확장하고자 합니다.
2. 0G 스토리지 (0G Storage)
0G 스토리지는 분산형 데이터 저장 시스템으로, 탈중앙화 애플리케이션 및 데이터 집약적 시나리오를 위해 특별히 설계되었습니다. 그 핵심은 고유한 합의 메커니즘인 임의 접근 증명 (PoRA)을 통해 블록 생산자가 데이터를 저장하고 관리하도록 자극하여 안전성, 성능 및 공정성을 균형 있게 유지합니다.
그 아키텍처는 세 가지 계층으로 나눌 수 있습니다:
· 로그 계층 (Log Layer): 비구조화 데이터의 영구 저장을 구현하며, 아카이브 또는 데이터 로그 등의 용도에 적합합니다.
· 키-값 저장층 (Key-Value Layer): 가변 구조화 데이터를 관리하고 권한 제어를 지원하며 동적 응용 프로그램 시나리오에 적합합니다.
· 트랜잭션 처리층 (Transaction Layer): 다중 사용자 동시 쓰기를 지원하여 협업과 데이터 처리 효율성을 향상시킵니다.
임의 접근 증명 (Proof of Random Access, PoRA)은 0G Storage의 핵심 메커니즘으로, 채굴자가 지정된 데이터 블록을 올바르게 저장했는지를 검증합니다. 채굴자는 주기적으로 도전을 수락하며 증명으로 유효한 암호화 해시를 제공해야 합니다. 이는 작업 증명과 유사합니다. 공정한 경쟁을 보장하기 위해 0G는 채굴당시 데이터 범위를 8TB로 제한하여 대규모 운영자가 자원을 독점하는 것을 피하고 소규모 채굴자도 공정한 환경에서 경쟁할 수 있도록 합니다.
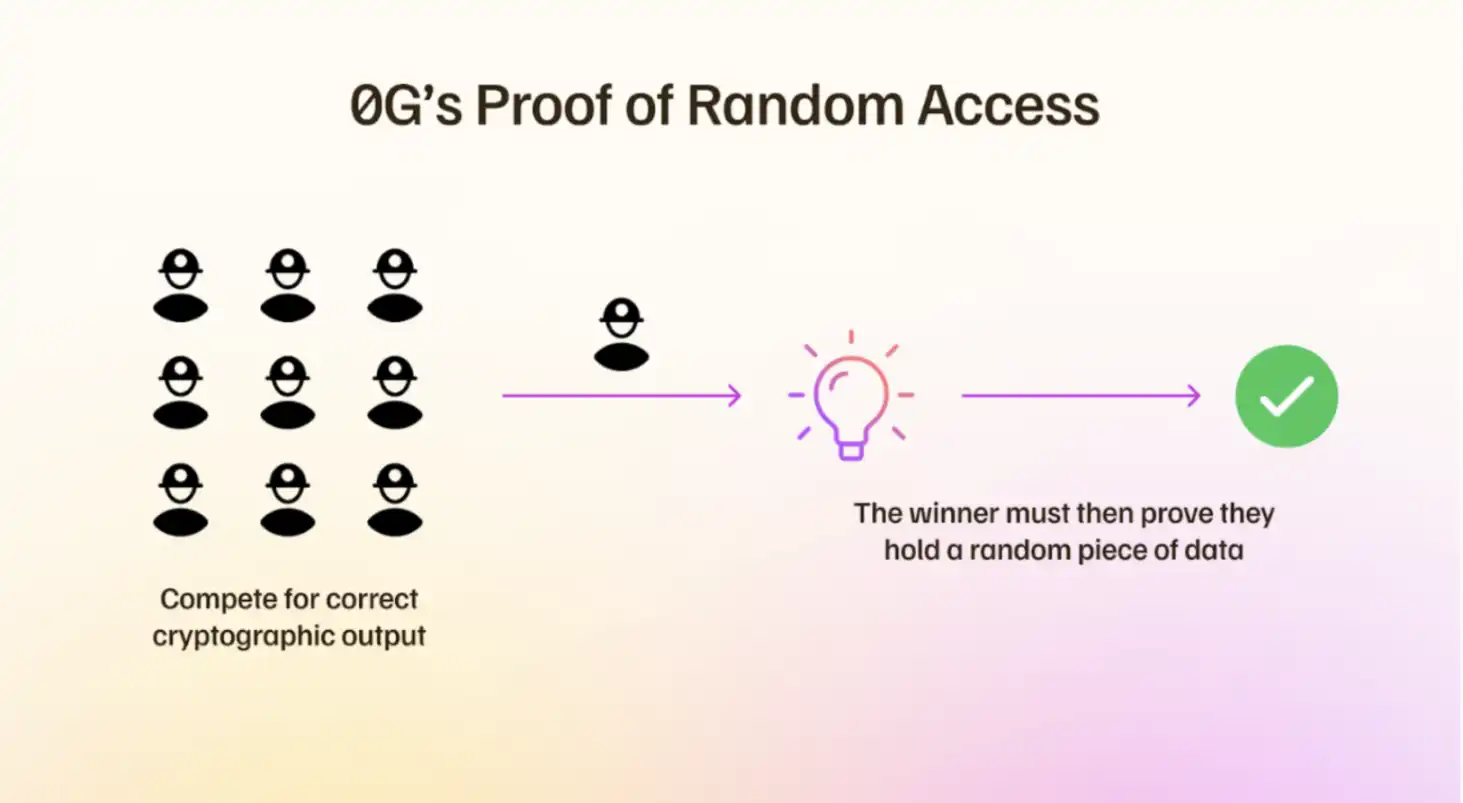
임의 접근 증명 개괄 도식
변형 부호화 기술을 통해 0G Storage는 데이터를 여러 개의 중복된 작은 조각으로 분할하고 다른 저장 노드에 분산합니다. 이 설계는 일부 노드가 오프라인 상태거나 고장 나더라도 데이터를 완전히 복구할 수 있도록 보장하며 데이터의 가용성과 안전성을 크게 향상시킵니다. 이는 대규모 데이터 처리 시스템에서 우수한 성능을 보여주지만 프로도. 뿐만 아니라 데이터 저장은 섹터 수준과 데이터 블록 레벨의 정교한 관리를 통해 데이터 엑세스 효율을 최적화하고 채굴자의 저장 네트워크 내 부각력을 향상시킵니다.
제출된 데이터는 순차적으로 구성되며 해당 순서는 데이터 흐름(data flow)이라고합니다. 이는 로그 항목 목록 또는 고정 크기 데이터 섹터 시퀸스로 이해될 수 있습니다. 0G에서 각 데이터 블록은 범용 오프셋(offset)을 통해 빠르게 찾아낼 수 있으며 이로써 효율적인 데이터 검색과 도전 질의를 구현할 수 있습니다. 기본적으로 0G는 대부분의 응용 프로그램을 처리하기 위한 일반적인 데이터 흐름인 주 데이터 흐름(main flow)을 제공합니다. 동시에 시스템은 특수한 목적의 데이터 흐름(specialized flows)을 지원하며 이러한 데이터 흐름은 특정 범주의 로그 항목을 받아들이며 독립적인 연속 주소 공간을 제공하여 서로 다른 응용 프로그램 요구를 최적화합니다.
위의 설계를 통해 0G Storage는 다양한 사용 시나리오에 유연하게 대응할 뿐만 아니라 효율적인 성능과 관리 능력을 유지하며 대규모 데이터 흐름을 처리해야하는 AI x Web3 응용 프로그램에 강력한 저장 지원을 제공합니다.
3. 0G 데이터 가용성 (0G DA)
데이터 가용성(Data Availability, DA)은 0G의 핵심 구성 요소 중 하나로, 접근 가능하고 확인할 수 있으며 검색 가능한 데이터를 제공하는 것을 목표로 합니다. 이 기능은 탈중앙화된 AI 인프라의 핵심이며, 사용자 요구를 충족시키고 시스템 인센티브 메커니즘의 신뢰성을 보장하기 위해 학습 또는 추론 작업을 확인하는 것과 같은 기능을 합니다. 0G DA는 정교하게 설계된 아키텍처와 검증 메커니즘을 통해 우수한 확장성과 보안을 실현했습니다.
0G DA의 설계 목표는 안전성을 보장하며 동시에 매우 높은 확장 성능을 제공하는 것입니다. 그 작업 흐름은 주로 두 부분으로 나뉩니다:
· 데이터 저장 차널(Data Storage Lane): 데이터는 적삭 부호 기술을 사용하여 여러 작은 조각("데이터 블록")으로 분할되고 0G 스토리지 네트워크의 저장 노드에 분산됩니다. 이 메커니즘은 대규모 데이터 전송을 효과적으로 지원하며 동시에 데이터의 중복성과 복구력을 보장합니다.
· 데이터 게시 차널(Data Publishing Lane): 데이터의 가용성은 DA 노드가 집계 서명을 통해 확인하고 결과를 합의 네트워크에 제출함으로써 확인됩니다. 이 설계를 통해 데이터 게시는 소량의 필수 데이터 스트림만 처리해야 하므로 전통적인 방송 방식의 병목 현상을 피하고 효율성을 크게 향상시킵니다.
데이터의 안전성과 효율성을 보장하기 위해 0G DA는 무작위성 기반 검증 방법과 집계 서명 메커니즘을 사용하여 완전한 검증 프로세스를 형성합니다:
· 무작위 그룹 구성: 검증 가능한 무작위 함수(Verifiable Random Function, VRF)를 통해 합의 시스템은 검증자 집합에서 DA 노드 그룹인 법정 그룹(quorum)을 무작위로 선출합니다. 이 무작위 선택 방법은 이론적으로 법정 그룹의 정직한 분포를 전체 검증자 집합과 일치시키므로 데이터 가용성 클라이언트가 법정 그룹과 공모할 수 없습니다.
· 집계 서명 확인: 법정 그룹은 저장된 데이터 블록을 샘플링하여 검증하고 집계 서명을 생성하여 0G의 합의 네트워크에 가용성 증명을 제출합니다. 이러한 집계 서명 방식은 검증 효율을 크게 향상시키며 성능은 전통적인 이더리움보다 몇 가지 수준 빠릅니다.
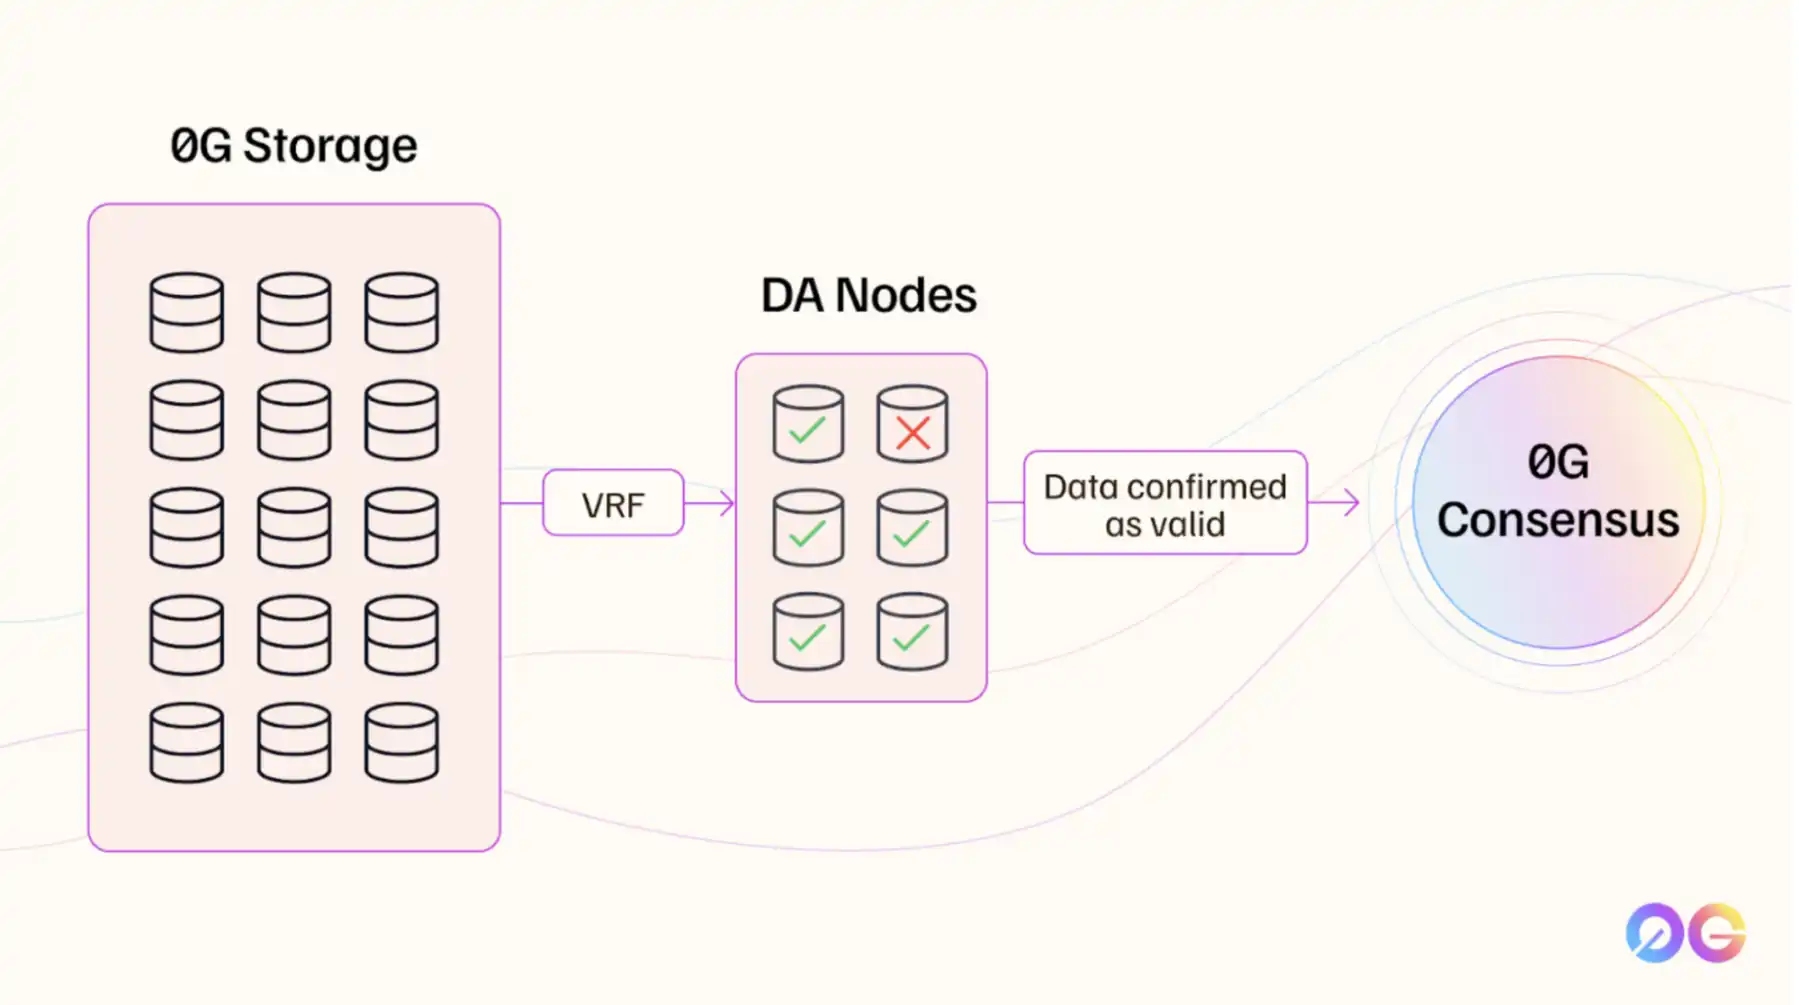
0G의 검증 프로세스
위의 메커니즘을 통해 0G 데이터 가용성(DA)는 효율적이고 확장 가능하며 안전한 데이터 사용 솔루션을 제공하여 탈중앙화 AI 애플리케이션에 견고한 기반을 제공합니다.
4. 0G 컴퓨트(0G Compute)
0G 컴퓨트 네트워크는 커뮤니티에 강력한 AI 컴퓨팅 능력을 제공하기 위한 탈중앙화 프레임워크입니다. 스마트 계약을 통해 컴퓨팅 공급업체는 제공하는 AI 서비스 유형(예: 모델 추론)을 등록하고 서비스에 가격을 설정할 수 있습니다. 사용자가 AI 추론 요청을 보내면 서비스 제공업체는 사용자 잔액에 따라 응답할지 여부를 결정하여 효율적인 컴퓨팅 자원 할당을 실현합니다.
거래 비용과 네트워크 효율성을 더욱 높이기 위해 서비스 제공업체는 여러 사용자 요청을 일괄 처리할 수 있습니다. 이 방식은 온체인 결제 횟수를 효과적으로 줄이고 빈번한 거래로 인한 리소스 소비를 줄입니다. 동시에 0G 컴퓨트 네트워크는 제로 지식 증명(ZK-Proofs) 기술을 채택하여 오프체인 계산과 온체인 검증을 통해 거래 데이터를 크게 압축하고 온체인 결제 비용을 낮춥니다. 0G의 스토리지 모듈과 결합하여 확장 가능한 오프체인 데이터 관리 메커니즘은 스토리지 요청 추적 데이터 키의 온체인 비용을 크게 줄이면서 스토리지 및 검색 효율성을 향상시킵니다.
현재 0G의 탈중앙화 AI 네트워크는 주로 AI 추론 서비스를 제공하며 효율성과 비용 최적화에서 우수성을 나타내고 있습니다. 미래에는 0G가 推론부터 훈련까지 다양한 AI 작업을 포괄하는 완전한 탈중앙화를 실현하여 사용자에게 더 완벽한 솔루션을 제공할 계획입니다.
생태계 발전
0G의 테스트넷은 현재 Newton v2에서 Galileo v3로 업그레이드되었으며 공식 데이터에 따르면 8000명 이상의 검증자가 있습니다. 스토리지 네트워크에는 1591명의 활성 광부가 있으며 현재 43만 건 이상의 파일 업로드를 처리하여 총 450.72G의 저장 공간을 제공했습니다.
또한 0G 프로젝트는 협력 기업의 증가와 심화에 따라 탈중앙화 AI 분야에서의 영향력을 꾸준히 확대하고 있으며, 공식 데이터에 따르면 현재 450회 이상의 통합을 완료하여 AI 컴퓨팅, 데이터, 모델, 프레임워크, 인프라, DePin 등 다양한 영역을 포함하고 있습니다.
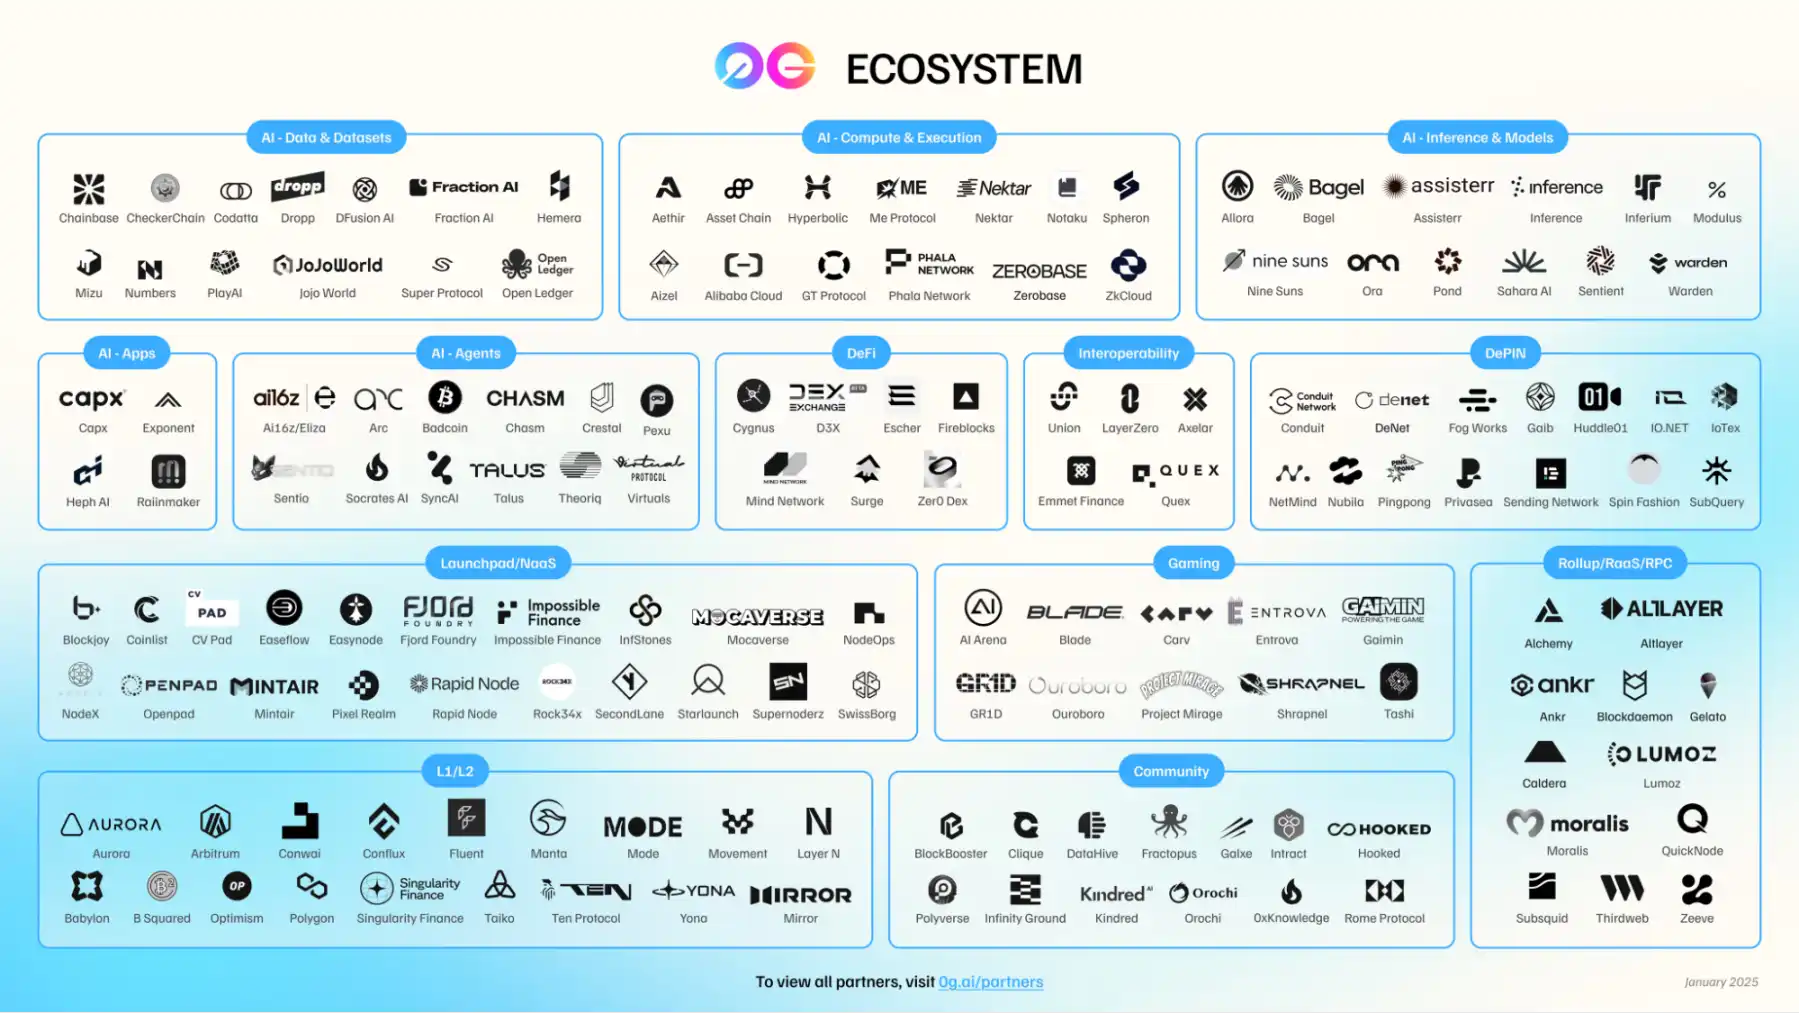
0G 생태계 그래픽
동시에 0G 재단은 8888만 달러 규모의 생태 기금을 출시하여 AI 관련 프로젝트의 개발을 지원하고 있으며, 다음과 같은 일부 네이티브 애플리케이션이 등장했습니다.
· zer0:AI 드라이븐 DeFi 유동성 솔루션으로, 온체인 유동성 최적화 서비스를 제공
· H1uman:탈중앙화된 AI 에이전트 공장으로, 확장 가능한 AI 통합 작업 흐름을 만듬
· Leea Labs:다중 AI 에이전트 인프라로, 안전한 다중 에이전트 시스템 배포 지원
· Newmoney.AI:스마트한 DeFi 대리지 지갑으로, 투자 및 거래를 자동화함
· Unagi:AI 드라이븐 온체인 엔터테인먼트 플랫폼으로, 애니메이션과 게임의 Web3 경험을 융합함
· Rivalz:검증 가능한 AI 오라클로, 스마트 계약에 신뢰할 수 있는 AI 데이터 액세스를 제공함
· Avinasi Labs:장수 연구에 초점을 맞춘 AI 프로젝트
참여 방법
일반 사용자는 현재 다음 방법으로 0G 생태계에 참여할 수 있습니다:
· 0G 테스트넷 상호 작용 참여: 0G는 테스트넷 V3(Galileo v3)를 출시했으며, 사용자는 공식 테스트넷 페이지(0G Testnet Guide)를 방문하여 테스트 토큰을 받고 0G 체인 상의 DApp에서 상호 작용할 수 있습니다.
· Kaito 이벤트 참여: 0G는 현재 Kaito 플랫폼의 콘텐츠 제작 이벤트에 참여했으며, 사용자는 기술 분석, 생태 발전 또는 AI 응용 사례와 관련된 고품질 콘텐츠를 작성하여 공유하여 보상을 받을 수 있습니다.
도전과 전망
0G는 저장 영역에서 강력한 기술 능력을 보여주었으며, 탈중앙화된 저장을 위한 완벽한 모듈화된 솔루션 세트를 제공하여 우수한 확장성과 경제성을 갖추었습니다(저장 비용은 1TB 당 10-11 달러로 매우 낮음). 동시에 0G는 데이터 가용성 층(DA)을 통해 데이터의 검증 가능성 문제를 해결하여, 미래 대규모 AI 추론 및 훈련 작업에 견고한 기초를 마련했습니다. 이러한 설계는 탈중앙화된 AI가 데이터 저장층에서 강력한 지원을 받을 수 있도록 하였으며, 개발자에게 최적화된 저장 및 검색 경험을 제공했습니다.
성능 측면에서, 0G는 메인넷 TPS가 3,000에서 10,000 범위로 증가하여, 성능이 이전에 비해 10배 향상되어 네트워크가 AI 추론 및 고빈도 거래와 같은 고강도의 계산 요구 사항을 충족할 수 있도록 보장했습니다. 그러나, 연산력 시장 및 모델에서 0G는 더 많은 발전을 이루어야 합니다. 현재 0G의 연산력 비즈니스는 아직 AI 추론 서비스로 한정되어 있으며, 모델 훈련 작업을 지원하기 위해서는 더 많은 맞춤형 설계와 기술 혁신이 필요합니다. AI 발전의 핵심 구성으로, 모델과 연산력은 제품 업그레이드 및 대규모 응용을 촉진하는 핵심이면서, 0G가 최대 AI Layer 1 생태계로 발전하는 데 필수적인 과정입니다.
요약
현재 상황: 다양한 진입, 도전에 직면
위에서 살펴본 6개의 AI Layer1 프로젝트는 각각 AI 자산, 연산능력, 모델, 저장 등 핵심 요소를 중심으로 다른 진입점을 선택하고, 분산형 AI 인프라와 생태계 구축의 길을 모색하고 있습니다:
· Sentient: 분산형 모델 개발에 초점을 맞추어 Dobby 시리즈를 출시하며, 모델의 신뢰성, 일치성, 충성을 강조하며, 하부 체인 개발은 여전히 진행 중이며, 모델과 체인 간의 심층적인 통합을 실현할 예정입니다.
· Sahara AI: AI 자산 소유권 보호를 핵심으로 데이터의 소유권 및 유통에 초점을 맞추며, AI 생태계에 신뢰할 수 있는 데이터 기반을 제공하기 위해 노력하고 있습니다.
· Ritual: 연산능력의 분산형 추론에 대한 효율적인 실현 방안을 중심으로, 블록체인 자체의 기능을 강화하고, 시스템의 유연성과 확장성을 향상시켜 AI 네이티브 애플리케이션 발전을 지원하고 있습니다.
· Gensyn: 분산형 모델 훈련 과제를 해결하기 위해 대규모 분산 훈련 비용을 낮추기 위한 기술 혁신을 추구하여, AI 연산능력 공유 및 민주화에 실행 가능한 길을 제공하고 있습니다.
· Bittensor: 상대적으로 성숙한 서브넷 플랫폼으로, 토큰 보상 및 분산형 거버넌스를 통해 다양한 개발자와 애플리케이션 생태계를 선도적으로 구축하여, 분산형 AI의 초기 모범 사례입니다.
· 0G: 분산형 저장을 시작으로, AI 생태계의 데이터 저장 및 관리 과제에 집중하며, 점진적으로 더 포괄적인 AI 인프라 및 애플리케이션 서비스로 확장하고 있습니다.
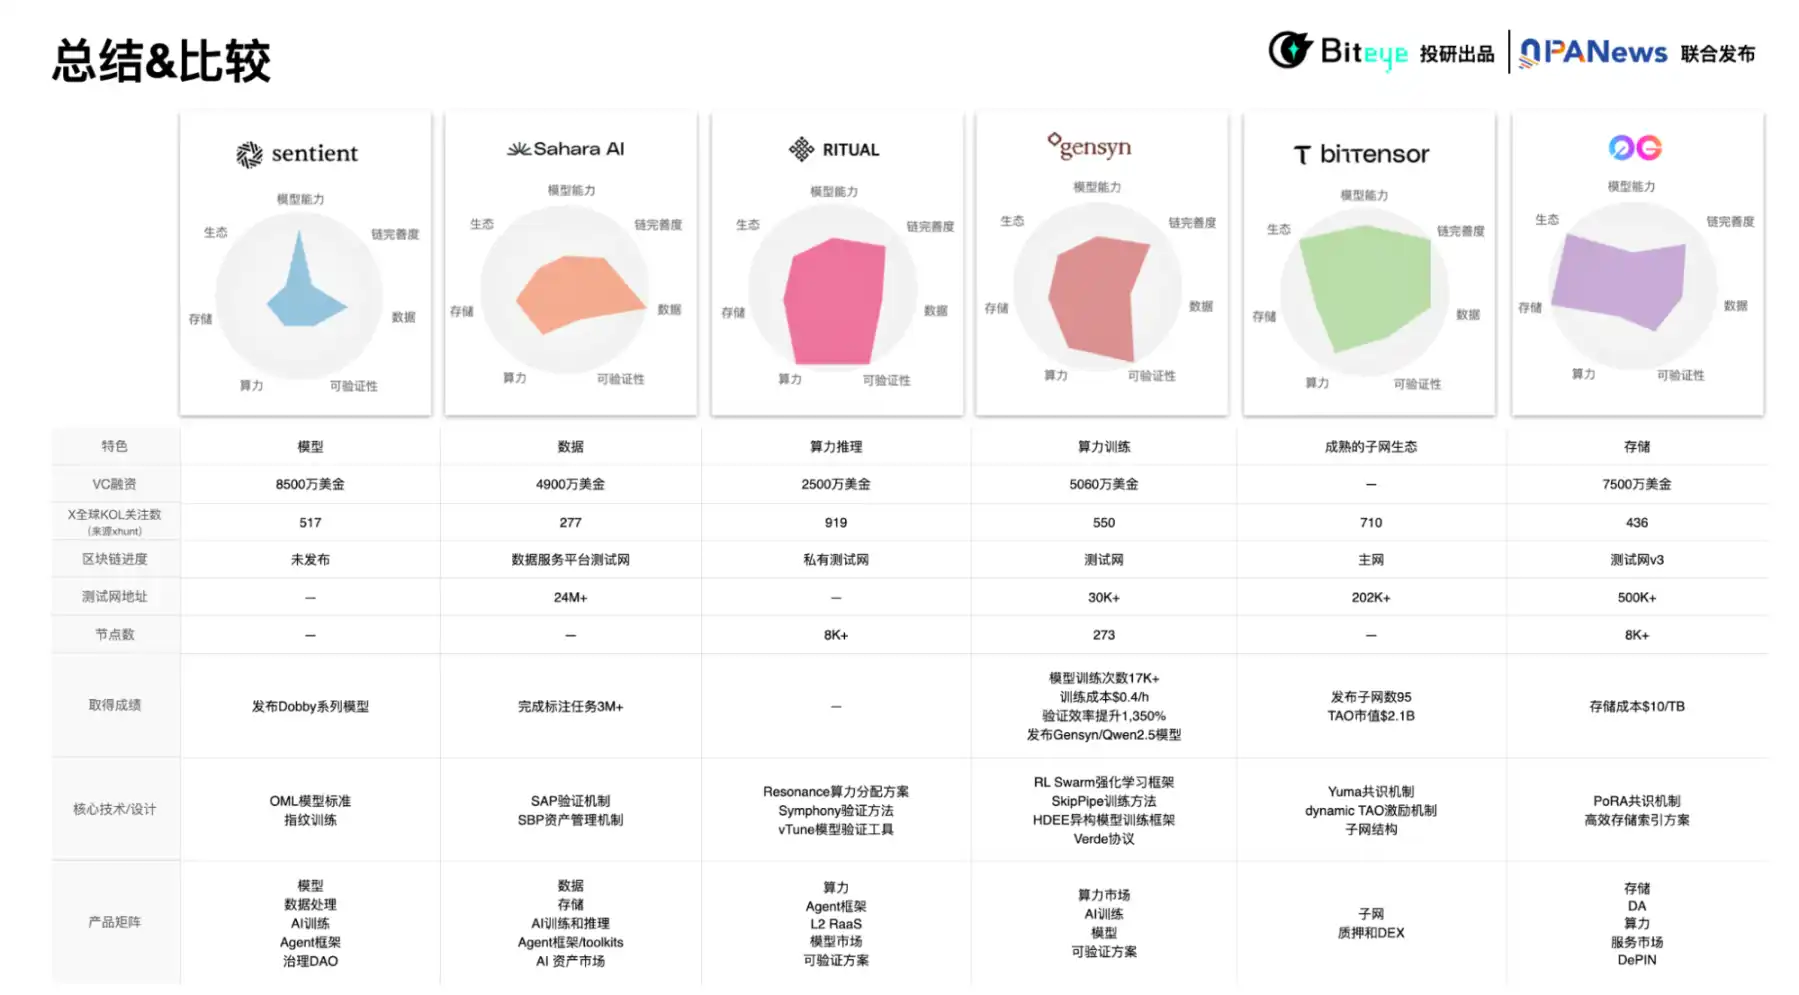
프로젝트 비교 및 요약
전체적으로, 이러한 프로젝트들은 기술적인 경로의 차이 뿐만 아니라 생태 전략의 상호 보완을 갖추고 있어, 체인 상 분산형 AI 생태의 다양성 발전을 촉진하고 있습니다. 그러나 인정할 수밖에 없는 것은, 전체 레이스가 여전히 초기 탐색 단계에 머물러 있다는 점입니다. 많은 선도적인 비전과 청사진이 제시되었지만, 실제 개발 진행 및 생태계 구축은 여전히 시간이 필요하며, 많은 핵심 인프라와 혁신적인 애플리케이션은 아직 실현되지 못한 상태입니다.
네트워크에 더 많은 연산능력, 저장 등 기본 노드가 참여하도록 유인하는 방법은 현재 핵심적인 해결과제입니다. 마치 비트코인 네트워크가 수십 년에 걸쳐 발전하여 본격적으로 주류 시장의 인정을 받았던 것처럼, 분산형 AI 네트워크도 노드 규모를 지속적으로 확장해야만 대규모 AI 작업의 연산 수요를 충족할 수 있습니다. 네트워크 내 연산능력, 저장 등 자원이 일정 수준으로 풍부해지면 비용을 효율적으로 낮출 수 있으며, 연산능력의 보급을 촉진하여, 최종적으로 분산형 AI의 웅장한 비전을 실현할 수 있을 것입니다.
또한 온체인 AI 응용프로그램은 혁신적인 측면에서 여전히 부족함이 존재합니다. 현재 많은 제품들이 여전히 Web2 모델을 기반으로 간단한 이주를 진행하고 있으며, 온체인 기본 메커니즘과 심층적으로 통합된 혁신적 디자인이 부족하여, 분산형 AI의 독특한 장점을 충분히 발휘하지 못하고 있습니다. 이러한 현실적인 도전은 우리에게 산업의 지속적인 발전이 기술적으로만 돌파하는 것뿐만 아니라, 사용자 경험의 향상과 전체 생태계의 지속적인 완성에도 의존함을 상기시켜줍니다.
지속적인 발전: AI Layer1 및 DeAI 우수 프로젝트가 계속 등장
이 위에서 보다 깊게 살펴본 프로젝트들 외에도 시대적 대세에 따라 AI Layer1 및 DeAI 분야에서 주목할 만한 새로운 프로젝트들이 존재합니다. (글자 수 제한으로 인해 여기서는 간략히 소개하겠지만, AI 트랙을 계속 추적하는 데 집중한 추가 투자 연구 콘텐츠를 주시하시기 바랍니다)
Kite AI
Kite AI는 핵심 합의 메커니즘 "Proof of Attributed Intelligence" (PoAI)를 기반으로 하여 EVM 호환 Layer 1 블록체인을 구축했으며, 공정한 AI 생태계를 구축하기 위해 노력하고 있습니다. Kite AI는 데이터 제공자, 모델 개발자 및 AI 에이전트 창작자가 AI 가치 창출에 기여한 내용이 투명하게 기록되고 공정하게 보상받을 수 있도록 하는 것을 목표로 하며, 소수의 기술 거물들에 의해 독과점된 AI 자원 구조를 깨는 데 기여하고 있습니다. 현재 Kite AI는 C 단말 응용층에 주력하고 있으며, 하위 네트워크 구조 및 거래 시장 등을 통해 AI 자산의 개발, 권리 보장 및 실현을 보장하고 있습니다.
Story
오픈 소스 지식 재산권 (IP)을 바탕으로 한 AI Layer 1을 구축하여, 창작자들과 개발자들에게 전체 프로세스 도구 세트를 제공하여, 영상, 오디오, 텍스트, 또는 AI 작품인 모든 내용 IP를 온체인에서 등록, 추적, 승인, 관리 및 활용할 수 있게 지원합니다. Story는 사용자가 창작한 콘텐츠를 NFT로 구현하고, 유연한 승인 및 수익 공유 메커니즘을 내장하여 사용자가 이창작과 상업 협력을 할 수 있도록 하고, 소유권과 수익 배분을 투명하고 추적 가능하게 보장합니다.
Vana
Vana는 "사용자 데이터 활용과 AI 교육"을 위해 설계된 신세대 데이터 기반 AI Layer 1입니다. Vana는 대기업의 데이터 독과점을 뛰어넘어 개인이 자신의 데이터를 실제 소유하고 관리하며 공유할 수 있도록 합니다. 사용자는 데이터 소유권을 유지한 채로 "데이터 DAO" (분산화 자체 지배 무료 인공지능 교육 데이터 공동체)를 통해 소셜, 건강, 소비 등 다양한 데이터를 수집하여 AI 교육에 사용하고 배당금에 참여할 수 있습니다. 또한 Vana는 개인정보 보호 및 안전에 중점을 두며, 사용자 데이터 보안을 위해 프라이버시 컴퓨팅 및 암호화 검증 기술을 채택하고 있습니다.
니리온
니리온(Nillion)은 데이터 프라이버시와 보안 계산에 특화된 '블라인드 컴퓨팅 네트워크'로, 개발자와 기업들에게 여러 개인 정보 보호 기술(MPC, Fully Homomorphic Encryption, Zero-Knowledge Proof 등)을 제공하여, 원본 데이터를 해독하지 않고 데이터의 저장, 공유, 복잡한 계산을 수행할 수 있습니다. 이를 통해 AI, 탈중앙화 금융(DeFi), 의료, 개인화 애플리케이션 등 다양한 시나리오에서 고가치 및 민감한 정보를 더 안전하게 처리할 수 있도록 하여 데이터 유출 위험을 우려하지 않아도 됩니다. 현재 니리온(Nillion) 생태계는 AI 프라이버시 계산, 개인화 지능체, 개인 지식 라이브러리 등 여러 혁신 애플리케이션을 지원하고 있으며, Virtuals, NEAR, Aptos, Arbitrum 등의 파트너를 유치하고 있습니다.
미라 네트워크
미라 네트워크(Mira Network)는 AI 출력에 대한 '탈중앙화 검증'을 위한 혁신적인 네트워크로, 자체 AI에 신뢰할 수 있는 검증 레이어를 제공하기 위해 설계되었습니다. 미라(Mira)의 핵심 혁신은 통합 평가 기술을 활용하여 여러 다른 언어 모델을 동시에 백그라운드에서 실행하고, AI 생성 결과를 구체적인 단언으로 분할한 뒤 분산 모델 노드에게 독립적으로 검증을 맡기며, 대부분의 모델이 합의에 도달하고 내용을 '사실'로 인정할 때에만 사용자에게 출력됩니다. 이러한 다중 모델 합의 메커니즘을 통해 미라(Mira)는 단일 모델의 25% 이상의 오류율을 3%로 현저히 낮출 뿐만 아니라, 오류율을 90% 이상 줄인 것과 동일합니다. 미라(Mira)는 중앙화된 대기관 또는 단일 대규모 모델에 대한 의존을 버리고, 분산 노드와 경제적 인센티브 메커니즘을 채택하여, 다양한 Web2 및 Web3 AI 애플리케이션에 대한 검증 가능한 기반 인프라 계층이 되어, AI 부지장, 자체 결정력과 신뢰 가능한 AI 시스템으로의 전환을 실현하고 있습니다.
프라임 인텔렉트
프라임 인텔렉트(Prime Intellect)는 탈중앙화 AI 학습 및 연산력 인프라에 중점을 둔 플랫폼으로, 전 세계의 컴퓨팅 리소스를 통합하여 오픈 소스 AI 모델의 협동 학습을 촉진하고 있습니다. 핵심 아키텍처에는 피어 투 피어 연산력 렌탈 마켓 및 오픈 트레이닝 프로토콜이 포함되어 있어, 누구나 네트워크에 유휴 자원을 기여하여 대규모 모델 학습 및 추론에 활용할 수 있으며, 전통적인 중앙 집중화, 높은 진입 장벽 및 자원 낭비 문제를 완화시킵니다. 동시에 프라임 인텔렉트(Prime Intellect)는 오픈소스 분산 학습 프레임워크(예: OpenDiLoco)를 개발하여, 수십 억 개의 파라미터 대규모 모델의 다지역 효율적인 학습을 지원하며, 알고리즘 혁신과 특수 트랙에 초점을 맞추어, 메타 유전체(METAGENE-1)와 수학적 추론(METAGENE-1)과 같은 프로젝트를 기획하고 있습니다. 2025년에는 프라임 인텔렉트(Prime Intellect)가 SYNTHETIC-1 계획을 출시하여, 크라우드소싱과 강화학습을 활용하여, 전 세계 최대 규모의 오픈 소스 추론 및 수학 코드 검증 데이터셋을 구축하고 있습니다.
미래 전망: 개방적이고 상생적인 탈중앙화 AI
다수의 난관에도 불구하고, 온체인 탈중앙화 AI는 여전히 광활한 발전 가능성과 혁신 잠재력을 지니고 있습니다. 기술 기반의 성숙과 각 프로젝트의 약속 이행이 계속되는 가운데, 탈중앙화 AI의 독특한 장점이 더욱 부각될 전망이며, AI Layer1은 다음과 같은 비전을 실현하기를 희망합니다:
· 계산력, 데이터 및 모델의 민주화 공유는 기술 독점을 깨고, 전 세계의 개인, 기업 및 기관이 AI 혁신에 장벽 없이 참여할 수 있도록 합니다.
· AI 자산의 소유권 유통과 신뢰할 수 있는 거버넌스는 데이터, 모델 등 핵심 자산이 온체인에서 자유롭게 이동하고 거래되도록 하며, 소유자의 수익을 보장하여 건강한 개방형 생태계를 형성합니다.
· 더욱 신뢰할 수 있고 추적 가능하며 조정 가능한 AI 출력은 AI의 안전하고 통제 가능한 발전을 견고히 지원하며, '악의적 AI'의 위험을 효과적으로 줄입니다.
· 산업 응용의 보편적 실현은 금융, 의료, 교육, 콘텐츠 제작 등의 분야에서 AI의 거대한 가치를 발휘하여, AI가 탈중앙화 방식으로 사회에 실질적인 이익을 주도하도록 합니다.
더 많은 AI Layer1 프로젝트들이 진전함에 따라, 탈중앙화 AI의 목표가 조속히 이루어질 것으로 기대하며, 보다 많은 개발자, 혁신가 및 참여자들이 참여하여 더 개방적, 다양하고 지속 가능한 AI 생태계를 공동으로 구축하기를 희망합니다.
BlockBeats 공식 커뮤니티에 참여하세요:
Telegram 구독 그룹:https://t.me/theblockbeats
Telegram 토론 그룹:https://t.me/BlockBeats_App
Twitter 공식 계정:https://twitter.com/BlockBeatsAsia







