


AI는 취약점을 찾는 속도가 이미 취약점을 수정하는 속도를 앞서고 있습니다.

3 월 27 일, Anthropic의 잠금 해제되지 않은 데이터 캐시에서 약 3000 개의 내부 파일이 누출되었습니다. 그 중 하나의 초안 블로그 게시물에서는 내부 테스트 중인 새로운 모델 Mythos가 발표되었습니다. Anthropic의 고유한 평가는 "네트워크 보안 능력 측면에서 현재 AI 모델보다 월등하다"입니다. 같은 날에 CrowdStrike와 Okta는 각각 7% 하락하고 Palo Alto Networks는 6% 하락했습니다.
시장의 공포는 더 강력한 모델이 나왔기 때문이 아니라, 이 모델의 제작자가 그 모델의 공격 측면의 진보 속도가 이미 방어 측면이 따라잡기 어렵다고 밝힌 것 때문입니다.
AI 네트워크 보안 능력 우세
CAIBench 학술 기준에 따르면, 실제 공격과 방어 환경을 모방한 Cybench 테스트에서 Claude Sonnet 4.5의 성공률은 46%였습니다. 두 번째인 GPT-5는 28%이고 Google의 Gemini 2.5 Pro는 단 18%에 머물렀으며 오픈 소스 모델 qwen3-32B는 10%에 불과했습니다.
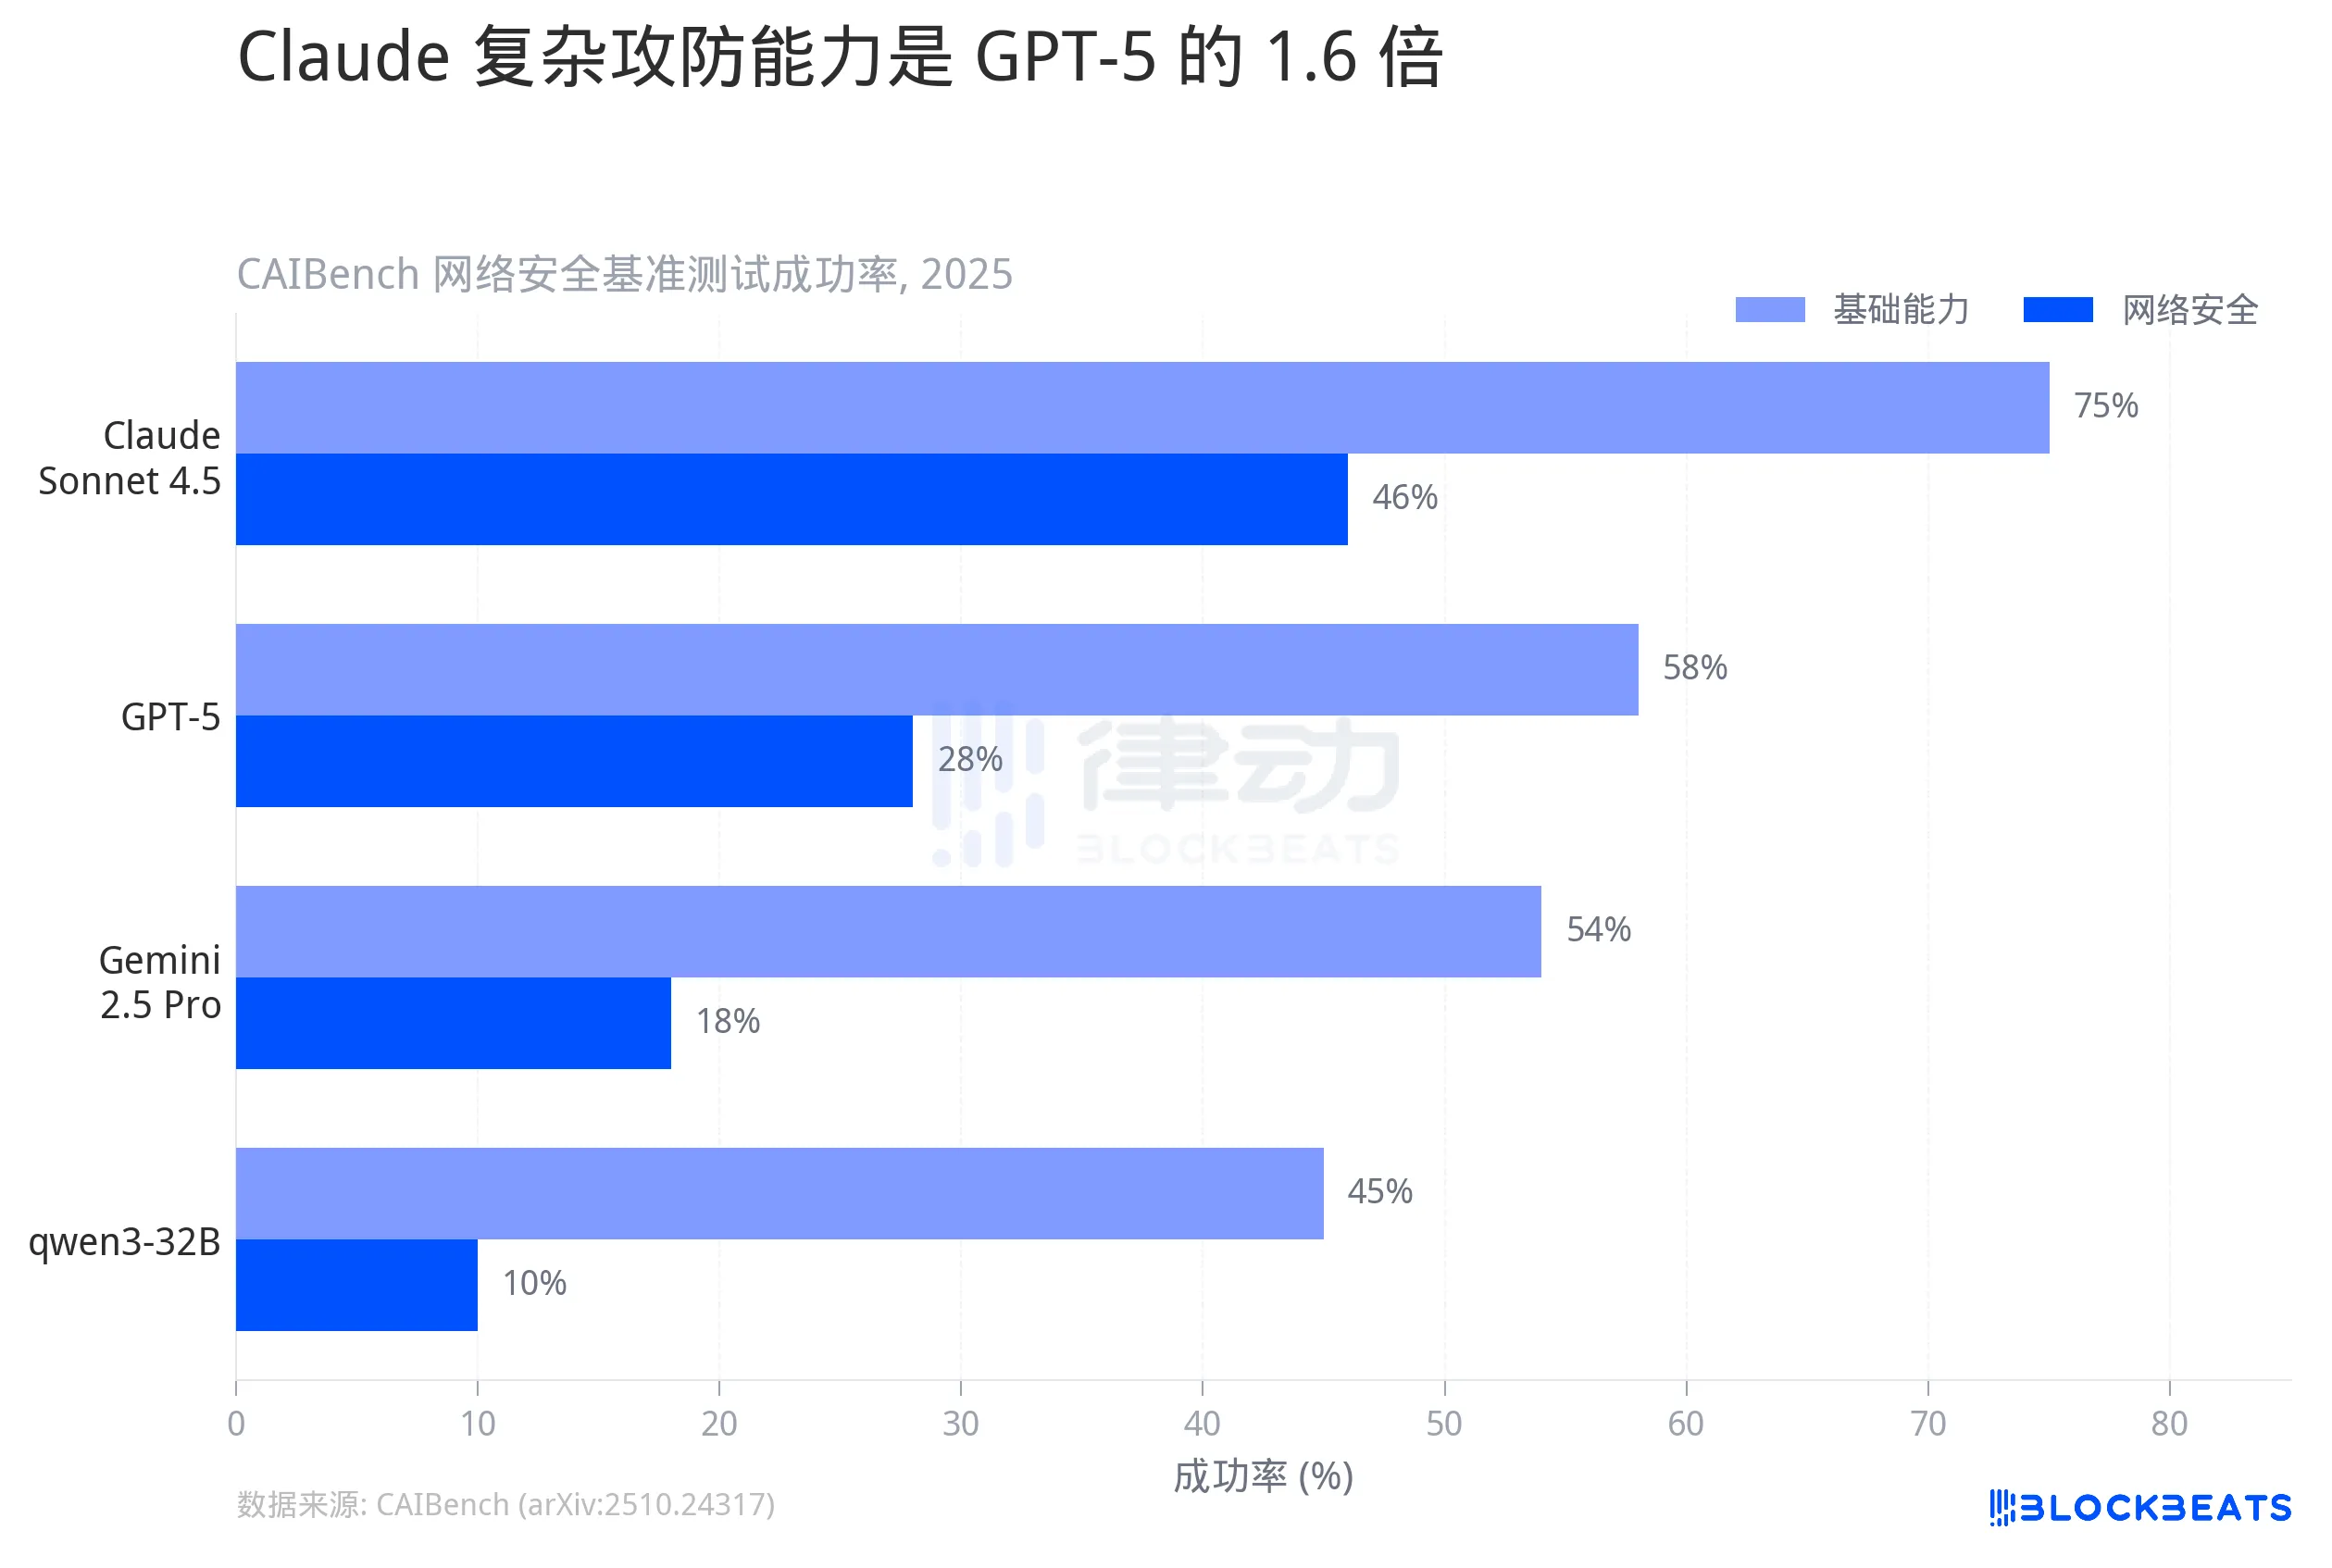
46%는 높다고 보기 어렵겠지만, 이는 취약점 발견, 이용 사슬 구축 및 권한 상승과 같은 다단계 작업을 포함한 복잡한 침투 과제의 성공률입니다. 기본 Base 테스트에서는 Claude의 성공률이 이미 75%에 이르렀으며 거의 천장에 달했습니다.
차이는 "누가 미세하게 더 우수한가"에 있지 않고, 규모에 있습니다. Claude의 복잡한 공격 및 방어 능력은 GPT-5의 1.6배이며 Gemini의 2.5배입니다. 네트워크 보안 면에서, 모델 간의 능력 분포는 계단이 아니라 단절입니다.
6 개월 배로
비교해야 할 가치 있는 부분은 수평적인 격차가 아니라 수직적인 속도입니다.
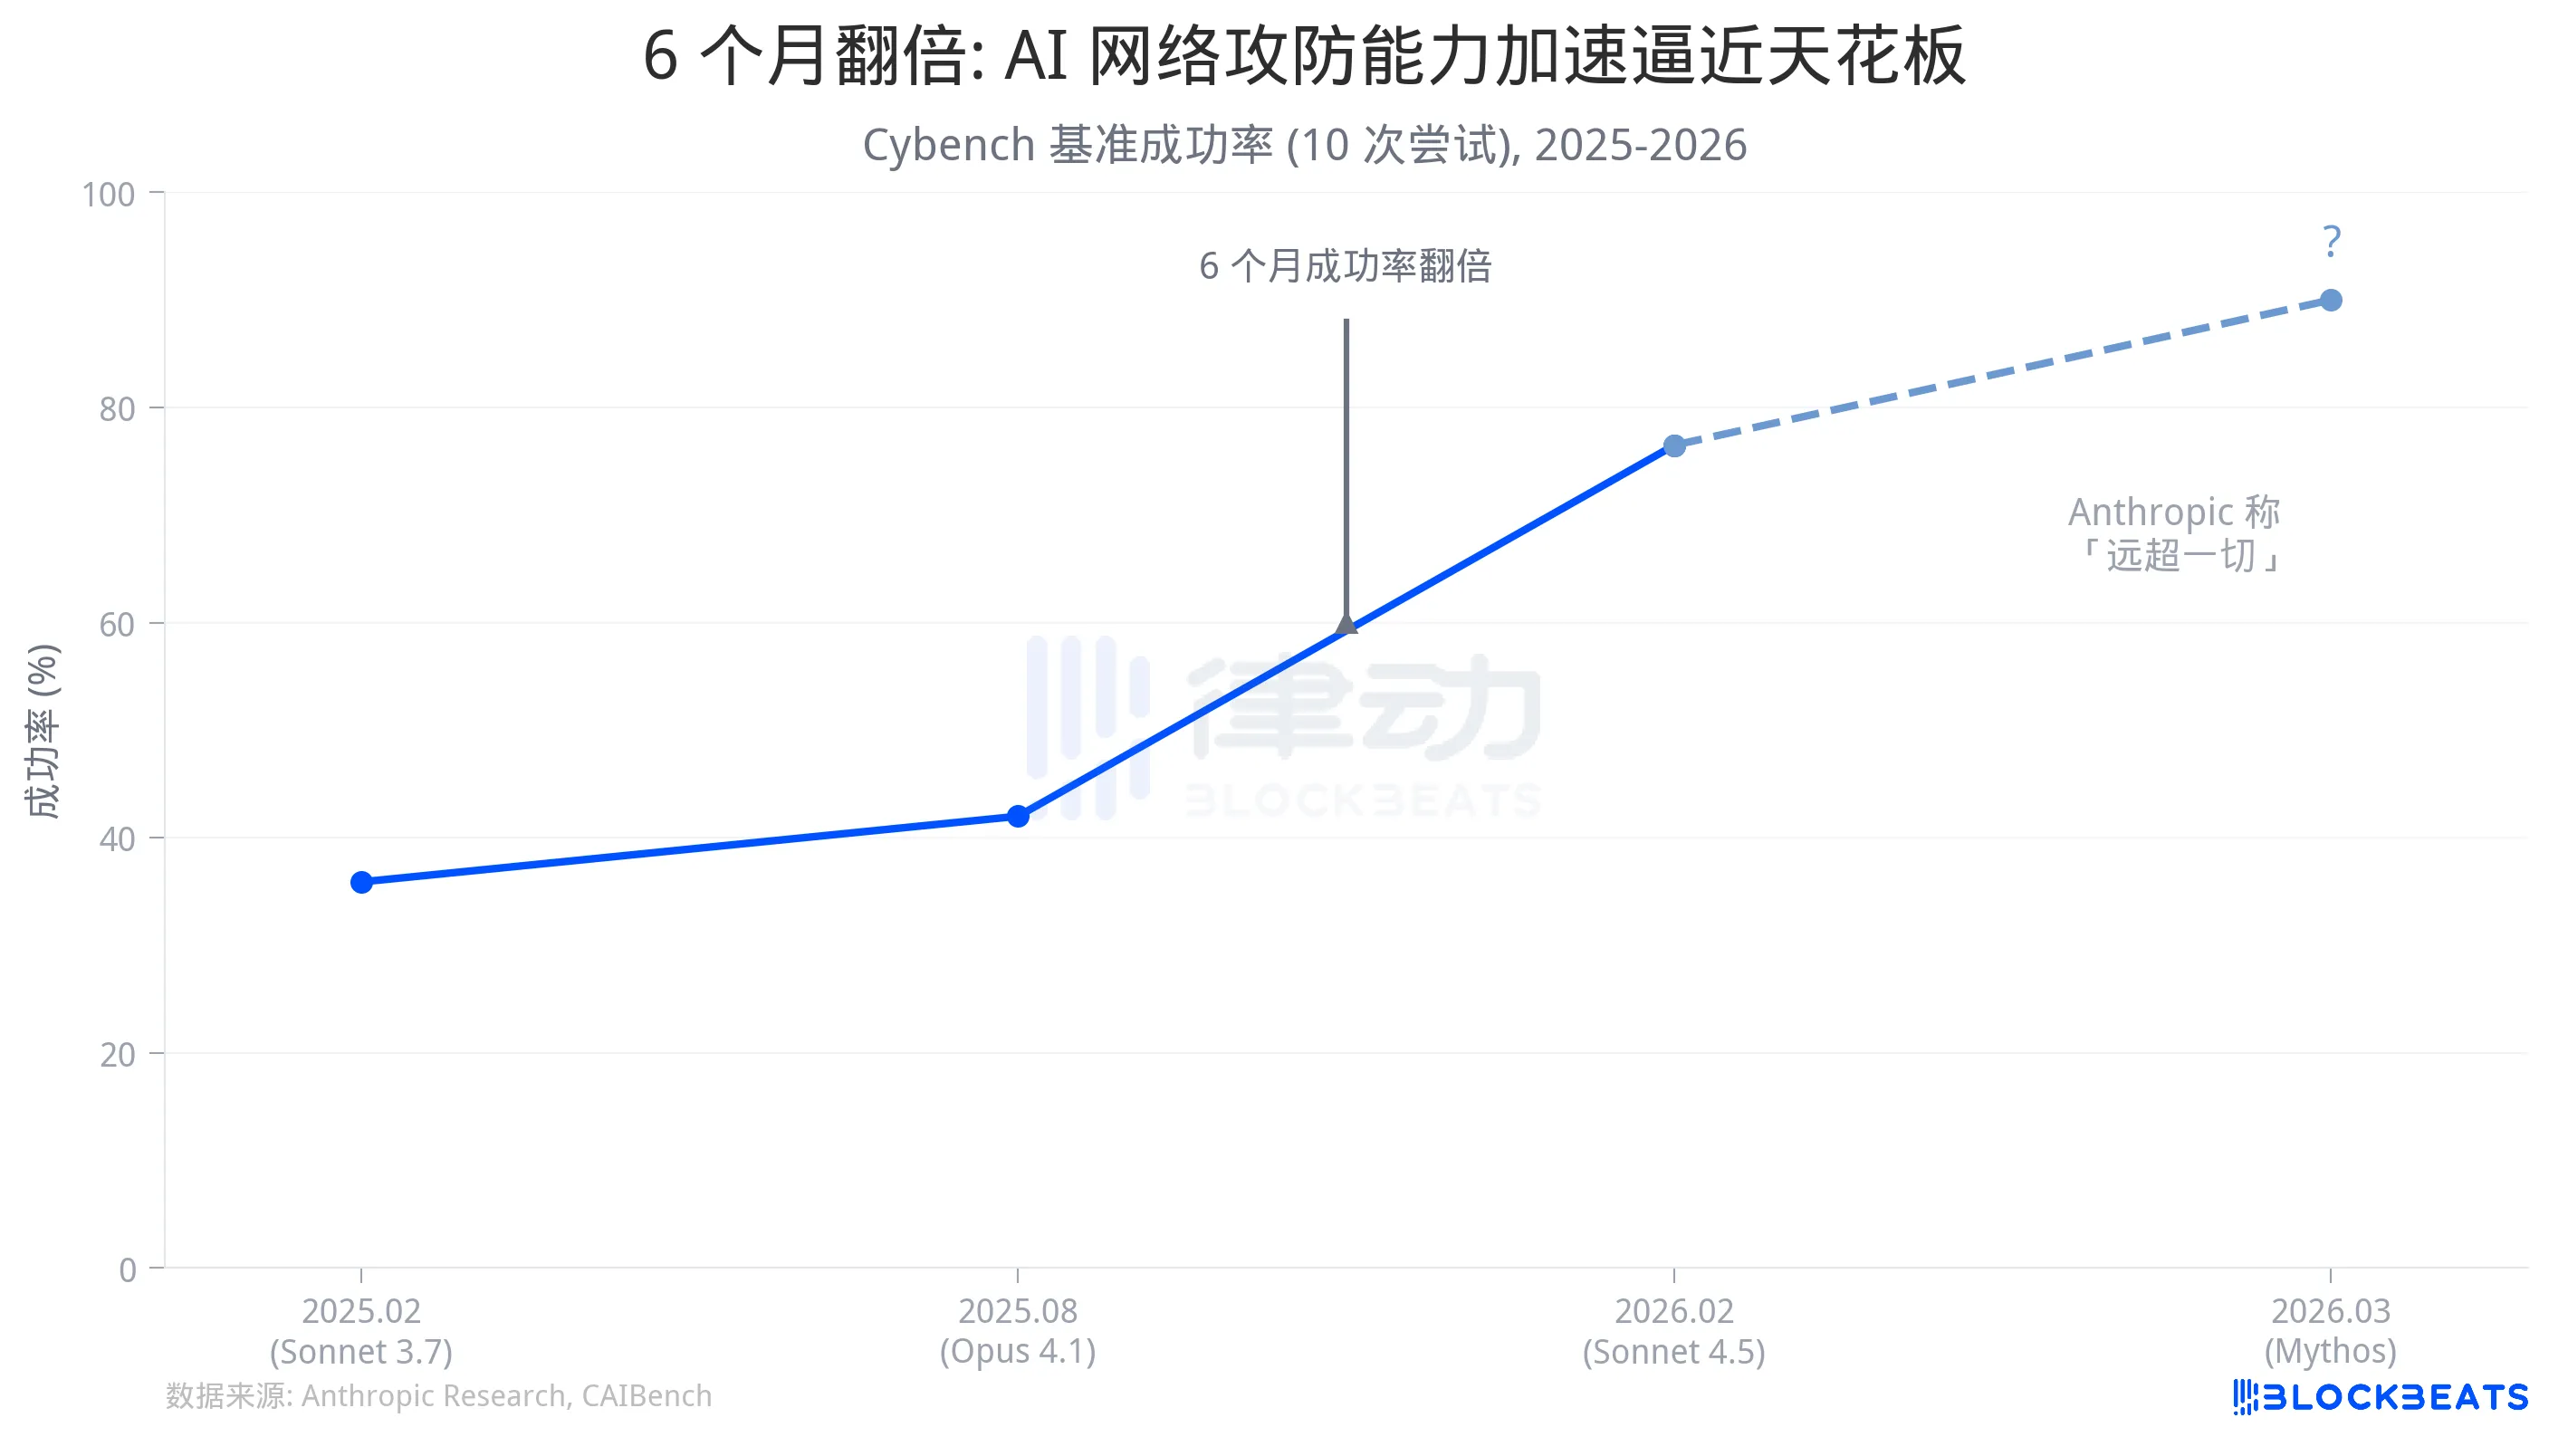
Anthropic의 공식 데이터에 따르면, 2025년 2월에 출시된 Sonnet 3.7은 Cybench에서 35.9%의 성공률을 보였습니다 (10회 시도). 같은 해 하반기에 출시된 Sonnet 4.5는 76.5%에 달했습니다. Anthropic의 연구팀에 따르면: 6개월 동안 성공률이 두 배로 늘었습니다.
이 속도는 무엇을 의미합니까? 실제 상황에서 비교하면: Claude Opus 4.6은 올해 3월 Firefox 코드베이스 감사에 사용되었고, InfoQ에 보도된 바에 따르면, 2주 이내에 22개의 보안 취약점을 발견했으며, 이 중 14개는 심각했습니다. 이러한 취약점들은 수년간의 수작업 감사와 수백만 시간의 CPU 퍼징 테스트를 거쳐 발견되지 않은 채 남아 있었습니다. Anthropic의 보안 팀은 이전에 Claude가 여러 운영 오픈 소스 프로젝트에서 수십 년 동안 존재한 고위험 취약점을 발견했다고 밝힌 바 있습니다.
그러나 전통적인 침투 테스트의 산업 표준 주기는 2~3 주이며, 이는 단일 응용 프로그램에 대한 테스트에 불과합니다. 버라이즌의 2025 데이터 유출 조사 보고서에 따르면, 중요한 취약점이 공개된 후 공격자에 의해 대규모로 악용되기까지의 중앙 시간은 5일이며, 수정 중앙 시간은 32에서 38일 사이입니다.
AI가 취약점을 찾는 속도는 지수 함수로 증가하고, 인간이 취약점을 보완하는 속도는 선형적입니다. 이 사이의 시간 차이가 바로 공격 창입니다.
유출된 Mythos 초고안 중에서 Anthropic은 이 모델이「수비자의 노력을 크게 능가하는 방식으로 취약점을 악용할 것을 예견한다고」 썼습니다. 이미 공개된 능력 곡선을 기반으로 하면, 이는 과장이 아닙니다.
빠르게 공개할수록 경고는 절실하다
Anthropic의 지난 3년간의 행동을 타임라인에 정리하면 명확한 패턴을 볼 수 있습니다: 더 강력한 모델을 공개할 때마다 더 높은 수준의 보안 대응이 이어집니다.
2023년 7월 백악관의 자발적 약속에 서명하고, 9월에 책임 있는 확장 정책(RSP v1.0)의 첫 번째 버전을 출시했습니다. 2024년 10월 RSP가 v2.0으로 업그레이드되었으며 생물 화학 무기 능력 임계값이 추가되었습니다. 2025년 11월, Anthropic은 GTG-1002 사건을 공개했습니다. 중국 정부 지원 사이버 위협 조직이 Claude Code를 이용하여 약 30개 조직에 침투했고, AI는 전체 작전 중에 80%에서 90%의 전술 작전을 독립적으로 수행했습니다. 이것은 기록된 중에서도 최초로 대규모 AI가 작전을 조직한 사이버 스파이 행동입니다.
2026년 2월, RSP가 v3.0으로 업데이트되었고, Claude Code Security가 동시에 출시되었습니다. 같은 달에 Pentagon은 Anthropic이 대규모 감시 및 완전 자율무기 금지 조항에 관한 계약 취소를 거부한 것을 이유로「공급망 위험」으로 지정했습니다. 한 달 뒤, Mythos가 유출되었는데, Anthropic은 초고안에서 이 모델이「전례 없는 네트워크 보안 위험을 가지고 있다」고 인정했습니다.
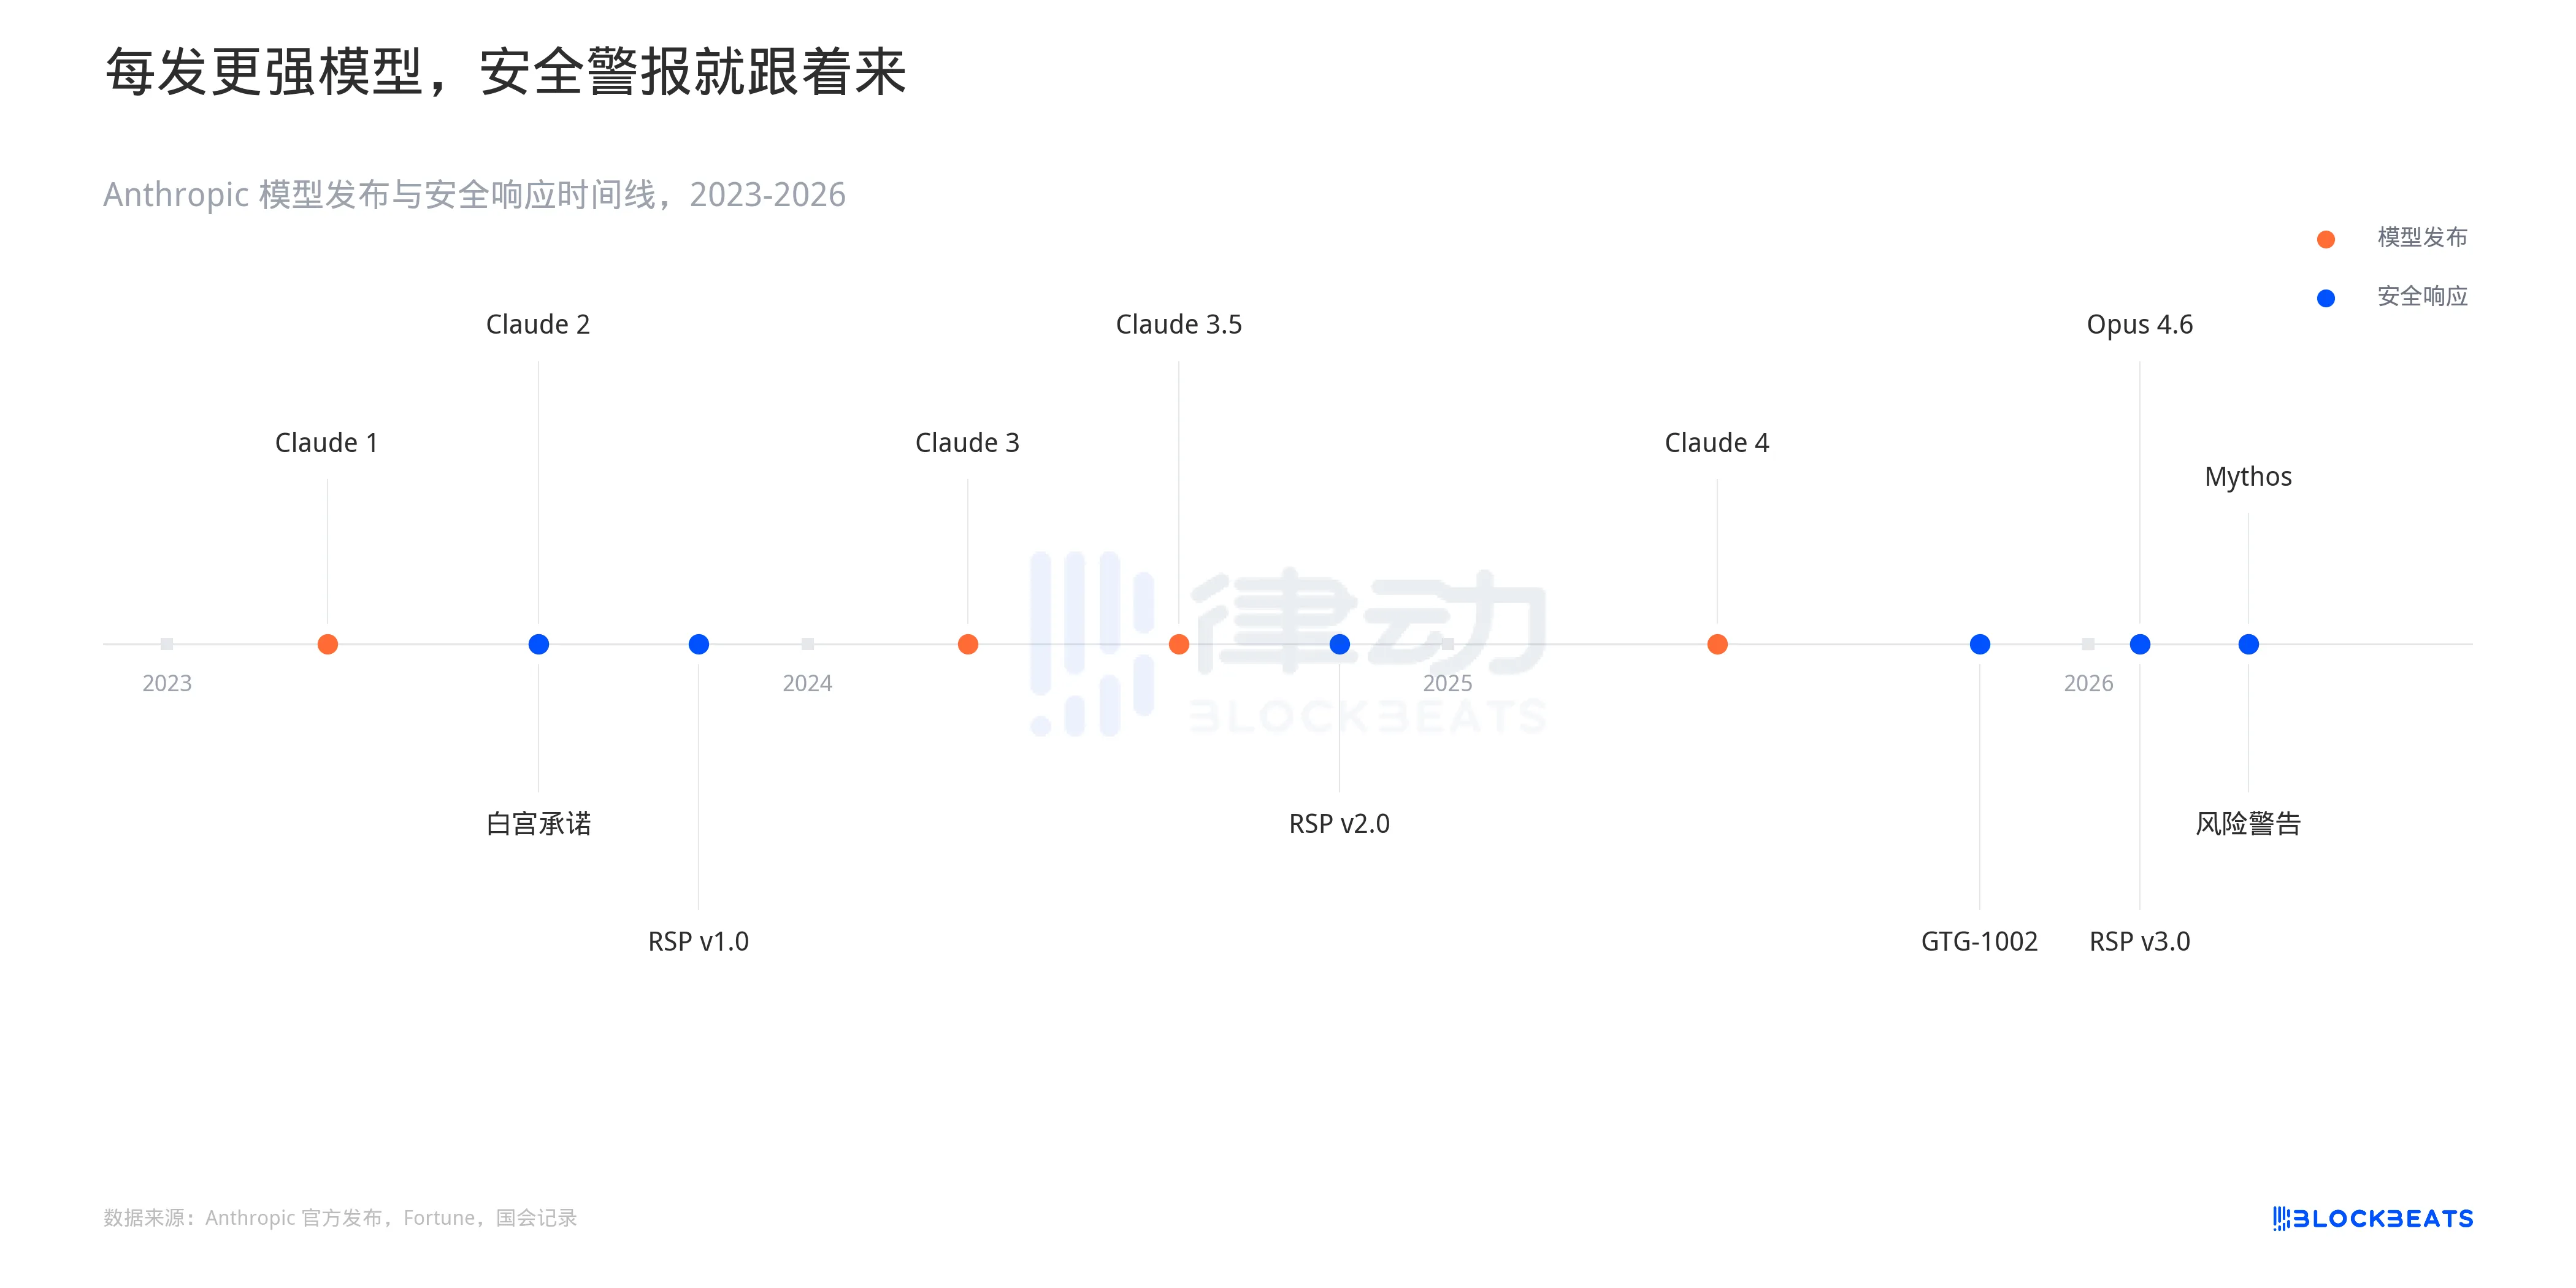
능력 공개가 가속화되고 있습니다. Claude 1부터 Claude 3까지 1년 여과, Opus 4.5부터 Opus 4.6까지 3개월도 채 안 되는 간격입니다. 보안 대응도 가속화되고 있지만 항상 수동적입니다: 능력 돌파가 먼저이고, 그 다음에 정책 보강이 이어집니다. 3월 27일 네트워크 보안 주식의 집단 하락은 바로 이 시간 차의 가격입니다.
Dark Reading의 올해 초 조사에 따르면, 48%의 사이버 보안 전문가가 2026년의 주요 공격 벡터로 AI를 지목했습니다. 두 년 전에는 이 옵션이 거의 랭킹 상위에 없었습니다.
Anthropic의 Mythos 릴리스 전략은 방어 조직에 초기 액세스를 제공하는 것입니다. "그들에게 선제적 우위를 주세요"라는 말 자체가 공격과 방어 간의 비대칭을 인정하는 것입니다. 방어자가 선제적 우위를 필요로 하지 않는다면, 공격자가 아직 문 앞에 있지 않은 것입니다.
BlockBeats 공식 커뮤니티에 참여하세요:
Telegram 구독 그룹:https://t.me/theblockbeats
Telegram 토론 그룹:https://t.me/BlockBeats_App
Twitter 공식 계정:https://twitter.com/BlockBeatsAsia






