구글 AI 논문, 스토리지 900억 달러를 발표했습니다, 실험 조작으로 비난받음
원문 제목: "구글 AI 논문이 저장소 주식 900 억 달러를 분쇄하며 실험 위조 혐의에 처해짐"
원문 출처: 딥다이브 TechFlow
지난 주에 발표된 구글의 하나의 논문이 "AI 메모리 사용량을 1/6로 압축"한다고 주장했으며, 이는 미크론, SanDisk 등 세계적인 저장소 칩 제조업체 주식의 총액이 900 억 달러 이상 줄었습니다.
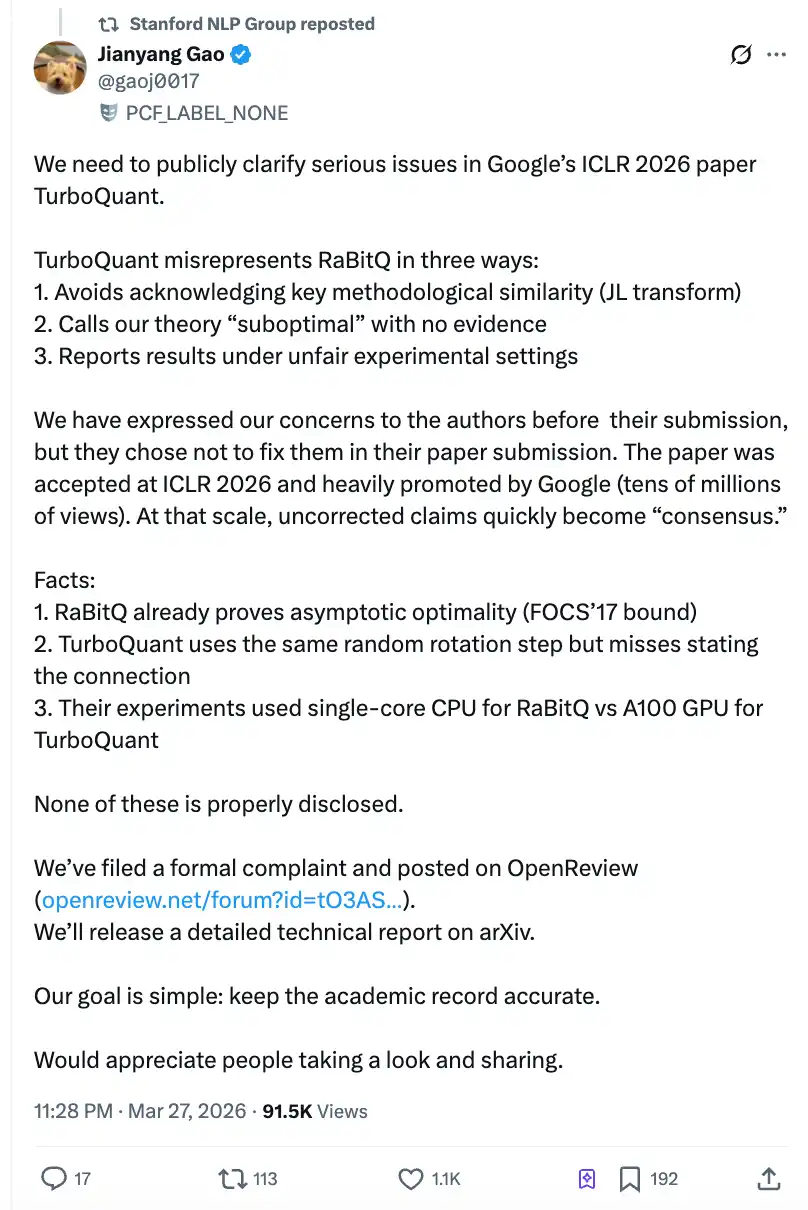
그러나 논문이 발표된 후 2일 만에, 이 알고리즘이 압도한 공정인 스위스 연방 공과대학 포스튜더 후속 연구원 고건양이 긴 글 형식의 공개 편지를 발표하여, 구글 팀이 실험에서 상대방을 테스트하기 위해 단일 코어 CPU의 Python 스크립트를 사용하고 자신을 테스트하기 위해 A100 GPU를 사용하며, 투고 전에 문제에 대해 이미 알려진 후에도 수정을 거부했다고 주장했습니다. 지식인에서 빠르게 조회수가 4백만을 넘어섰으며, 스탠퍼드 NLP 공식 계정이 공유하면서 학계와 시장이 동시에 놀라워했습니다.
이 논쟁의 핵심 문제는 복잡하지 않습니다: 구글의 공식적으로 대규모로 홍보되어 전 세계적인 칩 산업을 공포에 빠트린 AI 최고 학회 논문이, 이미 발표된 선행 연구를 고의적으로 왜곡하고, 부당한 실험을 통해 가짜 성능 우위를 만들어낸 것인가요?
TurboQuant가 한 일: AI의 "드래프트지"를 6분의 1로 압축
대형 언어 모델이 답변 생성 시, 예전에 계산한 내용을 다시 참조해야합니다. 이러한 중간 결과는 일시적으로 메모리에 저장되며, 이를 업계에서 "KV Cache" (Key-Value Cache)라고합니다. 대화가 길어질수록 이 "드래프트지"는 더 두꺼워지며, 메모리 사용량과 비용이 증가합니다.
구글 연구팀이 개발한 TurboQuant 알고리즘의 핵심 포인트는이 "드래프트지"를 원래의 1/6로 압축하는 것으로, 정확도 손실 없이 추론 속도가 최대 8배 향상된다고 주장합니다. 이 논문은 2025년 4월에 첫 학술 프리프린트 플랫폼 arXiv에 게재되었으며, 2026년 1월에는 AI 분야의 최고 권위있는 학회 ICLR 2026에서 허가를 받았으며, 3월 24일에 구글 공식 블로그에서 다시 패키징되어 홍보되었습니다.
기술적으로, TurboQuant의 접근 방식은 간단히 말해 다음과 같습니다: 혼돈된 데이터를 일정한 형식으로 변환한 다음, 미리 계산된 최적의 압축 표를 사용하여 한 개씩 압축하고, 마지막으로 1비트 오류 수정 메커니즘을 사용하여 압축으로 인한 계산 편향을 보정합니다. 커뮤니티에 의해 독립적으로 구현된 것으로 확인된 압축 효과는 사실입니다. 알고리즘 수학적 공헌이 실재한다.
토론의 핵심은 TurboQuant가 작동하는지 여부가 아니라 구글이 그것이 '경쟁 상대를 움켜잡을 정도로 우수하다'를 증명하기 위해 무엇을 했는가에 있습니다.
고건양 공개 서신: 세 가지 혐의, 이는 핵심을 찌르다
3월 27일 오후 10시, 고건양은 지금 긴 글을 게재하고, 동시에 ICLR 공식 심사 플랫폼 OpenReview에 공식 평가를 제출했습니다. 고건양은 RaBitQ 알고리즘의 주요 저자로, 이 알고리즘은 2024년 데이터베이스 분야의 최상위 학회인 SIGMOD에 발표되었으며, 동일한 종류의 문제를 해결하는 고차원 벡터의 효율적인 압축을 다룹니다.
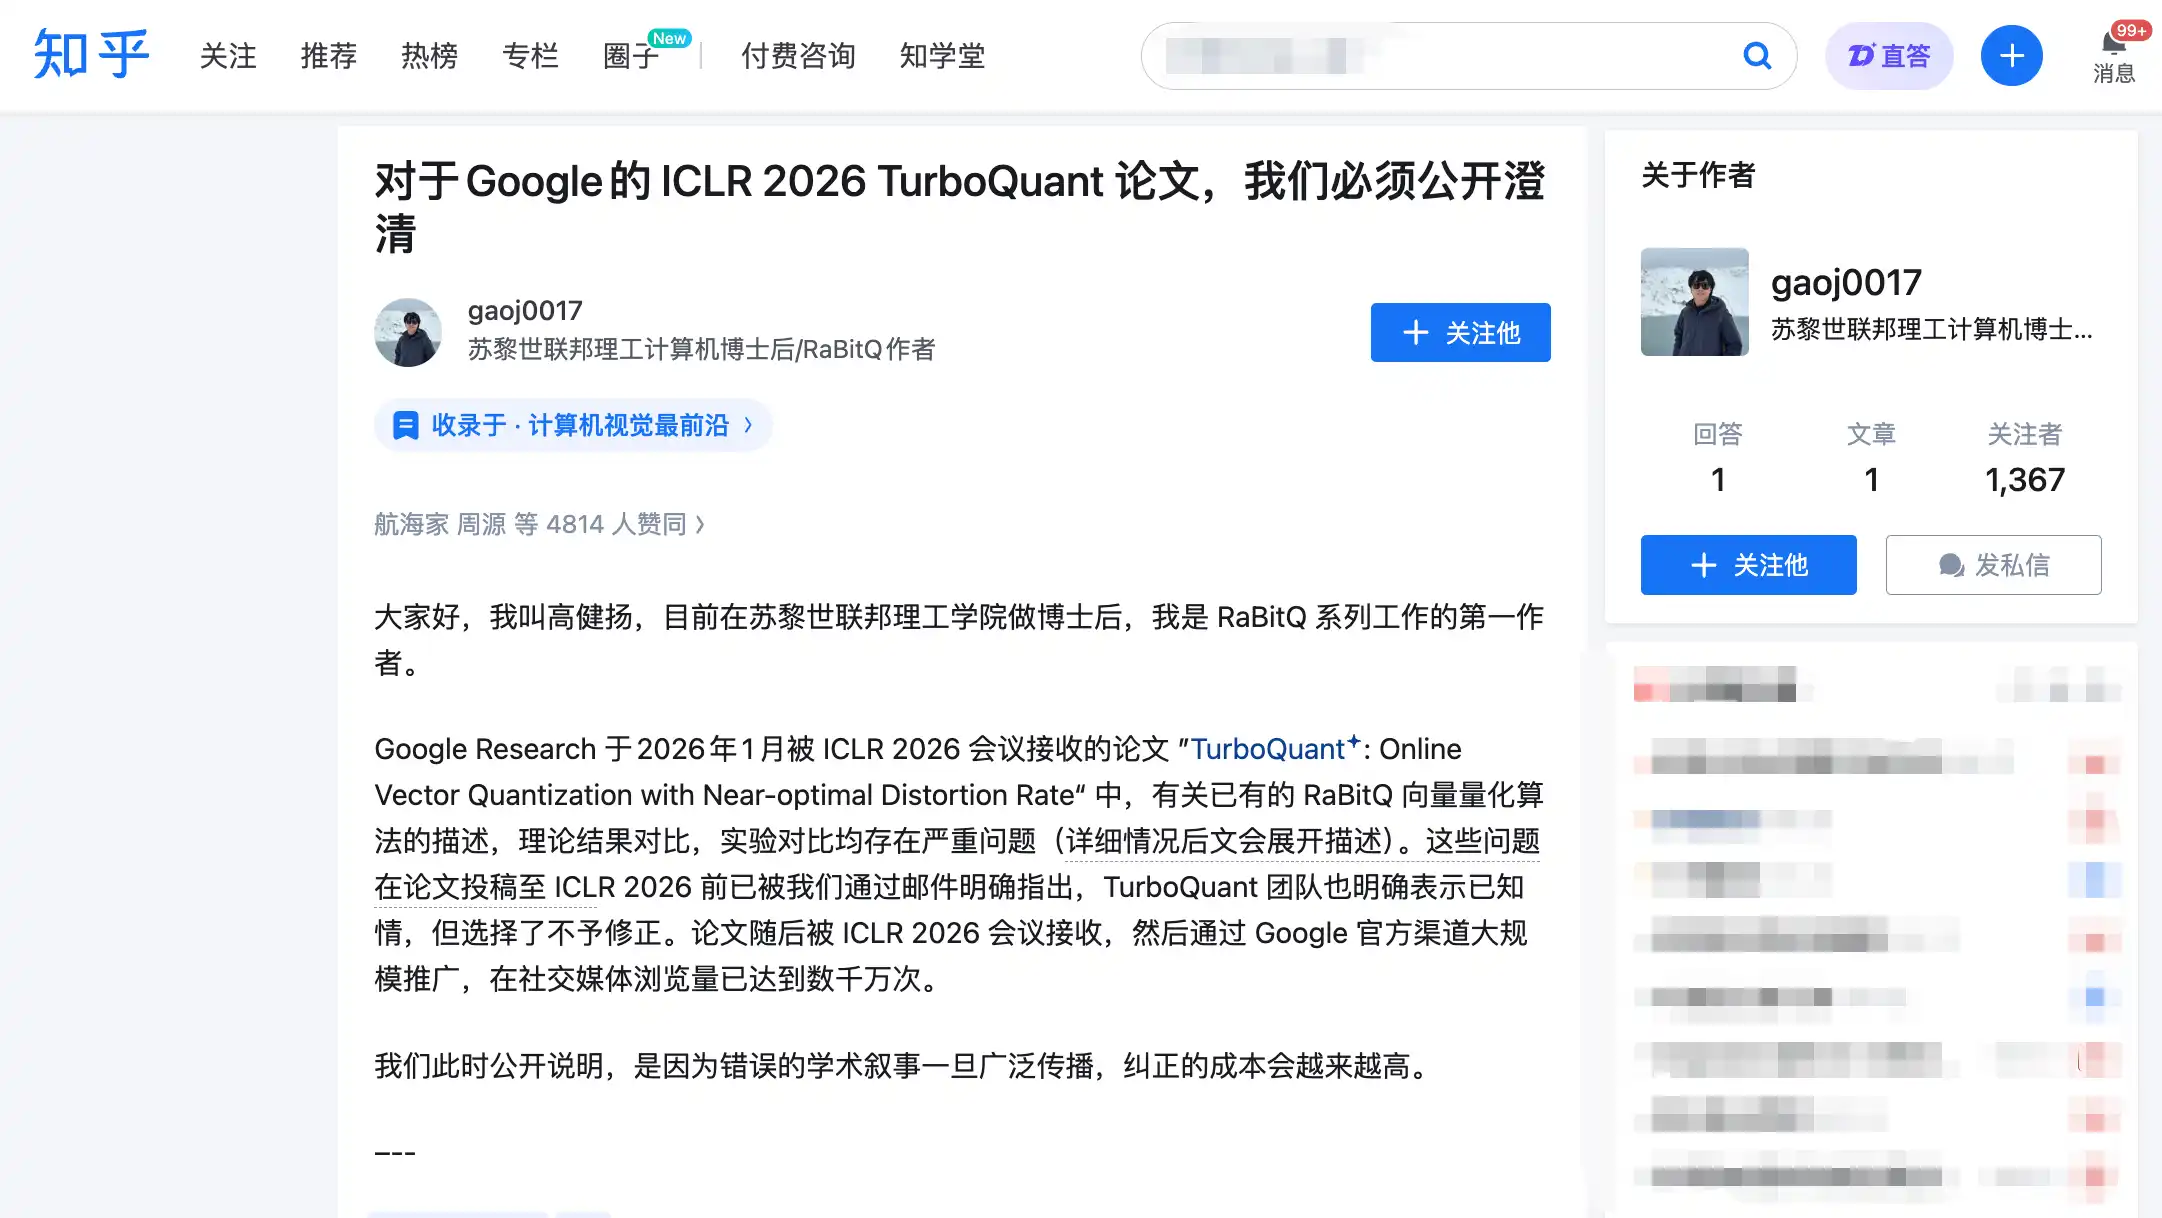
그의 혐의는 세 가지로 나뉘며, 각각에는 이메일 기록과 시간표 증거가 있습니다.
혐의 1: 다른 사람의 핵심 방법을 사용했지만 전혀 언급하지 않음.
TurboQuant와 RaBitQ의 기술 핵심에는 핵심적인 공통 단계가 있습니다: 데이터를 압축하기 전에 데이터를 한 번 '랜덤하게 회전'하는 것입니다. 이 단계는 데이터의 불규칙한 분포를 예측 가능한 균일 분포로 변환하여 압축 난이도를 크게 낮추는 역할을 합니다. 이것이 두 알고리즘의 가장 핵심적이고 가장 유사한 부분입니다.
TurboQuant의 저자는 심사에 대한 회신에서도 이것을 인정했지만 논문에서 이 방법이 RaBitQ와의 연관성을 긍정적으로 언급하지 않았습니다. 더 중요한 배경은 다음과 같습니다: TurboQuant의 두 번째 저자 Majid Daliri는 2025년 1월에 고건양 팀에 연락하여 RaBitQ 소스 코드를 수정한 Python 버전을 디버깅하는 데 도움을 요청했습니다. 이메일에는 재현 단계와 오류 메시지가 자세히 기술되어 있습니다. 다시 말하면, TurboQuant 팀은 RaBitQ의 기술 세부 사항을 매우 잘 이해하고 있습니다.
ICLR의 익명 심사자 한 명도 두 알고리즘이 동일한 기술을 사용했다고 독립적으로 지적하며 충분한 토론을 요구했습니다. 그러나 최종 논문에서 TurboQuant 팀은 토론을 보충하지 않았을 뿐만 아니라 초기 원고에서 RaBitQ에 대한(이미 불완전한) 설명을 부록으로 옮겼습니다.
혐의 2: 증거 없이 상대방 이론을 '하위'로 규정함.
TurboQuant 논문은 RaBitQ에 직접 '이론적으로 하위'라는 레이블을 붙였으며, 그 근거는 RaBitQ의 수학적 분석이 '매우 거칠다'라는 것입니다. 그러나 고건양은, RaBitQ 확장 논문이 이미 수학적으로 최적 경계에 도달했다는 엄격한 증명을 하였으며, 이 결론은 이론적 컴퓨터 과학의 최상위 학회에 발표되었습니다.
2025년 5월, 고건양 팀은 RaBitQ 이론의 최적성에 대해 상세히 이메일을 통해 설명했습니다. TurboQuant 두 번째 저자 Daliri는 모든 저자에게 통보되었다고 확인했습니다. 그러나 논문은 여전히 "하위 최적"이라는 표현으로 남아 있었고 반론 증거를 제시하지 않았습니다.
지목 세 번: 실험 대조에서의 "왼손에는 묶인 상태로, 오른손에는 칼을 든 채" 입니다.
이것은 텍스트의 가장 치명적인 부분입니다. 고건양은 강조했습니다. TurboQuant 논문은 속도 비교 실험에서 공정하지 않은 두 가지 조건을 겹쳐놓았습니다:
첫째, RaBitQ 공식은 최적화된 C++ 코드를 제공했지만 TurboQuant 팀은 사용하지 않고 자체 번역한 Python 버전을 사용하여 RaBitQ를 테스트했습니다.
둘째, RaBitQ를 테스트할 때는 단일 코어 CPU를 사용하고 멀티 스레드를 비활성화했지만 TurboQuant은 NVIDIA A100 GPU를 사용했습니다.
이러한 두 가지 조건의 결합 효과는: 독자가 본 결론은 "RaBitQ가 TurboQuant보다 수십 배 느리다"이지만 이 결론이 얻어졌던 가정이 구글 팀이 상대방의 손과 발을 묶은 상태로 경주를 한다는 것을 알 수 없습니다. 논문은 이러한 실험 조건의 차이를 충분히 공개하지 않았습니다.
구글의 대응: "임의 회전은 일반 기술이며 각 논문마다 인용할 수 없다"
고건양에 따르면, TurboQuant 팀은 2026년 3월 이메일 답변에서 "임의 회전 및 Johnson-Lindenstrauss 변환의 사용은 이미 이 분야의 표준 기술이며, 이러한 방법을 사용한 각 논문을 인용할 수 없습니다."라고 밝혔다.
고건양 팀은 이것이 개념을 혼동시키는 것이라고 판단했다: 문제는 임의 회전을 사용한 모든 논문을 인용해야 하는지 여부가 아니라 RaBitQ가 완전히 동일한 문제 설정에서 이 방법을 먼저 사용하고 최적성을 입증한 작업임에도 불구하고 TurboQuant 논문이 두 방법의 관계를 정확히 기술해야 한다는 것입니다.
스탠포드 NLP 그룹의 공식 X 계정이 고건양의 발언을 전달했습니다. 고건양 팀은 ICLR OpenReview 플랫폼에 공개 코멘트를 남기고 ICLR 총회 의장 및 윤리 위원회에 공식 불만을 제기했으며, 추가 조치로 arXiv에 상세한 기술 보고서를 게시할 예정입니다.
독립 기술 블로거 Dario Salvati는 분석에서 상대적으로 중립적인 평가를 제공했습니다. TurboQuant는 수학적 접근 방식에서 실질적인 기여를 했지만 RaBitQ와의 관련성은 논문에서 설명한 것보다 훨씬 밀접합니다.
900 억 달러 시가총액 소멸: 논란의 논문이 시장 공포에 겹쳐져
이 학술 논란이 발생한 시기는 매우 미묘합니다. Google은 3월 24일 공식 블로그를 통해 TurboQuant를 발표한 후, 전 세계 저장 칩 섹터가 격렬한 매도 압력을 받았습니다. CNBC 등 여러 매체에 따르면 미크론 기술은 연속 6거래일 하락하여 누적 하락률이 20%를 넘었으며; SanDisk의 일일 하락폭은 11%에 이르렀으며; 한국 SK하이닉스는 약 6% 하락하며, 삼성전자는 거의 5% 하락했으며, 일본의 가이젠은 약 6% 하락했습니다.시장 공포의 논리는 단순히 축약 소프트웨어가 AI 추론 메모리 요구량을 6배로 줄일 수 있는데, 저장 칩의 수요 전망이 구조적으로 하향 조정될 것이라는 것입니다.
모건 스탠리의 분석가 Joseph Moore은 3월 26일 연구 보고서에서 이 논리를 반박하며 미크론과 SanDisk의 "매수" 평가를 유지했습니다. Moore은 TurboQuant가 단지 KV Cache라는 특정 종류의 캐시를 압축했을 뿐이며 전체 메모리 사용량이 아니라고 지적하며 이를 "정상적인 생산성 향상"으로 규정했습니다. 공국 은행 분석가 앤드루 로차 또한 제비첸스 역설을 인용하여, 효율성 향상으로 인한 비용 감소가 오히려 더 큰 규모의 AI 배포를 자극할 수 있으며, 결국 메모리 수요를 끌어올릴 수 있다고 주장했습니다.
옛 논문, 새 포장: AI 연구에서 시장 서사 전달 체인 리스크
기술 블로거 벤 폴라디안에 따르면 TurboQuant 논문은 이미 2025년 4월에 공개적으로 발표되어 새 연구가 아님을 보였습니다. 3월 24일 구글이 공식 블로그를 통해 다시 포장하고 홍보하는 동안 시장은 이를 새로운 첩보로 인식하고 가격을 매겼습니다. 이러한 "옛 논문, 새로운 출시" 홍보 전략은 논문의 실험 편향이 존재할 수 있다고 하며, AI 연구가 학술 논문에서 시장 서사로 전달되는 연쇄의 시스템적 위험을 반영합니다.
AI 기반 인프라 투자자에게 있어서, 논문이 "여러 배의 성능 향상"을 달성했다고 주장할 때, 먼저 비교 기준 조건이 공정한지 살펴봐야 합니다.
고건양 팀은 문제의 공식적인 해결을 계속 추진할 것이라고 명확히 밝혔습니다. 구글 측은 공개 편지의 구체적인 지적에 대한 공식적인 응답을 아직 내놓지 않았습니다.
BlockBeats 공식 커뮤니티에 참여하세요:
Telegram 구독 그룹:https://t.me/theblockbeats
Telegram 토론 그룹:https://t.me/BlockBeats_App
Twitter 공식 계정:https://twitter.com/BlockBeatsAsia