5분 만에 AI를 당신의 두뇌의 두 번째 부분으로 만들어 보세요
원문 제목: Claude Code + Obsidian 궁극의 안내서 (AI 두뇌 만들기)
원문 작성자: AI Edge
번역: Peggy, BlockBeats
편집자 주: 본문은 Claude Code 및 Obsidian을 기반으로 한 개인 지식 시스템을 소개하며, 핵심은 더 이상 전통적인 RAG 모델의 "매번 쿼리, 임시 검색" 사용이 아니라 AI가 지속적으로 발전 가능한 위키를 구축 및 유지하려는 시도입니다.
구조적으로 시스템은 세 가지 계층으로 나뉠 수 있습니다:
· 첫째, 원시 데이터 계층은 노트, 기사, 트랜스크립트 콘텐츠 등 수정할 수 없는 입력 소스를 포함합니다.
· 둘째, AI가 유지 보수하는 구조화된 지식베이스는 지속적인 업데이트를 통해 교차 참조 및 관계 구축을 완료합니다.
· 셋째, Schema 규칙 계층은 지식의 조직 방식 및 시스템 운영 논리를 표준화하는 데 사용됩니다.
이 구조 주변에 시스템은 세 가지 핵심 작업을 통해 작동합니다: Ingest(흡수), 외부 정보를 지속적으로 시스템에 통합합니다; Query(쿼리), 지식을 즉시 호출합니다; Lint(검사), 구조 일관성을 확인하고 잠재적인 문제를 해결합니다.
이 메커니즘에 따르면, 지식은 더 이상 일회성 대화 결과에 머물지 않고 "쓰기 - 정리 - 재활용"의 순환을 통해 점진적으로 재사용 가능한 장기 자산으로 축적됩니다. 이러한 패턴은 지식이 "복리"와 유사한 누적 효과를 갖게 함으로써, 개인의 인식 부담을 줄이고 모델 출력의 정확성과 맥락 일관성을 향상시키는 것으로 제안되었습니다.
그러나 이러한 시스템의 효율적인 운영은 계속적인 입력 및 유지가 필요합니다. 만약 안정적인 데이터 주입 및 구조 업데이트가 부족하다면, 이러한 "두 번째 두뇌"는 진정한 누적 효과를 형성하기 어렵고, 그 이점도 약화될 것입니다.
다음은 원문입니다:
Claude Code + Obsidian은 제가 사용한 가장 강력한 AI 조합입니다.
저는 거의 "AI 두 번째 두뇌"를 구축했으며, 모든 사고, 독서, 글쓰기, 온라인 연구 등을 그 안에 편입했습니다. 여기에는 내 비즈니스 계획, 내가 게시한 모든 YouTube 비디오, 쓴 글뿐만 아니라 내게 중요한 모든 콘텐츠가 포함되어 있습니다.
Claude Code + Obsidian은 이미 각 플랫폼에서 신속하게 확산되었고, 이는 우연이 아닙니다.
개인적으로, 이 AI 시스템은 제 인지 부담을 크게 줄여주었고, 비즈니스든 개인 생활이든 진정으로 중요한 일에 집중할 수 있게 해주었습니다.
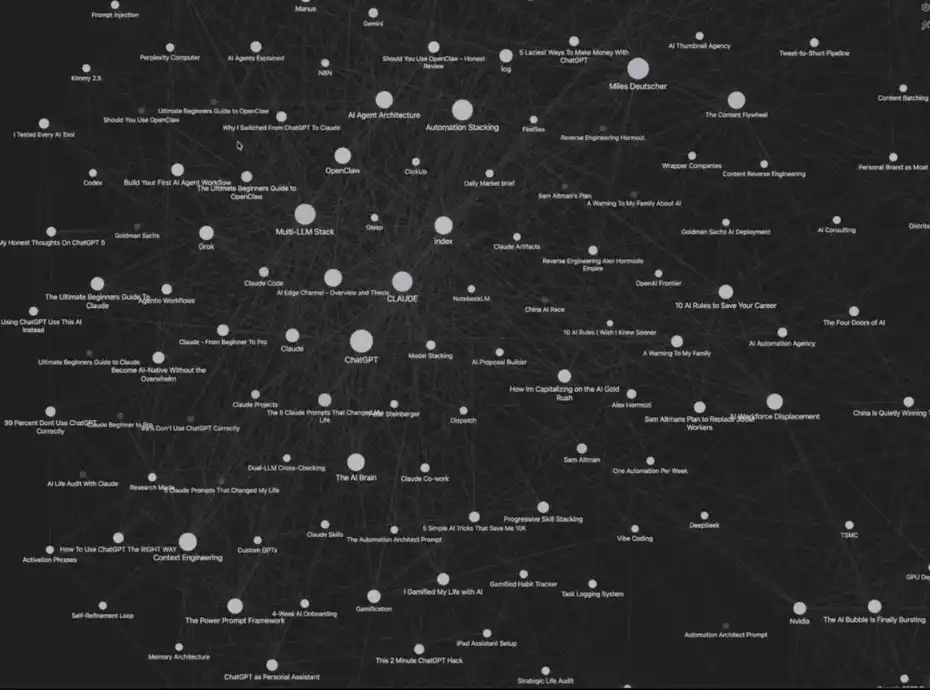
나의 Claude Code + Obsidian 시스템
이 시스템은 약간 복잡해 보일 수 있지만, 실제로 구축하는 데는 5분만 필요합니다. 그리고 무엇보다 중요한 것은, 그것이 스스로 최적화되는 기억 매커니즘을 갖고 있다는 것입니다.
다음으로, 이 시스템을 한 단계씩 따라하면서 「AI 두뇌」 시스템을 재현하는 데 당신의 효율성을 실제로 높일 수 있음을 확인할 것입니다.
글을 끝까지 읽는 것을 권장합니다. 나는 Claude Code + Obsidian 작업 요약표 및 언급된 모든 리소스 (모두 무료)를 함께 제공할 것입니다.
시작하기 전에
이 시스템은 제 개인이 원조가 아닙니다. 그 아이디어는 Andrej Karpathy가 며칠 전에 「LLM 지식베이스」에 대한 화제를 모은 트윗에서 영감을 받았습니다.
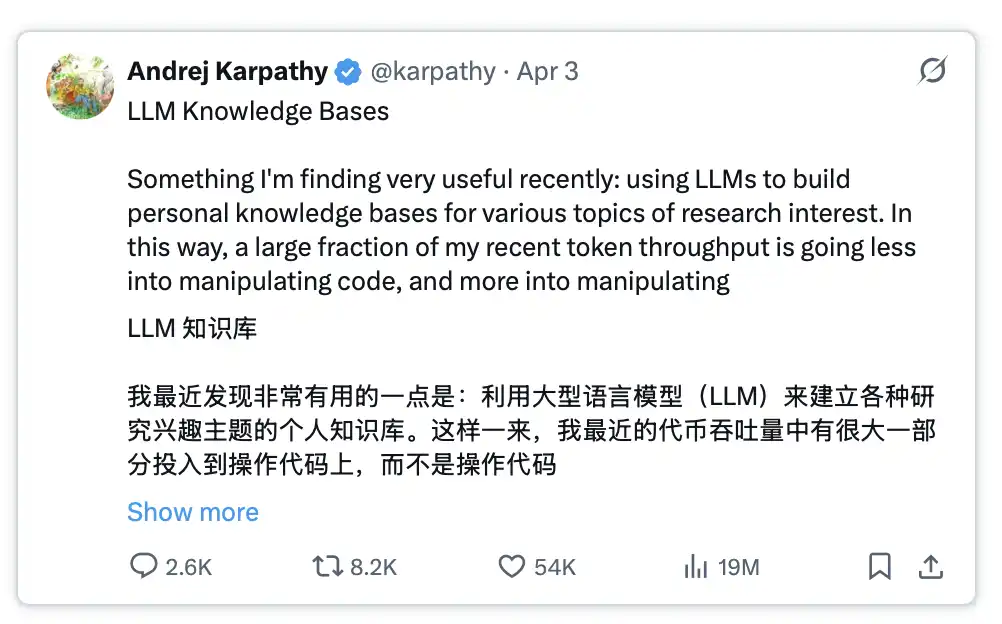
관련 링크: https://x.com/karpathy/status/2039805659525644595
이 트윗이 신속하게 확산된 이유는 현재 AI 개발에서의 중요한 문제에 대한 해결책을 제시했기 때문입니다.
그 문제는 다음과 같습니다: 새로운 대화를 시작하거나 새로운 AI 도구로 전환할 때마다 힌트 단어를 반복해서 입력하고 맥락을 보충해야 하므로 사실상 처음부터 다시 시작해야 한다는 것입니다.
그러나 이 시스템의 힌트 단어들을 Obsidian 및 Claude Code와 결합하면이 문제를 완전히 해결할 뿐만 아니라 AI의 출력 품질을 현저히 향상시킬 수 있습니다.
이 시스템은 어떻게 작동합니까?
이 시스템은 네 가지 핵심 모듈로 구성됩니다:
1. 당신의 데이터: 글, 노트, 트랜스크립트 콘텐츠, 아이디어 등이 포함됩니다.
2. 조직 방법: Obsidian 내에서 Claude Code를 통해 자동으로 구성됩니다.
3. 즉시 호출: 이 "데이터베이스"에 언제든지 질문하여 답변을 받을 수 있습니다.
4、진화 메모리: 시스템은 사용함에 따라 점점 더 똑똑해집니다
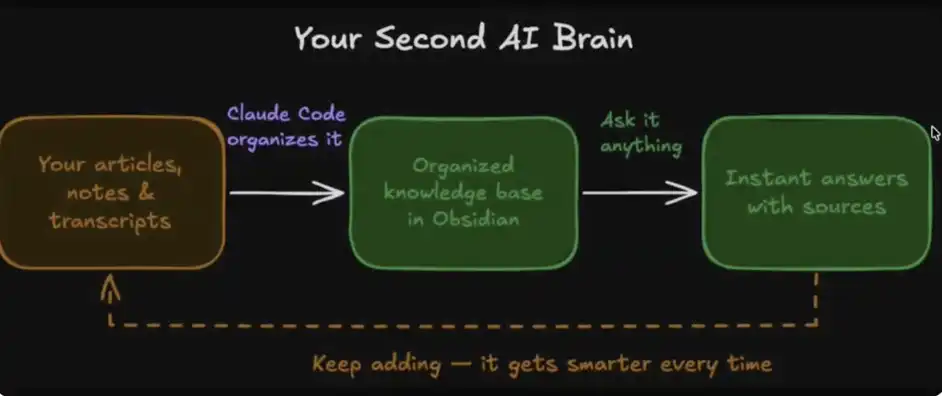
당신의 AI 두뇌
이 시스템 세트의 진정한 힘은 무엇인가요?
인간으로서, 우리의 인지 대역폭은 제한적입니다. 우리는 망각하고 때로는 서로 다른 아이디어를 연결하는 것이 어려울 때가 있으며, 추적하고 처리할 수 있는 정보는 결국 한계가 있습니다.
하지만 이 네 가지 모듈로 구성된 시스템을 활용하면 실제로는 자신의 인지 부담을 덜어주면서 "정보 연결, 정리 및 이해" 작업을 Obsidian과 Claude Code에 맡길 수 있습니다.
여러분의 아이디어는 체계적으로 연결되기 시작하며, 한 노트는 자동으로 다른 노트에 연결되며, 필요할 때는 언제든지 Claude를 통해 이러한 콘텐츠를 다시 추출, 조합 및 호출할 수 있습니다.
이러한 구조 속에서 여러분의 지식은 더 이상 분산되어 있지 않고, 계속해서 호출하고 재구성할 수 있는 네트워크로 변환됩니다 — 거의 제한이 없습니다.
5분 안에 당신의 AI 두뇌 구축하기
1、Obsidian 다운로드
공식 웹사이트: https://obsidian.md/
https://obsidian.md/
2、당신의 Vault(지식 저장소) 만들기
다운로드가 완료되면 Obsidian은 "Vault"를 만들라는 메시지를 표시합니다.
이는 컴퓨터 상의 폴더로 이해할 수 있으며, 여기에 모든 콘텐츠를 저장하고 Claude Code가 이 데이터에 액세스하고 관리할 수 있도록합니다.
Vault의 이름은 원하는 대로 설정할 수 있습니다. — 예를 들어 나는 "Obsidian Vault"라고 부르겠습니다.
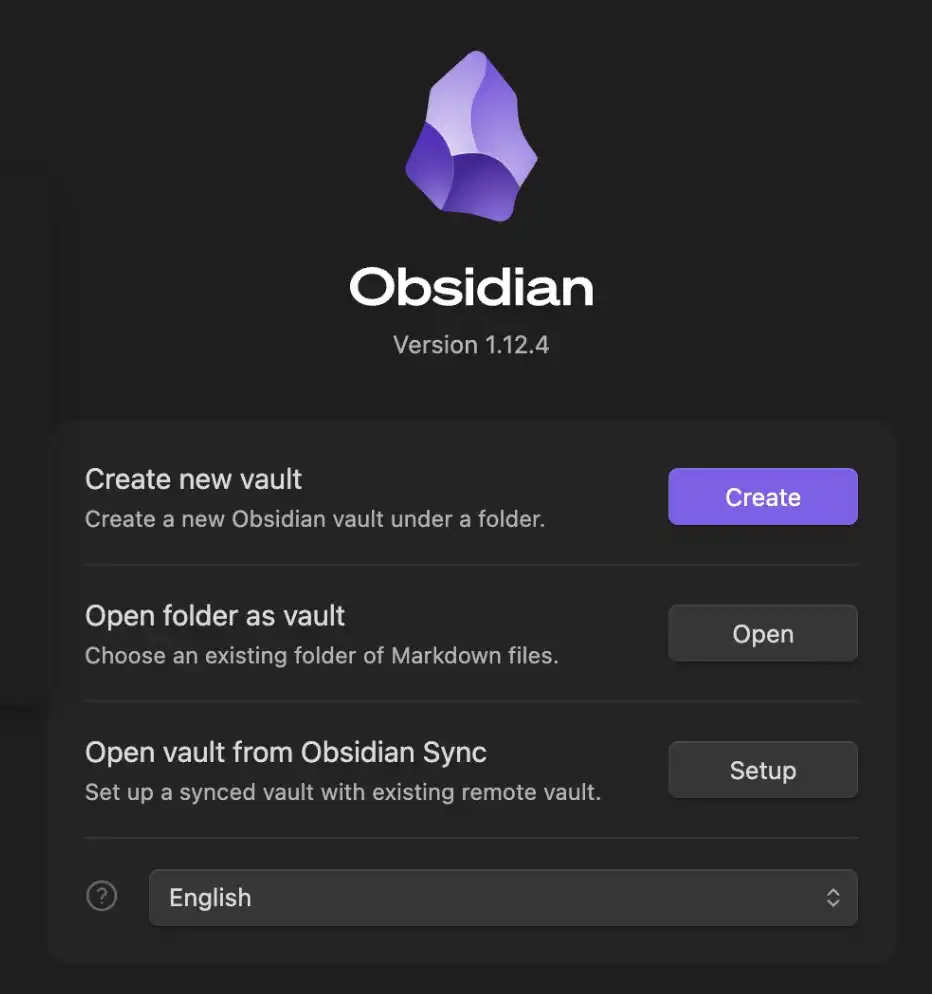
Obsidian Vault(지식 저장소)
이 Vault는 Obsidian이 모든 데이터와 노트를 저장하는 곳이며, 모든 콘텐츠는 MD(Markdown) 파일 형식으로 저장됩니다.
3. Claude Code 설정
다음으로, 당신은 Claude Code에 액세스할 수 있는 방법을 설정해야 합니다. 제게 말하자면 (아마 다른 대다수의 분들에게도 그렇겠지만), 가장 간단한 방법은 바로 데스크톱 클라이언트를 사용하는 것입니다.
주 채팅 화면에서 "폴더 선택"을 클릭하고, 방금 만든 Obsidian 보트(Vault)를 찾아 선택하면 됩니다.
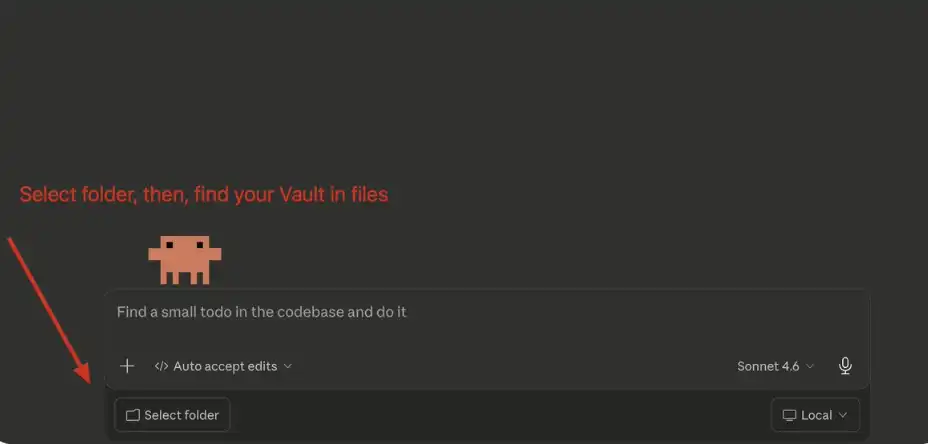
Claude Code: 보트(Vault) 연결
4. 시스템 프롬프트 설정
폴더를 선택한 후, 다음 단계는 Andrej Karpathy의 시스템 프롬프트를 주 채팅 상자에 붙여넣는 것입니다.
다음 프롬프트를 여기에서 복사할 수 있습니다: https://gist.github.com/karpathy/442a6bf555914893e9891c11519de94f
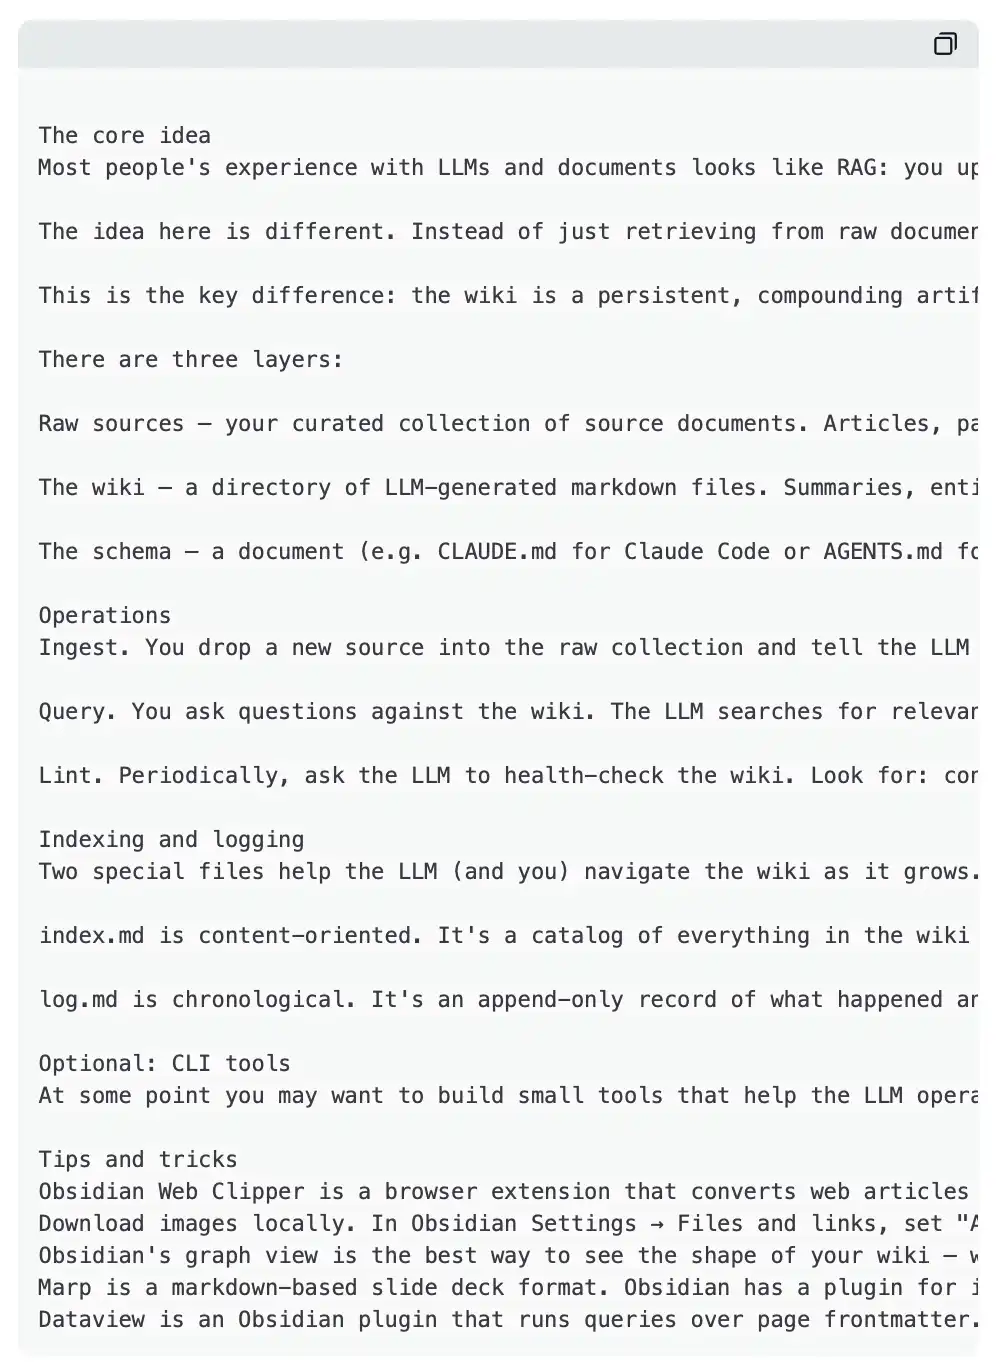
당신의 입력은 다음과 같아야 합니다:
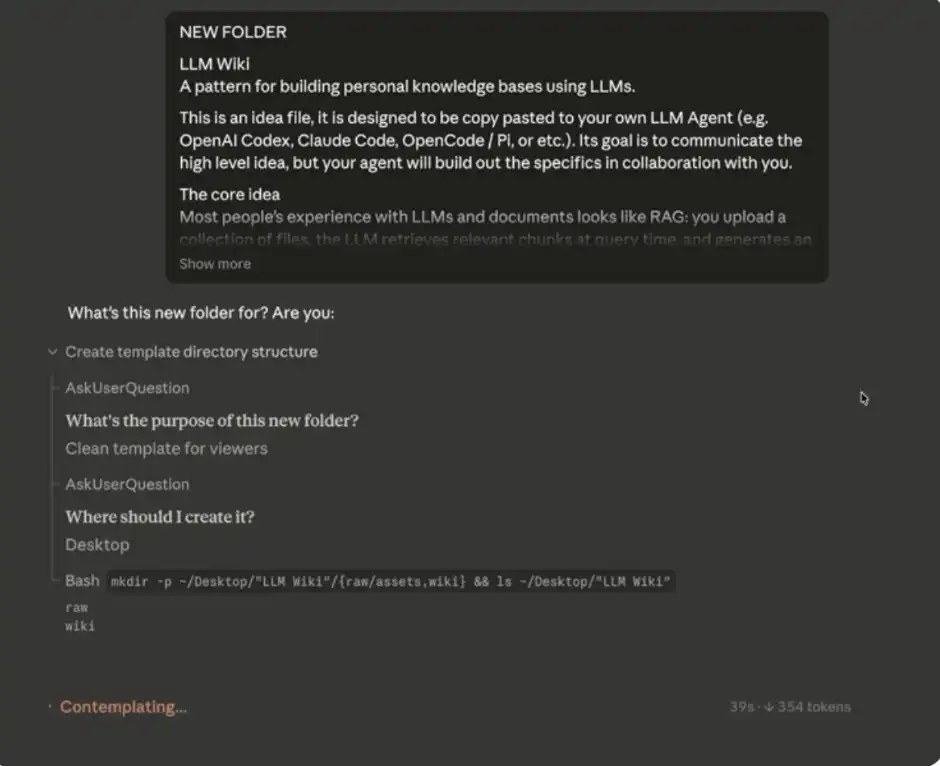
Claude Code 초기 입력
팁: Obsidian을 수동으로 열지 않아도 됩니다. MD 폴더 (즉, 보트/Vault) 및 관련 데이터를 Claude Code에 넘겨주면, 그것은 이러한 파일에 대해 바로 읽기 및 쓰기를 수행하고 수정할 수 있습니다. 이 내용은 자동으로 Obsidian의 '두 번째 두뇌'에 동기화됩니다.
5. 데이터베이스 구축
위의 시스템 프롬프트를 입력한 후, Claude Code는 당신에게 일부 데이터 소스를 묻고, 당신의 '두 번째 두뇌'를 초기화하고 점진적으로 채우기 위해 시작할 것입니다.
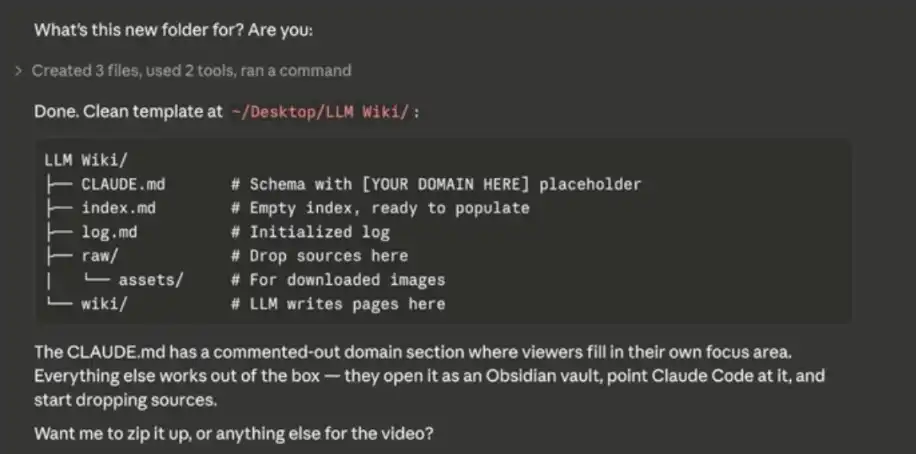
데이터베이스 구축
Obsidian을 빈 "노트북"으로 상상할 수 있습니다. 먼저 내용을 직접 입력해야 데이터베이스가 점차적으로 구축됩니다. 가져올 수 있는 콘텐츠에는 노트, CSV 파일, Markdown/텍스트 파일 등이 포함됩니다.
일부 유용한 팁:
· 기존의 노트 도구에서 데이터 내보내기
· Notion을 사용하는 경우 CSV 파일로 내보낼 수 있습니다.
· Claude(또는 다른 대형 모델)에게 당신에 대한 정보를 정리하도록 요청하여 "두 번째 두뇌"를 초기화합니다.
· 기존의 기사, 수집품, 아이디어 등을 한꺼번에 가져와서 가져옵니다. 이것이 초기 데이터를 구축하는 가장 좋은 시기이며, 이후에 언제든지 보충할 수 있습니다.
주의해야 할 점은 제가 처럼 데이터 양이 많은 데이터베이스는 일시적인 것이 아니라 시간이 지나며 점진적으로 입력되고 축적됩니다.
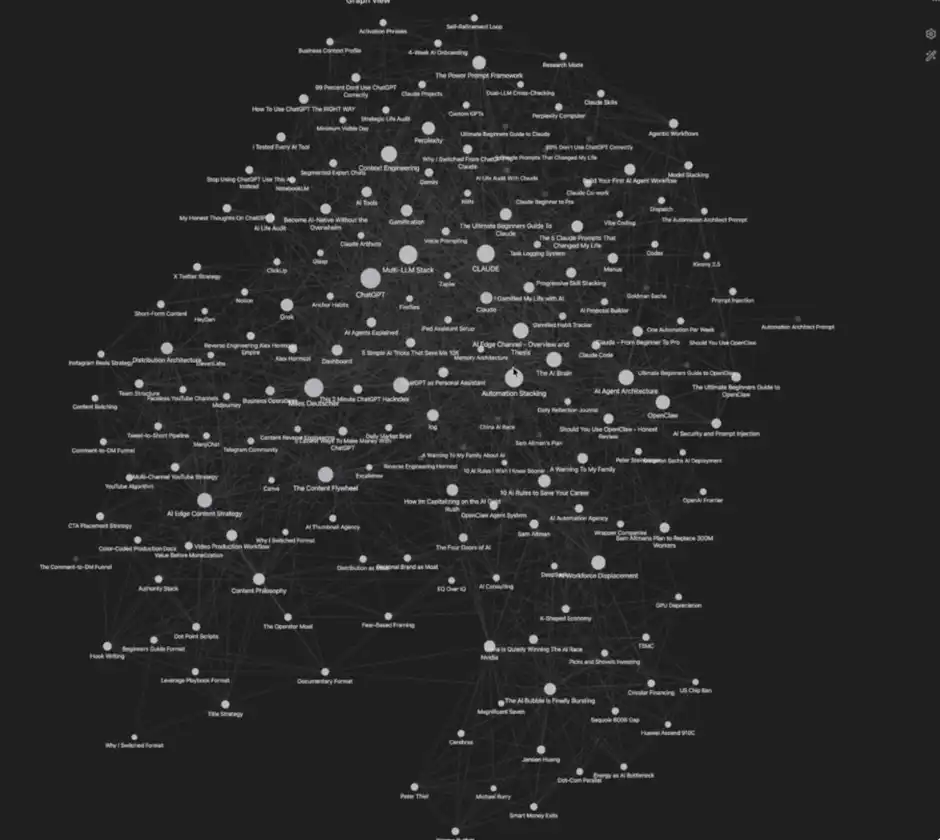
내 데이터베이스
당신의 "AI 두 번째 두뇌"가 이미 구축되었습니다. 이제 고급 기술 몇 가지를 공유하여 더 효율적으로 활용할 수 있도록 도와드리겠습니다.
고급 팁(Pro Tips)
1. Obsidian Chrome 확장 플러그인
시스템에 데이터를 쉽게 추가하려면 Obsidian의 Chrome 확장을 설치하기만 하면 됩니다. 이를 통해 웹 페이지를 탐색하는 동안 "Obsidian에 추가"를 클릭하여 내용을 한 번에 지식 저장소에 저장할 수 있습니다. 이를 통해 "두 번째 두뇌"를 구축하는 과정이 매우 편리해집니다.
나 또한 이 기능을 사용하여 논문, 웹 페이지 데이터, 연구 자료 등을 수집합니다.
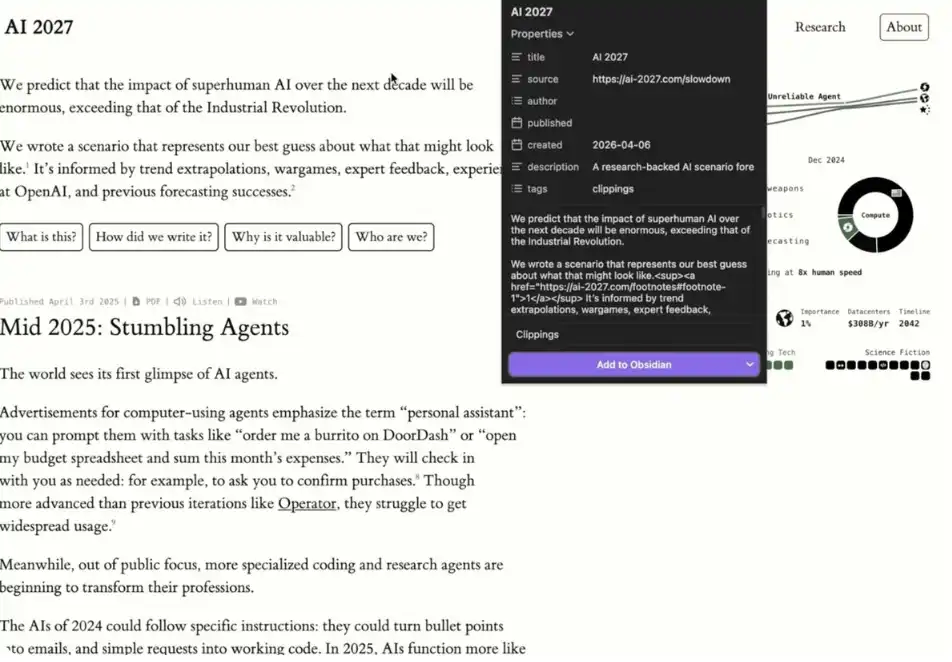
예시: Obsidian Chrome 확장 사용
확장을 통해 추가된 데이터는 처음에 "독립된 데이터 소스"일 뿐입니다.
다음으로 Claude Code에게 말할 수 있습니다: "제가 방금 Obsidian에 [x]를 추가했어요. 이 내용을 내 위키에 통합해주세요."
Claude Code는이 새로운 데이터를 기존 콘텐츠와 자동으로 연결하여 링크를 생성하며, 그것을 당신의 "두 번째 두뇌"에 통합합니다. 이것이이 도구 세트가 강력한 이유이기도 합니다.
2. 폴더(Vault) 분리
Andrej Karpathy는 두 개의 독립적인 폴더(Vault)를 사용하는 것을 권장했습니다:
· 업무/비즈니스 콘텐츠용
· 개인 생활/목표 관리용
내 자신의 사용 경험도 이 구조가 가장 명확하고 효율적이라고 생각합니다.
3. 유용성
이 시스템에서 가장 가치 있는 사용 방법 중 하나는 사실 매우 간단합니다: LLM(Large Language Model) 프롬프트 단어를 더 정확하게 만드는 것입니다.
모델이 귀하의 전체 개인 정보, 비즈니스 계획, 글쓰기 배경 등을 액세스할 수 있을 때, 보다 "맞춤형"이고 현실적인 고품질의 프롬프트 단어(심지어 "슈퍼 프롬프트"도)를 생성할 수 있습니다.
물론, 이 시스템의 활용은 여기에 그치지 않지만, 여러분이 가장 실용적인 시나리오에서 시작하려는 경우 "프롬프트 품질 향상"부터 시작하는 것을 강력히 권장합니다.
4. 고아들(Orphans)
Obsidian에서 "고아들(Orphans)"은 다른 노트와 연결되지 않은 데이터 포인트를 가리킵니다.
이 기능은 다음과 같은 이유로 유용합니다:
· 아직 통합되지 않은 아이디어 찾기
· 데이터베이스의 "약점 지역" 발견
· 어떤 내용을 더 확장하거나 심화해야 하는지 판단
다시 말해, 이것은 단순히 정리 도구뿐만 아니라 사고의 공백을 발견하는 데 도움이 되는 메커니즘입니다.
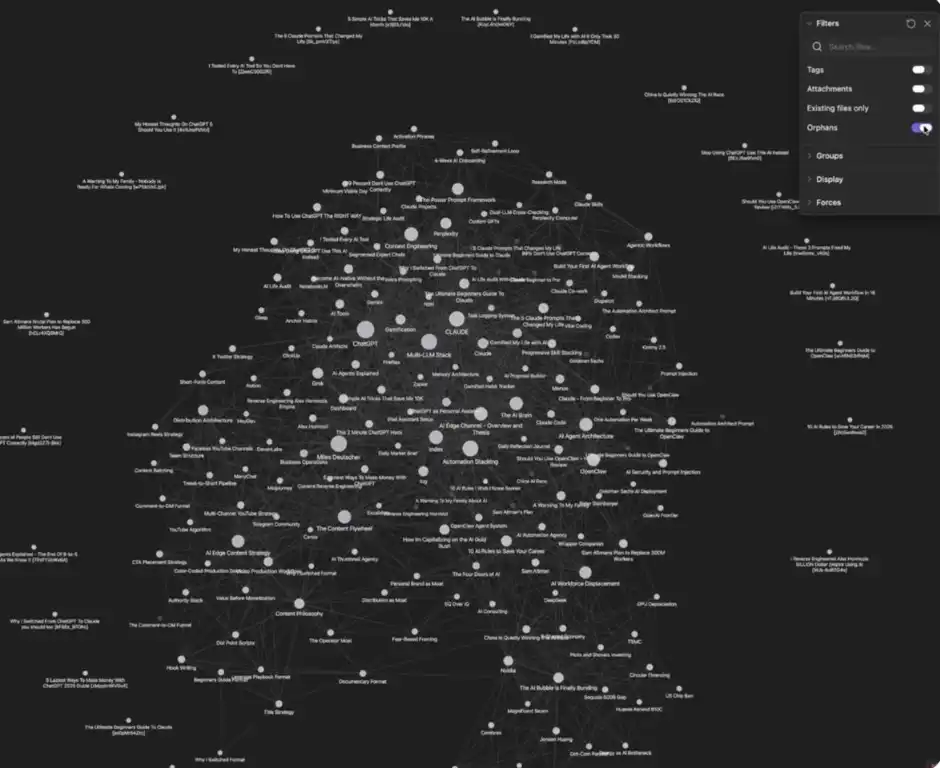
고아들(Orphans)
우측 상단에서 "세 점"을 클릭하여 Orphans 스위치를 찾고 켜서 아직 연결되지 않은 콘텐츠를 확인할 수 있습니다.
이 시스템의 잠재적인 단점
우리는 이미 이 시스템의 많은 장점, 사용 시나리오 및 최적화 방법에 대해 이야기했지만, 그렇다면 단점은 무엇인가요? 어떤 상황에서는 이 시스템을 사용하는 것이 적합하지 않을까요?
1. 시각화에 익숙하지 않은 사람들
이 시스템의 핵심 장점 중 하나는 데이터를 시각적으로 표현할 수 있다는 것입니다. 만약 여러분이 이러한 방식을 의존하거나 익숙하지 않다면, 그것은 여러분에게는 도움이 될 수도 제한적일 수도 있습니다.
2、일정한 유지 보수 비용이 필요합니다
데이터베이스를 계속 유지하길 원치 않는다면이 시스템은 여러분에게 적합하지 않을 수 있습니다. 유지 보수 비용은 높지 않지만 「두 번째 뇌」로 데이터를 계속 입력하지 않으면 가치를 실현하기 어렵습니다.
3、저장 공간
모든 콘텐츠는 로컬에서 Markdown 파일로 저장되며,이로 인해 일정량의 장치 공간이 소모됩니다. 이 점도 사전에 고려해야 합니다.
[원문 링크]
BlockBeats 공식 커뮤니티에 참여하세요:
Telegram 구독 그룹:https://t.me/theblockbeats
Telegram 토론 그룹:https://t.me/BlockBeats_App
Twitter 공식 계정:https://twitter.com/BlockBeatsAsia
 관련 기사