Kimi K3가 새로운 문제를 제기하다: 모델이 저렴해질수록 오히려 칩 수요가 더 커진다?
원문 제목: 《더 많은 토큰, 더 많은 칩! Kimi K3가 보여주는 '제번스 역설', 효율성 향상이 오히려 자원 소비 증가》
원문 저자: 자오잉, 월스트리트저널
Kimi K3는 AI 투자자들을 다시 핵심 질문으로 이끈다. 모델이 더 저렴하고 효율적이면 칩과 메모리 수요가 감소할까? 씨티은행과 뱅크오브아메리카 증권의 답변은 모두 부정적이다. 효율성 향상이 사용량을 더 많이 방출해 총 자원 소비를 증가시킬 수 있다는 것이다.
추펑 거래대에 따르면, 문지암면이 발표한 Kimi K3는 2.8조 개의 파라미터를 보유하며, 100만 토큰 컨텍스트 윈도우와 장기 주기 에이전트 작업을 대상으로 한다. 씨티은행 반도체 애널리스트 Peter Lee는 Kimi K3가 널리 사용되더라도 서버 DDR5 및 eSSD와 같은 범용 메모리 수요는 여전히 증가할 것이라고 본다.
뱅크오브아메리카 증권 반도체 애널리스트 Vivek Arya는 7월 17일 연구에서 미국 최첨단 AI 연구소가 연산 투자를 줄이기보다는 늘릴 가능성이 더 높다고 지적했다. 중국 오픈소스 모델이 계속해서 근접한다면, OpenAI, Anthropic 및 Google과 같은 선두주자는 더 큰 훈련 규모, 더 무거운 추론 및 더 빠른 제품 반복을 통해 차별화를 유지해야 한다.
이는 Kimi K3에 대한 시장의 가격 책정 논리가 단순히 단일 추론 비용 하락만으로 판단할 수 없음을 의미한다. 더 중요한 것은 저가 모델이 더 많은 호출, 더 긴 작업 체인 및 더 많은 토큰 생성을 유발하는지 여부다. 답이 '그렇다'라면 GPU, HBM, DDR5, eSSD, 고속 네트워크 및 추론 시스템이 계속해서 혜택을 볼 수 있다.
저가 고성능, '제번스 역설' 촉발
씨티은행은 Kimi K3를 AI 산업 체인에서 '제번스 역설'의 잠재적 사례로 본다. 이 역설의 핵심은 기술 효율성 향상이 단위 사용 비용을 낮춘 후, 사용량이 크게 증가해 최종 자원 총소비가 오히려 증가한다는 것이다.
Kimi K3의 매력은 저비용과 고성능의 조합에서 나온다. 공개 가격에 따르면, 캐시 적중 입력 가격은 백만 토큰당 0.3달러, 출력 가격은 백만 토큰당 15달러다. 전체 가중치는 7월 27일에 공개될 예정이며, 목표는 장기 주기 에이전트 작업을 지원하는 것이다.
씨티은행의 판단은 모델 가격 인하가 자동으로 하드웨어 수요를 줄이지 않는다는 것이다. 반대로, 저비용은 개발자와 기업의 모델 호출 의향을 높여 더 많은 AI 에이전트 배포를 촉진할 수 있다. 에이전트 작업은 일회성 질의응답이 아니라 연속적인 작업에서 지속적으로 토큰을 생성, 읽기 및 처리한다. 호출 횟수와 작업 길이가 증가하면 단위 비용 하락이 다시 총 자원 소비로 전환된다.
따라서 Kimi K3가 반도체 체인에 미치는 영향의 핵심은 '단일 호출이 더 저렴한지'가 아니라 '총 토큰량이 확대되는지'에 있습니다. 이것이 바로 씨티그룹이 서버용 DDR5와 eSSD 수요를 낙관하는 이유입니다.
긴 컨텍스트 추론, 메모리로 압력 전가
Kimi K3는 세 가지 핵심 기술을 채택했습니다: Kimi Delta Attention, Attention Residuals 및 Stable LatentMoE입니다. Kimi Delta Attention은 100만 토큰 컨텍스트 윈도우의 비용을 낮추는 데 사용되며, Attention Residuals는 모델의 서로 다른 깊이 간에 표현을 선택적으로 검색하는 데 사용됩니다. Stable LatentMoE는 희소성 수준을 높여 각 토큰이 896개의 전문가 중 16개만 활성화하도록 합니다.
월지암면(月之暗面)의 기술 자료에 따르면, 이 아키텍처는 Kimi K3의 확장 효율을 K2의 2.5배로 향상시킵니다. 높은 희소성과 긴 컨텍스트 능력은 운영 비용을 낮추는 중요한 기반입니다.
하지만 씨티그룹은 이것이 추론 측의 리소스 압력이 사라지는 것을 의미하지는 않는다고 강조합니다. Kimi K3는 여전히 경량 배포 솔루션이 아니며, 실행을 위해 다중 노드 클러스터가 필요하고 슈퍼 노드는 64개 이상의 GPU를 구성합니다. 더 중요한 것은, 긴 컨텍스트와 에이전트 작업이 KV Cache 점유를 증가시켜 추론 측의 메모리 부담을 가중시킨다는 점입니다.
KV Cache 수요는 서버용 DDR5 및 eSSD와 직접적으로 연결됩니다. DDR5는 고빈도 데이터 액세스를 담당하고, eSSD는 더 큰 캐시 및 데이터 저장 수요의 혜택을 받습니다. 메모리 제조사에게 핵심 변수는 개별 모델이 더 적은 연산력을 사용하는지 여부가 아니라, 저렴해진 후 모델이 얼마나 많이 호출되는지, 각 호출이 생성하는 토큰 수, 그리고 에이전트 작업 체인이 얼마나 길어지는지입니다.
모델 격차 축소, 오히려 연산력 기준 상승
뱅크오브아메리카 증권의 결론은 씨티그룹과 맥을 같이하지만, 초점은 GPU 및 AI 인프라에 더 가깝습니다. Vivek Arya는 더 강력한 중국 오픈소스 모델이 반드시 미국 AI 거대 기업들의 연산력 투자를 줄이게 하지는 않을 것이라고 봅니다. 오히려 모델 격차가 좁혀지면 선두 기업이 우위를 유지하는 비용이 상승합니다.
뱅크오브아메리카 증권은 오픈소스 모델이 지속적으로 따라잡는다면, OpenAI, Anthropic 및 Google은 더 큰 규모의 훈련, 더 많은 강화 학습 및 합성 데이터 루프, 더 무거운 테스트 시 추론, 그리고 더 빠른 제품 출시 속도에 의존하여 차별화를 유지해야 할 것이라고 지적합니다.
이 논리는 특정 모델이 단기적으로 앞서는지 여부에 달려 있지 않습니다. 대규모 언어 모델 순위는 빠르게 바뀔 수 있지만, 기업이 실제로 구매하는 것은 안정성, 낮은 지연 시간, 높은 가용성을 갖춘 AI 출력과 더 낮은 '단위 유효 산출량당 비용'입니다. 모델 성능이 수렴되면 경쟁 압력은 GPU, HBM, 고속 네트워크 및 추론 시스템을 포함한 기반 인프라로 전가됩니다.
따라서 BofA Securities는 Kimi K3와 같은 모델의 등장을 단순히 '모델이 더 효율적이어서 칩이 덜 필요하다'고 이해해서는 안 된다고 봅니다. 더 현실적인 경로는 모델 경쟁이 심화되고, 선두 주자가 격차를 유지하기 위해 컴퓨팅 파워를 계속 확충하는 것입니다.
MoE 아키텍처가 병목을 변화시키며, VRAM과 상호 연결이 더 중요해짐
Kimi K3는 MoE 아키텍처를 채택하여 총 파라미터 수와 각 추론 시 실제 활성화되는 파라미터를 분리할 수 있습니다. 이러한 변화는 일부 연산 부담을 줄였지만, 인프라 병목 현상을 단순한 컴퓨팅 파워에서 VRAM 접근, 전문가 라우팅, 응답 지연 시간 및 상호 연결 능력으로 전환시켰습니다.
BofA Securities는 MoE 추론이 시스템이 데이터를 더 효율적으로 이동하고, 전문가 모듈을 스케줄링하며, 더 큰 컴퓨팅 클러스터를 연결해야 한다고 강조합니다. 엔비디아는 현대적인 MoE 추론에 더 큰 GPU 도메인이 필요하다고 제시합니다. 그들의 추정에 따르면, GB300 NVL72는 선도적인 오픈소스 모델에서 Hopper 플랫폼 대비 와트당 성능이 최대 25배에 달할 수 있습니다.
CoreWeave의 Kimi K2.6 관련 테스트에서도 오픈소스 MoE 모델이 매번 일부 파라미터만 활성화하더라도 속도와 가성비에서 우위를 유지하려면 최적화된 엔비디아 GB300/GB200 NVL72 인프라가 필요함을 보여줍니다.
이는 모델 가중치가 점차 상품화될 수 있지만, 모델을 실행하는 데 필요한 GPU, 고대역폭 메모리, 네트워크 상호 연결 및 추론 시스템은 가치를 잃지 않을 것임을 의미합니다. 오히려 모델 호출량이 증가함에 따라 이러한 요소들이 경쟁이 더 집중되는 영역이 될 수 있습니다.
토큰 사용량은 여전히 확장 중이며, 수요 측면은 아직 정점에 도달하지 않음
BofA Securities는 또한 OpenRouter 데이터를 인용하여 모델 호출량이 여전히 빠르게 증가하고 있다고 지적합니다. 여러 모델 연구소를 연결하는 제3자 API 플랫폼인 OpenRouter에서 토큰 사용량이 지속적으로 증가하고 있으며, 특히 중국 AI 연구소 모델의 토큰 사용량이 비중국 연구소 모델을 이미 초과했습니다.
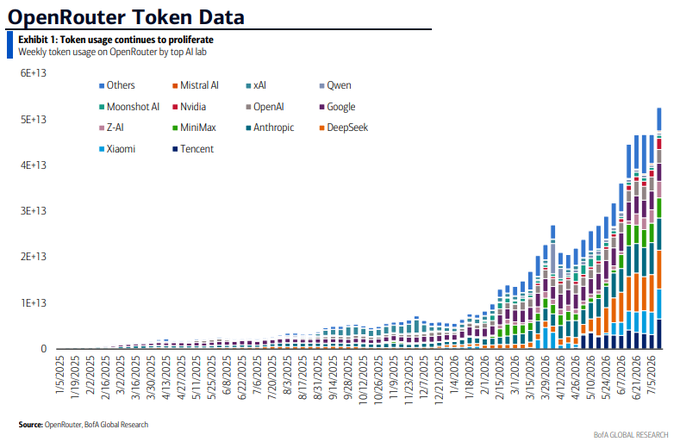
이 데이터가 모든 기업 및 소비자 시나리오를 직접적으로 대표할 수는 없지만, 적어도 오픈 모델 생태계에서 개발자들의 선택이 변화하고 있음을 보여준다. 모델 가격 하락과 성능 향상은 단일 모델의 효율성 개선으로 상쇄되기보다는 호출량의 지속적인 확장을 촉진할 가능성이 높다.
기업의 유료 사용도 증가하고 있다. Ramp 데이터에 따르면, 2026년 6월 기준으로 약 55%의 미국 기업이 AI 모델, 플랫폼 또는 도구를 유료로 구독하고 있으며, 이는 미국 인구조사국 BTOS 조사에서 추정된 21%보다 높은 수치다. 모델별로 보면, Anthropic의 기업 채택률은 42.4%, OpenAI는 39.5%다.
하지만 AI 지출은 여전히 고도로 집중되어 있다. 상위 1%의 기업 사용자는 직원 1인당 월평균 AI 지출이 약 4,833달러인 반면, 상위 10%는 516달러, 전체 중앙값은 11달러에 불과하다. 기술 및 미디어 업종의 구독률은 79.8%에 달하며, 대기업의 채택률은 65.5%로 중견기업(61.3%) 및 중소기업(48.7%)보다 높다.
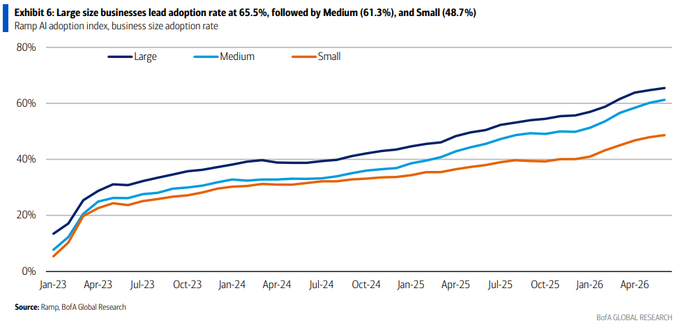
이 데이터는 AI 사용이 여전히 확산 과정에 있다는 판단을 뒷받침한다. 저가 모델이 진입 장벽을 낮추면, 향후 추가 수요는 더 많은 기업, 더 많은 개발자, 더 많은 에이전트 애플리케이션에서 발생할 수 있다.
「연산력 절약」에서 「더 많은 워크로드」로
씨티그룹과 뱅크오브아메리카 증권의 공통된 결론은 Kimi K3의 의미가 단일 모델이 단위 추론 비용을 낮추는지 여부가 아니라, 저비용이 더 큰 규모의 워크로드를释放할 수 있는지에 있다는 것이다.
씨티그룹에게 가장 직접적인 수혜 방향은 서버 DDR5와 eSSD다. 긴 컨텍스트, KV Cache 및 에이전트 작업은 메모리 접근과 스토리지 수요를 증가시킨다. 뱅크오브아메리카 증권에게 더 중요한 것은 GPU, HBM, 고속 네트워크 및 추론 시스템이다. 모델 경쟁이 선두 주자들로 하여금 인프라에 계속 투자하도록 만들기 때문이다.
뱅크오브아메리카 증권은 또한 Kimi K3와 관련된 「45nm 오픈소스 EDA」가 상용 EDA의 대체로 단순 해석되어서는 안 된다고 언급했다. 오히려 이는 칩 설계가 여전히 EDA 도구에 의존하고 있음을 보여준다. 첨단 공정에서 Cadence 및 Synopsys와 같은 상용 EDA 업체는 여전히 핵심적인 위치를 차지하고 있다.
위험은 다른 시나리오에 있다. 모델 압축, 추론 최적화 및 하드웨어 효율성 개선이 새로운 워크로드 증가보다 장기적으로 빠르게 진행된다면, AI 인프라 확장은 일시적으로 둔화될 수 있다. 하지만 현재 두 투자은행의 프레임워크에서 Kimi K3는 칩 수요를 약화시키는 신호라기보다는 사용량을 끌어올리는 촉매제에 가깝다. 효율성 개선 이후, 시장이 주목해야 할 것은 오히려 더 많은 토큰, 더 많은 추론, 그리고 더 많은 기본 하드웨어 소비다.
원문 링크
BlockBeats 공식 커뮤니티에 참여하세요:
Telegram 구독 그룹:https://t.me/theblockbeats
Telegram 토론 그룹:https://t.me/BlockBeats_App
Twitter 공식 계정:https://twitter.com/BlockBeatsAsia

 관련 기사