모건스탠리 분석: AI 칩의 질주, 전력 공급이 따라잡을 수 있을까? 2027년 잠재 수요 약 38GW
TL;DR
· 모건스탠리는 약 1,900만 개의 GPU/ASIC, 평균 2kW TDP 기준으로 2027년 칩 내재 전력 수요를 약 38GW로 추산했으며, 이 중 엔비디아가 약 16GW를 차지한다.
· 38GW는 데이터센터 총 전력 사용량이나 이미 구축된 전력 용량이 아니라, 인프라가 칩 출하량을 수용할 수 있는지를 검증하는 스트레스 테스트다.
· 보고서는 2027년 AI HBM 수요를 약 486억 Gb, CoWoS 수요를 약 266만~269만 장으로 추산했지만, Rubin Ultra 계층형 메모리 방안은 아직 최종 확정되지 않았다.
· 구글 TPU 출하량은 2026년 370만 개에서 2027년 735만 개로 증가할 전망이며, KYEC 등 테스트 공급망 주문도 함께 견인할 것으로 보인다.
모건스탠리의 최신 아시아 공급망 점검은 AI 확장을 보다 직관적인 전력 수치로 환산했다. 2027년 약 1,900만 개의 CoWoS 내재 GPU 및 ASIC, 평균 2kW TDP 기준으로 추산한 이 칩들의 전력 용량은 약 38GW에 달한다.
이 중 엔비디아가 약 16GW, 구글이 약 9GW, AMD가 약 7GW, AWS가 약 2GW, 마이크로소프트, 메타 및 기타 업체가 각각 약 1GW를 차지한다.
강조할 점은 38GW가 당시 글로벌 AI 데이터센터의 총 전력 사용량도, 이미 확보된 전력 용량도 아니라는 것이다. 이 수치는 CPU, 네트워크, 스토리지, 냉각 및 기타 부대 설비의 전력 사용을 완전히 반영하지 않으며, 칩 출하량에서 도출된 스트레스 테스트에 더 가깝다. 즉, 2027년 AI 가속기가 공급망 모델에 따라 확대된다면 전력 인프라가 이러한 칩들을 동시에 수용할 수 있을까?
이는 AI 컴퓨팅 확장의 제약이 'GPU를 생산할 수 있는가'에서 HBM, CoWoS, 테스트, 랙 납품, 전력 접속이 동시에 갖춰질 수 있는가로 더 확장되고 있음을 의미한다.
38GW 스트레스 테스트, AI 병목을 전력으로 확대
모건스탠리의 이번 추산은 두 가지 핵심 가정에 기반한다. 2027년 CoWoS에 해당하는 GPU 및 ASIC 칩 수량이 약 1,900만 개이고, 칩당 평균 TDP를 2kW로 계산하여 약 38GW의 칩 내재 전력 수요를 도출했다.
2kW는 총량 추산을 위해 채택된 평균 가정일 뿐, 모든 GPU와 ASIC이 동일한 전력 소비를 가진다는 의미는 아니다. 38GW는 데이터센터의 실제 운영 부하와도 같지 않다. 칩이 항상 최대 부하로 가동되지는 않으며, 서버 내 CPU, 네트워크, 스토리지, 냉각 시스템이 추가 전력을 소비하기 때문이다.
하지만 이 수치는 여전히 참고 가치가 있다. 지난 2년간 AI 공급망 논의는 주로 GPU 생산 일정, HBM 공급, CoWoS 캐파에 집중되어 왔다. 칩 출하량이 계속 증가함에 따라, 전력망 연계, 변전소 건설, 데이터센터 입지 선정, 장기 전력 구매 계약이 칩이 실제 가용 컴퓨팅 파워로 전환될 수 있는지에 직접적인 영향을 미칠 수 있다.
칩 인도는 첫 단계에 불과하다. GPU 또는 ASIC이 데이터센터에 들어간 후에는 서버, 랙, 네트워크, 냉각, 전력 및 운영 유지보수 시스템이 함께 갖춰져야 한다. 인프라 구축이 칩 출하보다 느리다면, 시장에 '칩은 도착했지만, 전산실과 전력이 준비되지 않은' 불일치가 발생할 수 있다.
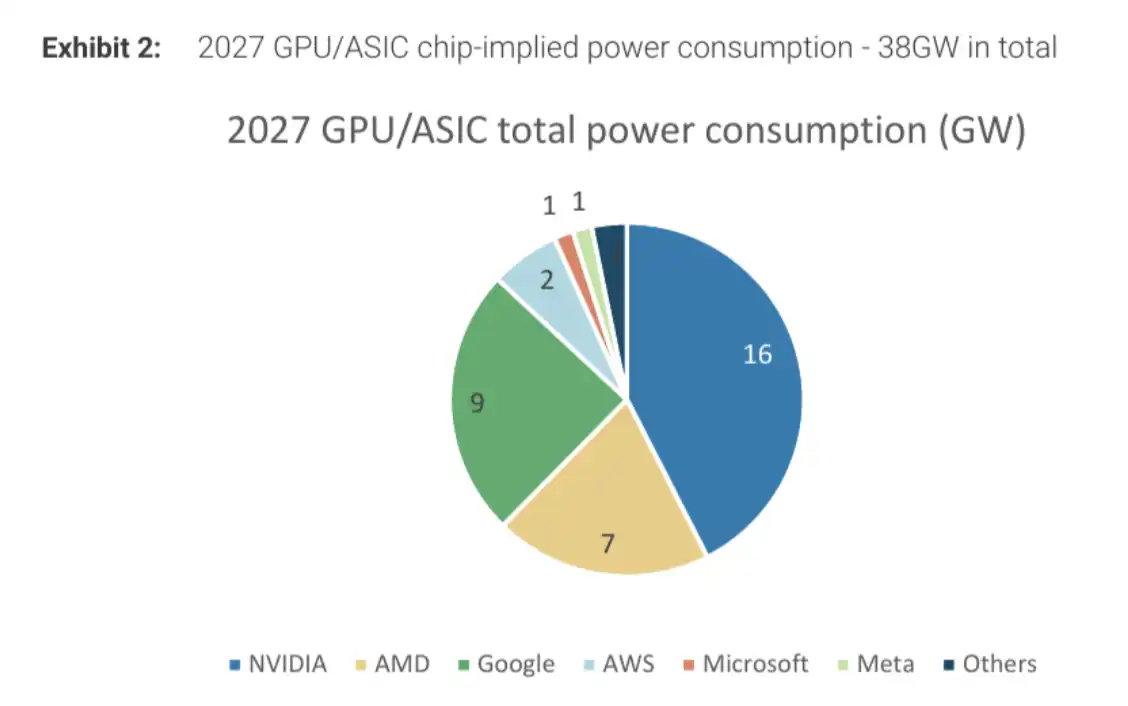
2027년 GPU/ASIC 칩의 내재 전력 수요는 약 38GW이며, 이 중 엔비디아 16GW, 구글 9GW, AMD 7GW이다.
엔비디아의 경우, 16GW의 내재 수요는 회사가 지속적으로 랙당 GPU 밀도를 높이는 이유를 설명한다. 보고서에 따르면, 엔비디아는 장기적으로 scale-up 아키텍처를 통해 더 많은 GPU를 연결하여 랙 수준의 컴퓨팅 성능과 성능을 향상시키는 것을 목표로 한다.
하지만 1세대 Rubin Ultra 랙의 Kyber 솔루션은 여전히 PCB 및 냉각 과제에 직면해 있으며, Oberon NVL72 설계를 계속 채택한 후 CPO 또는 NPO 인터커넥트를 통해 NVL576 규모로 확장할 가능성이 있다. 랙 밀도를 높이는 것이 전력 수요를 제거하지는 않으며, 오히려 전력 공급, 냉각 및 인터커넥트 부담을 더 높은 사양의 데이터센터 설계에 집중시킬 뿐이다.
HBM 및 CoWoS 동반 확장, Rubin Ultra 사양은 아직 미정
전력 외에도 HBM과 고급 패키징은 여전히 2027년 전후 AI 칩 확장의 주요 제약 요인이다.
모건스탠리 공급망 모델에 따르면, 2027년 AI 칩에 해당하는 HBM 수요는 약 486.18억 Gb이다. Exhibit 3에 나열된 CoWoS 구성량은 약 266.4만 웨이퍼이며, Exhibit 5에서 제시된 글로벌 CoWoS 수요는 약 269.4만 웨이퍼로, 통계 범위 차이로 인해 약간의 차이가 있다.
보고서는 또한 2027년 AI 컴퓨팅 칩에 해당하는 웨이퍼 매출 시장 규모가 최소 588억 달러에 달할 것으로 추산한다. 엔비디아는 여전히 CoWoS 최대 수요처로, 약 122.2만 웨이퍼를 차지할 것으로 예상되며, AMD와 브로드컴은 각각 약 53만 웨이퍼와 48.4만 웨이퍼이다.
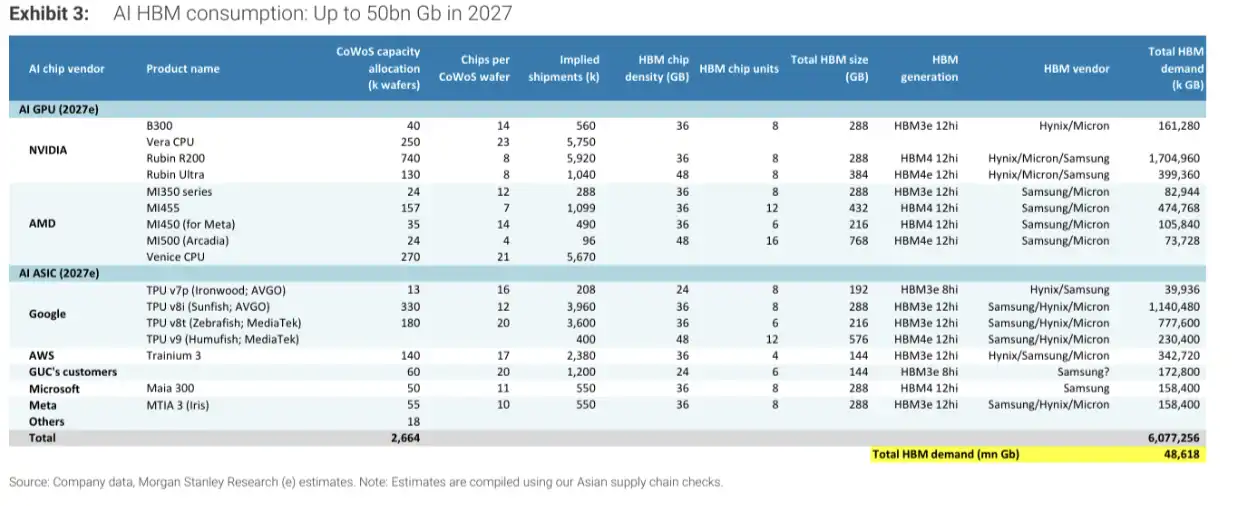
2027년 AI HBM 수요는 약 486억 Gb로 예상되며, 다양한 GPU 및 ASIC의 CoWoS 구성과 HBM 수요가 포함됩니다.
수요 예측에는 여전히 중요한 변수가 하나 있습니다: Rubin Ultra의 HBM 구성이 아직 최종 확정되지 않았다는 점입니다.
공급망 점검 결과, Rubin Ultra는 계층별 사양을 채택할 가능성이 있으며, 고사양 버전은 HBM4e 8Hi를, 저사양 버전은 HBM4 12Hi 또는 8Hi를 사용할 수 있습니다. 모건스탠리는 엔비디아가 2026년 3분기 말 이전에 최종 결정을 내릴 것으로 예상합니다.
이러한 조정은 주로 세 가지 압력을 반영합니다: HBM 생산능력 부족, 메모리 비용 상승, 그리고 다양한 AI 워크로드가 요구하는 용량과 대역폭이 서로 다르다는 점입니다. 보고서는 HBM 구성을 낮추는 것이 디코딩 워크로드에 미치는 영향이 프리필(prefill)보다 클 수 있으며, 특히 긴 컨텍스트 대형 모델에서 더 두드러질 수 있다고 분석합니다.
주의할 점은 Exhibit 3이 여전히 Rubin Ultra에 HBM4e 12Hi, 단일 칩 총 용량 384GB를 기준으로 계산되었다는 것입니다. 따라서 486억 Gb의 HBM 수요는 잠재적인 계층별 사양 하향 조정을 완전히 반영하지 못했습니다. 최종 구성이 하향 조정되면 단일 칩의 HBM 사용량이 줄어들 수 있지만, 낮아진 메모리 비용이 칩 출하량 증가를 촉진하여 단일 칩 사용량 감소 영향을 부분적으로 상쇄할 수 있습니다.
마이크론의 공개 정보에 따르면, HBM4는 이미 대량 출하 단계에 진입했으며, HBM4E는 2027년 양산이 예상됩니다. 공급 측면에서 신제품이 추진되고 있지만, Rubin Ultra가 최종적으로 어떤 구성을 채택할지는 여전히 엔비디아의 성능, 비용, 공급 보장에 대한 종합적인权衡에 달려 있습니다.
Rubin 시리즈의 출하 속도는 여전히 공격적입니다. 보고서는 2027년 Rubin과 Rubin Ultra의 합산 출하량이 약 700만 개에 이를 것으로 예상하며, 그중 Rubin은 약 592만 개, Rubin Ultra는 약 104만 개입니다. Rubin NVL72 랙 출하량은 약 9만 대에 달할 수 있습니다.
Rubin은 2026년 3분기부터 생산량이 증가하기 시작하고, 4분기에는 랙 출하가 시작될 것으로 예상됩니다. 보고서는 또한 이전에 시장에서 우려했던 Blackwell의 '재고'가 대부분 공급망 버퍼 재고에 불과하며, 2026년에 완전히 소진될 것으로 전망합니다.
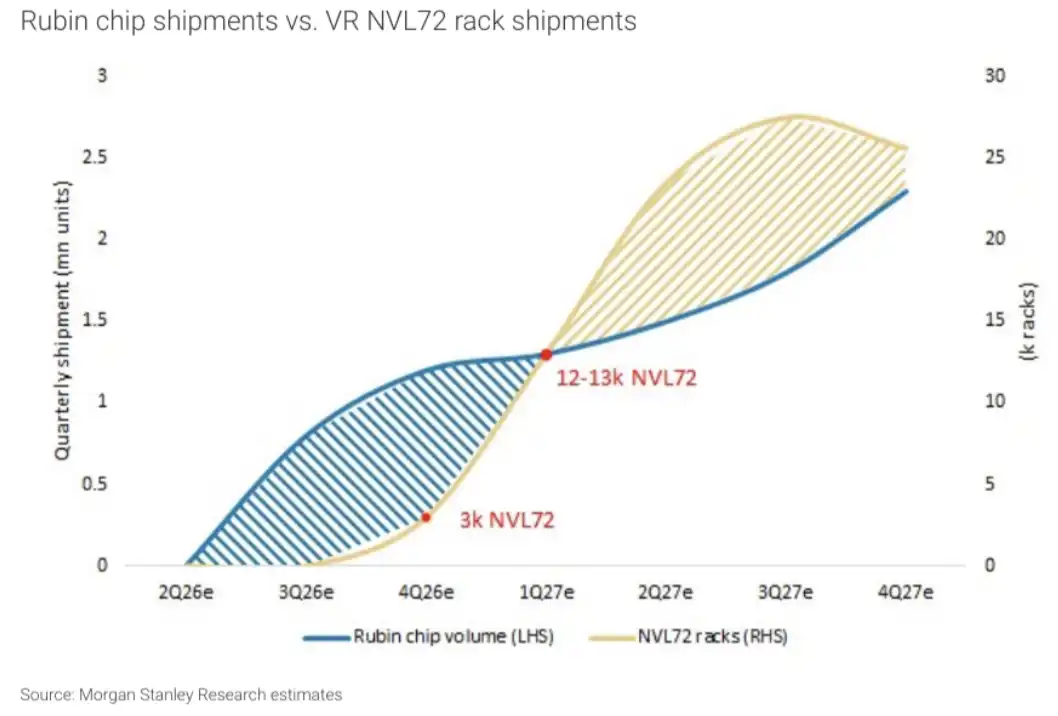
Rubin 및 Rubin Ultra 칩 출하, Rubin NVL72 랙 출하 전망.
이는 2026년 하반기부터 2027년까지 엔비디아 공급망이 Blackwell 재고 소진, Rubin 램프업, HBM 사양 전환, 랙 납품을 동시에 완료해야 함을 의미합니다. 어느 한 단계라도 지연되면 최종 인도 가능한 컴퓨팅 규모에 영향을 미칠 수 있습니다.
구글 TPU 735만 개로 증가, 주문이 테스트 체인으로 전달
엔비디아 외에도 구글 TPU는 보고서에서 또 하나의 뚜렷한 성장 축입니다.
모건스탠리 전망에 따르면, 구글 TPU 출하량은 2026년 370만 개에서 2027년 735만 개로 증가할 것으로 예상됩니다. 이 중 브로드컴이 참여하는 v8i는 400만 개, 미디어텍이 참여하는 v8t는 300만 개, v9는 약 15만 개, 나머지 약 20만 개는 v7에서 나올 것으로 보입니다.
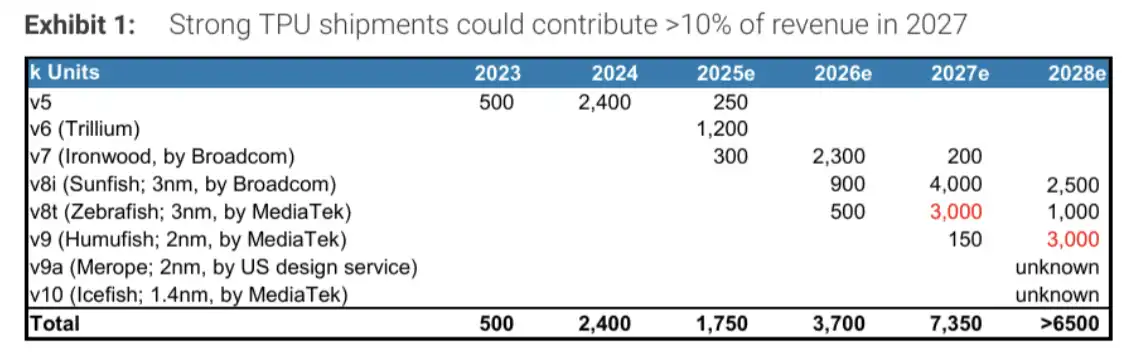
구글 세대별 TPU 출하 전망 및 KYEC 매출에 대한 잠재적 기여도.
TPU 물량 확대는 주문을 칩 설계, 웨이퍼 제조, 고급 패키징, 테스트 단계로 전달할 것입니다. 보고서는 TPU 관련 사업이 KYEC의 2026년 매출의 7%~8%를 차지하고, 2027년에는 10%를 약간 상회할 것으로 예상하며, 최종 테스트 및 일부 웨이퍼 프로빙 수익을 포함합니다.
구글 CPU, TPU, 최종 테스트 및 일부 웨이퍼 프로빙 사업을 모두 포함하면, 구글 관련 수요는 KYEC의 2027년 매출의 10%~15%를 차지할 것으로 예상되며, 이는 2026년의 8%~10%보다 높은 수준입니다.
테스트 수요도 더욱 복잡해지고 있습니다. 보고서에 따르면, 미디어텍이 참여하는 3nm TPU는 AI 칩의 성능 안정성과 신뢰성을 높이기 위해 번인(Burn-in) 테스트를 채택할 것으로 예상됩니다. 구글 CPU 프로젝트도 번인 및 시스템 수준 테스트가 필요합니다.
더 복잡한 테스트 프로세스와 더 긴 테스트 주기는 테스트 업체의 주문을 증가시킬 것이지만, 테스트 생산 능력이 병목이 될지 여부는 단일 칩 테스트 시간과 전체 출하량의 공동 변화에 달려 있습니다. 보고서는 또한 일부 테스트 시간 단축이 단기 생산 능력 압박을 완화할 수 있으므로, 테스트 수요 증가를 생산 능력 부족으로 단순히 동일시할 수 없다고 지적합니다.
38GW는 수요의 끝이 아니라, 공급 능력 테스트다
이번 공급망 점검에서 가장 주목할 만한 점은 단순히 더 많은 AI 칩 출하 수치를 제시한 것이 아니라, 2027년의 주요 확장 제약 요소를 하나의 동일한 모델에 담아냈다는 것이다: 엔비디아는 GPU 밀도를 계속 높이고, 구글 TPU는 빠르게 물량을 확대하며, HBM과 CoWoS 수요는 동시에 상승하고, 칩의 잠재적 전력 수요는 38GW로 끌어올려졌다.
이러한 수치들은 여전히 여러 전제 조건에 의존한다. Rubin Ultra의 계층형 HBM 설계는 아직 최종 확정되지 않았으며, 메모리 구성을 낮췄을 때 긴 컨텍스트 디코딩 성능에 미치는 영향은 여전히 검증이 필요하다. CoWoS와 HBM 생산 능력은 계획대로 확장되어야 하며, 서버, 랙, 전력 및 냉각 인프라 구축도 칩 출하에 맞춰 따라가야 한다.
상호 연결 방식 역시 차이를 만들어낼 수 있다. 보고서에 따르면, 중국 현지 파운드리 공정의 한계로 인해 중국 AI GPU 제조사들의 SerDes 속도는 여전히 채널당 100Gb/s에 머물 가능성이 있으며, 따라서 그들의 슈퍼노드 아키텍처는 점점 더 NPO 상호 연결을 채택하고 있다. 반면 엔비디아는 장기적으로 CPO를 더 중시한다. 서로 다른 기술 경로는 슈퍼노드 설계, 배포 비용 및 시스템 효율성에 영향을 미칠 것이다.
따라서 38GW는 2027년 실제 전력 소비량에 대한 정밀한 예측이 아니라, 칩 출하 측면에서 도출된 스트레스 테스트다. 이는 AI 칩 수요가 여전히 강력하다는 것을 보여주며, 시장에 다음과 같은 점을 상기시킨다: AI 컴퓨팅 파워가 실제로 구현될 수 있는지 여부는 더 이상 GPU 생산 일정만이 아니라, HBM, CoWoS, 테스트, 랙 및 전력이 동시에 제때 확보될 수 있는지에 달려 있다.
BlockBeats 공식 커뮤니티에 참여하세요:
Telegram 구독 그룹:https://t.me/theblockbeats
Telegram 토론 그룹:https://t.me/BlockBeats_App
Twitter 공식 계정:https://twitter.com/BlockBeatsAsia