황인훈 GTC 연설 전문: 2027년 시장 수요가 1조 달러를 넘을 것; 모두가 OpenClaw 전략을 채택해아합니다
원문 제목: "황량훈 GTC 연설 전문: 추론 시대의 도래, 2027 매출은 적어도 1조 달러, 로브스터가 새로운 운영 체제가 된다"
원문 작성자: 보익룡, 월스트리트저널
2026년 3월 16일, 엔비디아 GTC 2026 컨퍼런스가 공식적으로 열렸으며, 엔비디아의 창업자 겸 CEO 황량훈이 핵심 연설을 진행했습니다.
이번 "AI 산업의 연례 순례로 여겨지는" 컨퍼런스에서, 황량훈은 엔비디아가 "칩 기업"에서 "AI 인프라 및 공장 기업"으로의 전환을 소개했습니다. 시장에서 가장 관심을 가지고 있는 지속적인 실적과 성장 가능성을 직면하며, 황량훈은 미래 성장을 주도하는 근본적인 비즈니스 논리인 "토큰 공장 경제학"을 자세히 설명했습니다.
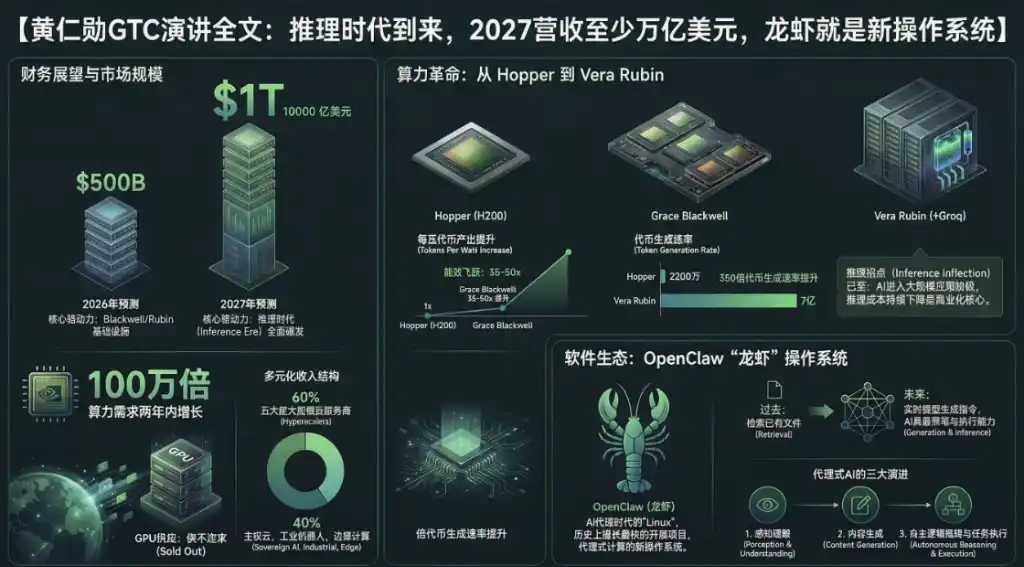
실적 가이던스가 매우 낙관적이며, "2027년 적어도 1조 달러의 수요"
지난 2년간, 전 세계적인 AI 컴퓨팅 수요가 기하급수적으로 증가했습니다. 대형 모델이 "인식"에서 "생성"으로 진화하여 "추론" 및 "실행(작업 수행)"으로 넘어감에 따라 연산 능력의 소비량이 급격히 증가했습니다. 시장에서 매우 주목하는 주문과 매출 천장에 대응하여, 황량훈은 매우 강력한 전망을 제시했습니다.
황량훈은 연설에서 직언했습니다:
작년 이맘때쯤, 저희는 5,000억 달러에 달하는 고 확신도 수요를 보았고, 블랙웰과 루빈을 2026년까지 커버했습니다.지금, 이 시점에서 내가 보는 것은 적어도 1조 달러의 수요입니다 (at least $1 trillion).
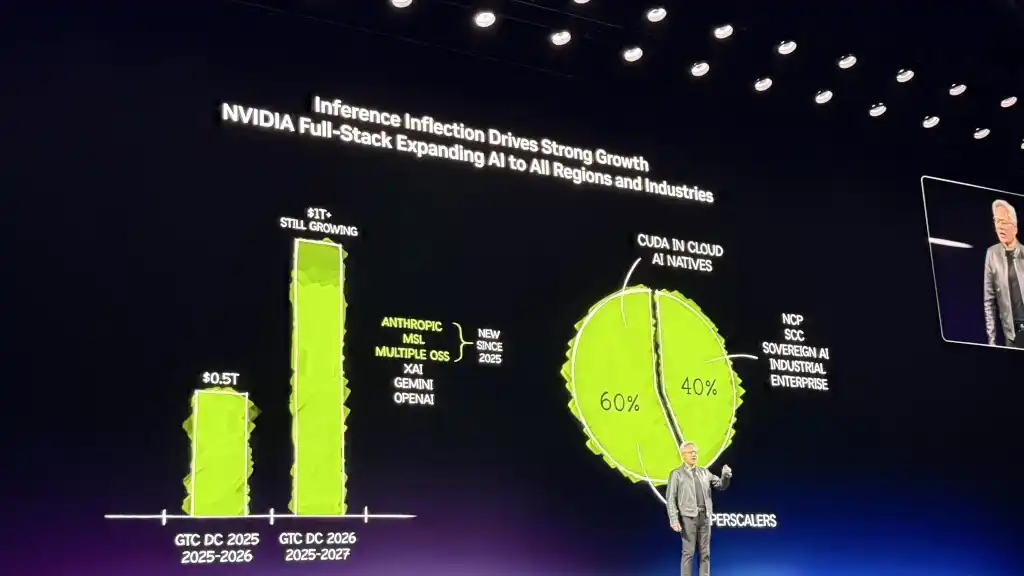
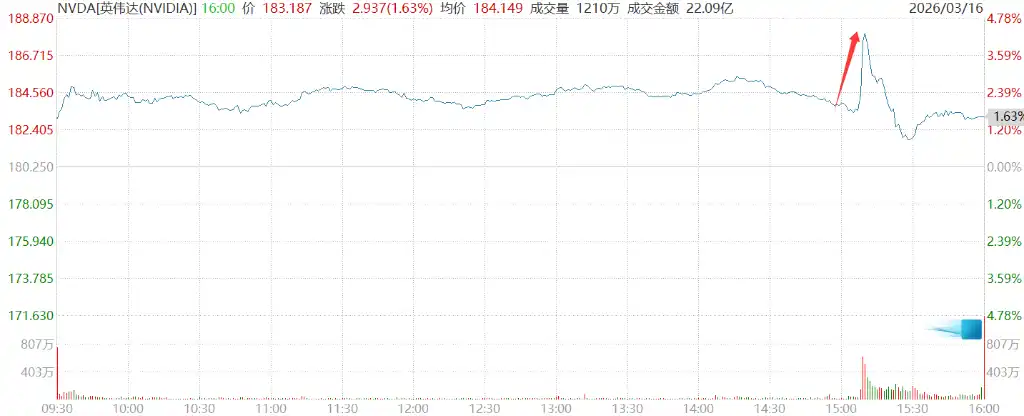
황량훈의 1조 예상은 엔비디아 주가를 4.3% 이상 상승시켰습니다.
뿐만 아니라, 그는 이 숫자에 대해 보충 설명을 제공했습니다:
이것이 합당한가요? 다음에 이야기할 것입니다. 실제로, 우리는 수요를 충족시킬 수 없을 것입니다. 나는 확신합니다. 실제 연산 수요는 훨씬 더 높을 것이라고.
황량훈은 현재의 엔비디아 시스템이 이미 세계적인 "가장 저렴한 인프라"임을 증명했다고 언급했습니다. 엔비디아가 거의 모든 영역의 AI 모델을 실행할 수 있기 때문에, 이러한 범용성은 고갱적으로 투입된 이 1조 달러가 충분히 활용되고 장기적인 수명주기를 유지할 수 있도록합니다.
현재 NVIDIA의 60% 매출은 세계 탑 5 대형 클라우드 공급업체에서 기인하며, 나머지 40%는 주권 클라우드, 기업, 산업, 로봇 및 엣지 컴퓨팅 등 다양한 분야로 확산되어 있습니다.
토큰 공장 경제학, 와트당 성능이 비즈니스의 생명
이 1조 달러의 수요를 설명하기 위해, 황인훈은 글로벌 기업 CEO에게 새로운 비즈니스 사고 방식을 제시했습니다. 그는 미래의 데이터 센터가 더 이상 파일을 저장하는 창고가 아니라 Token (AI 생성 기본 단위)을 생산하는 "공장"이 될 것이라고 지적했습니다.
황인훈은 강조했습니다:
모든 데이터 센터, 모든 공장은 정의상 전력에 의해 제한됩니다. 1GW(기가와트)의 공장은 영원히 2GW로 확장될 수 없으며, 이는 물리 법칙과 원자의 법칙입니다. 고정된 전력 하에서, 와트당 Token 처리량이 가장 높은 곳이 생산 비용이 가장 낮습니다.
황인훈은 미래의 AI 서비스를 네 가지 비즈니스 수준으로 분류했습니다:
· 무료 수준 (고 처리량, 낮은 속도)
· 중급 수준 (~백만 Token 당 3달러)
· 고급 수준 (~백만 Token 당 6달러)
· 고속 수준 (~백만 Token 당 45달러)
· 초고속 수준 (~백만 Token 당 150달러)
그는 모델이 점점 커지고 맥락이 점점 길어짐에 따라 AI가 더 똑똑해지지만, Token 생성 속도가 감소할 것이라고 설명했습니다. 황인훈은 다음과 같이 말했습니다:
이 토큰 공장에서 당신의 처리량과 Token 생성 속도는 내년의 정확한 수익으로 변환될 것입니다.
황인훈은 NVIDIA의 아키텍처가 고객이 무료 수준에서 매우 높은 처리량을 달성하면서도 최고 가치의 추론 수준에서 성능을 놀랍게 35배 향상시킬 수 있다고 강조했습니다.
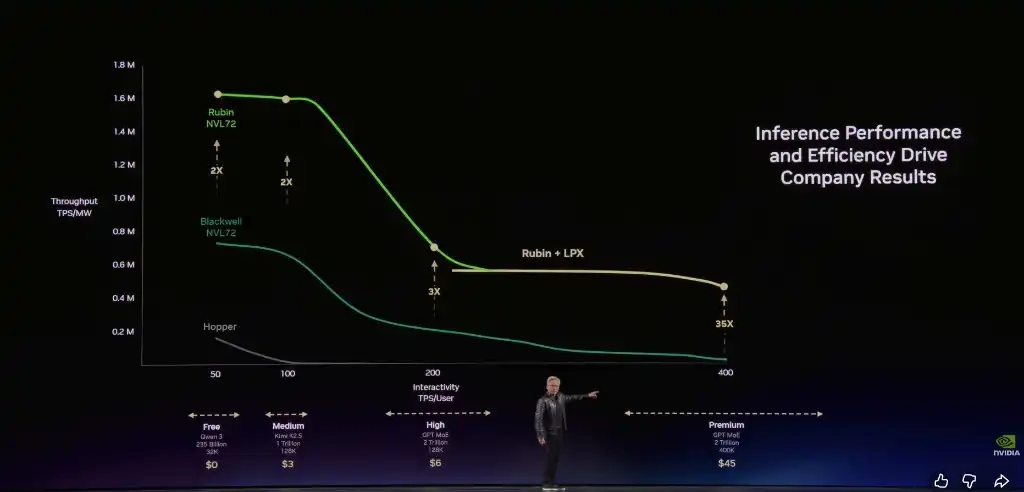
Vera Rubin은 2년 만에 350배 가속화를 실현하며, Groq는 초고속 추론을 보충합니다
물리적 한계에서, NVIDIA는 역사상 가장 복잡한 AI 컴퓨팅 시스템인 Vera Rubin을 소개했습니다. 황인훈은 말했습니다:
Hopper에 대해 이야기할 때는 칩을 들였지만 이렇게 말하면 애완동물 같습니다. 그러나 Vera Rubin에 대해 이야기할 때 모두가 전체 시스템을 떠올립니다. 이 100% 액체 냉각, 전통적인 케이블을 완전히 제거한 시스템에서, 이전에는 2일이 걸리던 랙 설치가 이제는 2시간만에 완료됩니다.
황인훈은 최고의 엔드 투 엔드 소프트웨어-하드웨어 협업 디자인으로 Vera Rubin이 동일한 1GW 데이터 센터에서 놀라운 데이터 이동을 실현했다고 강조했습니다:
단 두 해 안에 우리는 토큰 생성 속도를 2200만에서 70억으로 높였으며 350배 성장했습니다. 이 기간 동안 모어의 법칙은 약 1.5배의 성능 향상만을 가져왔습니다.
1000 토큰/초와 같은 초고속 추론 조건에서 대역폭 병목 현상을 해결하기 위해 NVIDIA는 인수한 Groq의 최종 솔루션인 비대칭 분리 추론을 제시했습니다.
황인훈은 말했습니다:
이 두 프로세서의 특징은 완전히 다릅니다. Groq 칩은 500MB의 SRAM을 보유하고 있으며, 한 개의 Rubin 칩은 288GB의 메모리를 가지고 있습니다.
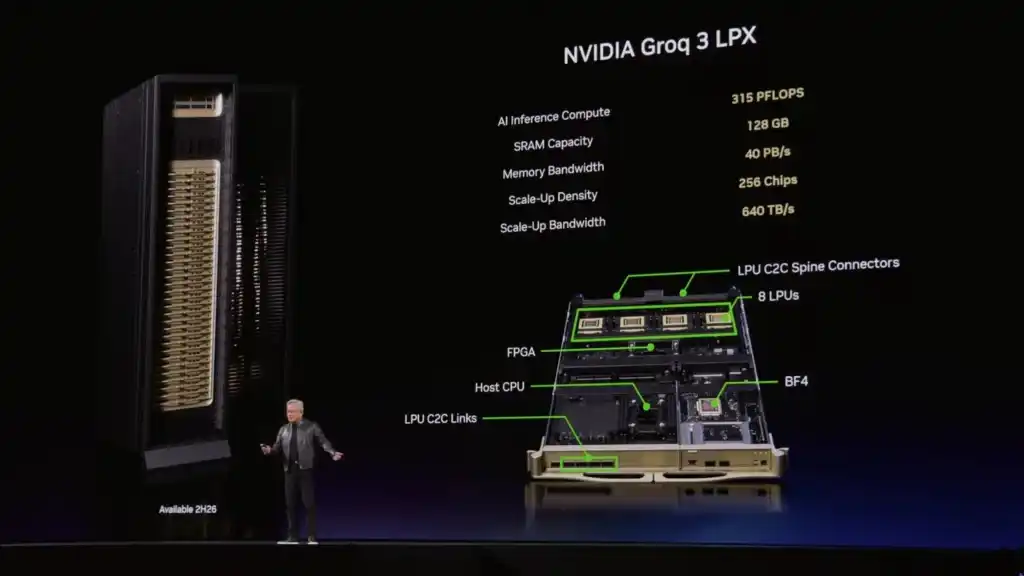
황인훈은 NVIDIA가 Dynamo 소프트웨어 시스템을 통해 대규모 계산 및 메모리 요구 사항이 있는 "사전 채우기" 단계를 Vera Rubin에게 맡기고 지연에 민감한 "디코딩" 단계를 Groq에게 맡겼다고 설명했습니다. 황인훈은 기업의 컴퓨팅 자원 구성에 대한 권장 사항도 제시하였습니다:
귀하의 작업이 주로 고 처리량이면 Vera Rubin을 100% 사용하십시오. 많은 양의 고가치 프로그래밍 수준의 토큰 생성 요구가 있는 경우 데이터 센터 규모의 25%를 Groq에 할당하십시오.
알려진 바에 의하면 삼성 파운드리에서 양산된 Groq LP30 칩은 제조되어 있으며, 제3분기에 선적될 예정이며, 최초의 Vera Rubin 랙은 Microsoft Azure 클라우드에서 실행 중이라고 합니다.
또한 광 통신 기술에 대한 대응으로 황인훈은 세계 최초의 양산형 코패키징 광스위치(Spectrum X)를 소개하며 "구리의 광퇴출 대 은도입" 논쟁에 종지부를 찍었습니다.
우리는 더 많은 구리 케이블 생산 능력, 더 많은 광칩 생산 능력, 더 많은 CPO 생산 능력을 필요로 합니다.
에이전트가 전통 SaaS 를 종식시키고, 「연봉+토큰」이 실리콘밸리의 표준이 되었습니다
하드웨어 장벽 외에도, 황인훈은 AI 소프트웨어와 생태계의 혁명에 많은 공간을 두었는데, 특히 에이전트(인공지능 에이전트)의 급격한 발전에 초점을 맞췄습니다.
그는 오픈소스 프로젝트 OpenClaw를 '인류 역사상 가장 인기 있는 오픈소스 프로젝트'로 묘사하며, 몇 주 만에 Linux가 30년 동안 이룬 성과를 뛰어넘었다고 말했습니다. 황인훈은 OpenClaw를 본질적으로 에이전트 컴퓨터의 '운영 체제'로 설명했습니다.
황인훈은 다음과 같이 주장했습니다:
모든 SaaS(소프트웨어 서비스) 회사가 AaaS(에이전트-서비스, 인공지능 에이전트 서비스) 회사로 변모할 것입니다. 확실한 것은, 액세스 가능한 데이터 및 코드 실행 기능을 갖춘 이러한 에이전트를 안전하게 구현하기 위해, NVIDIA는 기업용 NeMo Claw 참조 설계를 출시하여 정책 엔진과 프라이버시 라우터를 추가했습니다.
일반 직장인들에게도 이 변화는 가까운 미래에 있습니다. 황인훈은 미래 직장의 새로운 모습을 묘사했습니다:
미래에는 저희 회사의 모든 엔지니어가 연차 토큰 예산을 갖춰야 합니다. 그들의 기본 연봉은 수십만 달러일 수 있으며, 이를 바탕으로 약 절반의 금액을 토큰 할당량으로 제공하여 그들이 10배의 효율성을 달성할 수 있도록 합니다.이것은 이미 실리콘밸리의 새로운 채용 칩으로 : 당신의 제안서에 얼마나 많은 토큰이 있나요?
마지막으로, 황인훈은 추후 세대의 컴퓨팅 아키텍처인 페이만에 대한 정보를 미리 발표했는데, 이는 구리 선과 CPO의 공동 수준 확장을 최초로 실현할 것입니다. 더 환상적인 것은, NVIDIA가 우주에 배치될 데이터 센터 컴퓨터 '베라 루빈 스페이스-1'을 개발 중이며, 지구 바깥으로 인공지능 연산 능력을 완전히 확장시키는 상상력을 열어줍니다.
황인훈의 GTC 2026 연설 풀 텍스트는 다음과 같습니다 (AI 도구 보조):
주최자: NVIDIA의 창립자 겸 CEO 황인훈을 환영합니다.
황인훈, 창립자 겸 CEO: GTC에 오신 것을 환영합니다. 여러분에게 알릴 점이 있습니다. 이는 기술 컨퍼런스입니다. 아침 일찍 많은 사람들이 줄을 서서 입장하고, 이곳에 앉아 계신 모습을 보니 정말 기쁩니다.
GTC에서는 기술, 플랫폼 및 생태계라는 세 가지 주제에 초점을 맞출 것입니다.
현재 NVIDIA는 세 가지 주요 플랫폼을 보유하고 있습니다: CUDA-X 플랫폼, 시스템 플랫폼 및 최근 출시된 AI 팩토리 플랫폼.
공식 시작 전에, 저는 우리의 프리히트 세션 호스트인 Conviction의 Sarah Guo, Sequoia Capital의 Alfred Lin(NVIDIA의 최초 벤처 투자자), 그리고 NVIDIA의 주요 기관 투자자인 Gavin Baker에게 감사의 인사를 드립니다. 이 세 분은 기술에 대한 깊은 통찰력을 가지고 있으며 기술 생태계 전반에 거대한 영향력을 행사하고 있습니다. 물론, 오늘 참석해 주신 모든 초청한 VIP 분들에게도 감사의 말씀을 드립니다. 이 환상적인 팀에게 감사드립니다.
오늘 참석한 모든 기업에게도 감사의 말씀을 전합니다. NVIDIA는 플랫폼 기업이며 기술, 플랫폼 및 풍부한 생태계를 보유하고 있습니다. 오늘 참석한 기업은 1조 달러 규모의 산업에서 대부분의 참가자를 대표하며, 총 450개 기업이 이 행사를 후원했음을 감사히 여깁니다.
본 대회에는 1,000개의 기술 포럼, 2,000명의 연설자가 마련되어 있으며, 인공지능 "5단계 케이크" 아키텍처의 각 단계에 대해 다룰 예정입니다—기반 시설인 땅, 전력 및 데이터 센터부터 칩, 플랫폼, 모델 및 산업 전반을 변화시키는 다양한 응용프로그램까지.
CUDA: 20년의 기술 발전
모든 것의 시작은 여기에 있었습니다. 올해는 CUDA가 탄생한 지 20주년입니다.
20년간, 우리는 이 아키텍처에 전념해 왔습니다. CUDA는 혁신적인 발명품입니다—SIMT(단일 명령어 다중 스레드) 기술은 개발자가 스칼라 코드로 프로그램을 작성하고, 이를 다중 스레드 애플리케이션으로 확장할 수 있게 하였으며, 이는 이전 SIMD 아키텍처보다 훨씬 적은 프로그래밍 난이도를 요구합니다. 최근에는 개발자가 텐서 코어(Tensor Core)를 더 쉽게 프로그래밍할 수 있도록 하는 Tiles 기능을 추가했으며, 오늘날의 인공지능에서 필수적인 다양한 수학 연산 구조에 대한 지원도 제공합니다. 현재, CUDA에는 수천 가지 도구, 컴파일러, 프레임워크 및 라이브러리가 있으며, 수십만 개의 오픈 소스 프로젝트가 오픈 소스 커뮤니티에 존재하며, 모든 기술 생태계에 깊숙이 통합되어 있습니다.
이 차트는 NVIDIA의 100% 전략적 논리를 보여주는데, 나는 처음부터 계속 이 차트에 대해 이야기했다. 가장 어렵고 핵심적인 요소는 차트 하단의 "설비 용량"입니다. 20년 동안, 우리는 세계적으로 수십억 개의 CUDA로 실행되는 GPU와 컴퓨팅 시스템을 축적해 왔습니다.
저희의 GPU는 모든 클라우드 플랫폼을 대상으로 하며, 거의 모든 컴퓨터 제조사와 산업에 대한 서비스를 제공합니다. CUDA의 거대한 설치 기반은 이 빙창이 계속 가속화되는 근본적인 이유입니다. 설치 기반은 개발자를 끌어들이고, 개발자들은 새로운 알고리즘을 개발하고 평가하며, 이러한 평가는 새로운 시장을 탄생시키고, 새로운 시장은 새로운 생태계를 형성하고 더 많은 기업을 끌어들입니다. 이로써 설치 기반이 계속 확장되는 것입니다 — 이 빙창은 계속해서 가속화되고 있습니다.
NVIDIA 라이브러리 다운로드 수는 놀라운 속도로 증가하고 있으며, 크기가 방대하고 속도가 계속 증가하고 있습니다. 이 빙창은 우리의 컴퓨팅 플랫폼이 대규모 응용 프로그램 및 지속적으로 등장하는 새로운 평가를 지원할 수 있게 합니다.
더 중요한 것은 이러한 기반 시설에 매우 긴 수명을 부여한다는 것입니다. 그 이유는 분명합니다: NVIDIA CUDA에서 실행할 수 있는 응용 프로그램은 매우 다양하며, AI 수명주기의 각 단계, 각종 데이터 처리 플랫폼 및 다양한 과학 원리 해결사를 포함합니다. 그래서 일단 NVIDIA GPU를 설치하면 그 실제 사용 가치가 매우 높습니다. 이것이 왜 6년 전에 출시한 Ampere 아키텍처 GPU의 클라우드 가격이 상승한 이유입니다.
이 모든 것의 근본적인 이유는 다음과 같습니다: 거대한 설치 기반, 강력한 빙창, 광범위한 개발자 생태계가 협력하고 있을 때, 그리고 우리가 소프트웨어를 계속 업데이트하는 경우, 계산 비용은 지속적으로 감소할 것입니다. 계산을 가속화함으로써 애플리케이션 성능을 크게 향상시키는 동시에, 우리가 장기간 지원하고 소프트웨어를 지속적으로 개선함에 따라, 사용자는 초기에 성능 향상을 경험할 뿐만 아니라 지속적으로 계산 비용 감소 혜택을 누릴 수 있습니다. 우리는 전 세계의 모든 GPU를 장기간 지원하기를 원합니다, 왜냐하면 그들은 아키텍처적으로 완전히 호환되기 때문입니다.
우리가 이렇게 하려는 이유는 설치 기반이 매우 방대하기 때문입니다 — 새로운 최적화를 발표할 때마다 수백만 명의 사용자가 혜택을 받을 수 있기 때문입니다. 이러한 동적 조합은 NVIDIA 아키텍처가 지속적으로 보급 범위를 확대하고 내부 성장을 가속화하면서 동시에 계산 비용을 지속적으로 낮췄다가 새로운 성장을 촉진합니다. CUDA가 이 모든 것의 핵심 입니다.
GeForce에서 CUDA로: 25년 변천의 여정
그리고 CUDA와의 여정은 사실 25년 전에 시작되었습니다.
GeForce — 여기에 계신 분들 중 많은 분들이 GeForce와 함께 성장해 오신 것을 믿습니다. GeForce는 NVIDIA의 가장 성공한 마케팅 프로젝트 중 하나입니다. 우리는 여러분이 제품을 살 여유가 없던 시기부터 미래의 고객을 양성하기 시작했습니다 — 여러분 대신 여러분의 부모님께서 우리 최초의 사용자로 등장하셨고, 매년 우리 제품을 구매하시다가 어느 날 여러분이 우수한 컴퓨터 과학자로 성장하여 진정한 의미에서의 고객과 개발자가 되셨습니다.
25년 전에 지포스가 놓은 토대입니다. 25년 전, 우리는 프로그래밍 가능한 셰이더를 발명했습니다. 이것은 가속기를 프로그래밍 가능하게 만든 뚜렷하고 의미 있는 발명으로, 세계 최초의 프로그래밍 가능 가속기인 픽셀 셰이더였습니다. 그 후 5년 뒤, 우리는 CUDA를 만들었습니다. 이것은 우리의 역사상 가장 중요한 투자 중 하나였습니다. 그 당시 회사의 재정은 제한되어 있었지만, 우리는 대부분의 이익을 이에 투자했고 CUDA를 지포스에서 모든 컴퓨터로 확장하는 데 전념했습니다. 우리는 이 가능성을 깊이 믿기 때문에 이렇게 강력하게 나아갔습니다. 초기에는 어려움이 있었지만, 회사는 13세대, 정확히 20년 동안 이 믿음을 지켜왔고 이제 CUDA는 어디에나 있습니다.
픽셀 셰이더가 지포스 혁명을 주도했습니다. 그리고 약 8년 전, 우리는 RTX를 출시했습니다. 이는 현대 컴퓨터 그래픽 시대를 위해 아키텍처를 완전히 혁신했습니다. 지포스는 CUDA를 전 세계에 보급시켰으며, 이로써 Alex Krizhevsky, Ilya Sutskever, Geoffrey Hinton, Andrew Ng 등 많은 학자들이 GPU가 심층 학습을 가속화하는 데 도구로 사용될 수 있다는 것을 발견했고, 이로써 10년 전 인공 지능 폭발의 불씨를 피웠습니다.
10년 전, 우리는 프로그래밍 가능 셰이더를 두 가지 새로운 개념과 접목하기로 결정했습니다: 첫 번째는 하드웨어 레이 트레이싱(Ray Tracing), 기술적으로 매우 도전적이었습니다. 두 번째는 당시에는 선도적인 생각이었던 것——약 10년 전, 우리는 인공 지능이 컴퓨터 그래픽을 완전히 변혁시킬 것으로 예견했습니다. 지포스가 전 세계에 AI를 가져온 것과 같이, AI는 지금 컴퓨터 그래픽 전체의 구현 방식을 바꾸고 있습니다.
오늘, 저는 여러분에게 미래를 보여 드리겠습니다. 이것은 우리의 다음 세대 그래픽 기술로, 우리는 이를 신경 렌더링(Neural Rendering)이라고 부릅니다 — 3D 그래픽과 인공 지능의 심층 융합. 이것이 바로 DLSS 5입니다. 확인해주세요.
신경 렌더링: 구조화된 데이터와 생성적 AI의 융합
이게 놀라운 거 아닌가요? 컴퓨터 그래픽이 여기서부터 새로워졌습니다.
우리가 한 일은 무엇일까요? 우리는 제어 가능한 3D 그래픽(가상 세계의 실제 기초)을 해당 구조화된 데이터와 결합하고, 생성적 AI와 확률적 계산을 결합했습니다. 완전한 결정론적 방법과 높은 현실성의 확률적 방법 — 우리는 이 두 가지 개념을 통합하여 구조화된 데이터로 정확하고 제어 가능한 결과물을 달성하고 동시에 실시간 생성을 수행했습니다. 최종적으로 콘텐츠는 아름답고 멋지며 완전히 제어 가능합니다.
구조화된 정보와 생성 모델 AI의 융합이라는 개념은 각 산업에서 지속적으로 재현될 것입니다. 구조화된 데이터는 믿을 수 있는 AI의 기반입니다.
구조화된 데이터와 비구조화된 데이터의 가속 플랫폼
이제 여러분께 기술 아키텍처 다이어그램을 보여드리겠습니다.
구조화된 데이터 - 익숙한 SQL, Spark, Pandas, Velox 및 Snowflake, Databricks, Amazon EMR, Azure Fabric, Google BigQuery와 같은 중요한 플랫폼은 데이터 프레임을 처리합니다. 이러한 데이터 프레임은 거대한 스프레드시트처럼 비즈니스 세계의 모든 정보를 담고 있으며 기업 컴퓨팅의 기본 사실(Ground Truth)입니다.
AI 시대에는 AI가 구조화된 데이터를 사용하고 그것을 극한 가속화해야 합니다. 과거에는 구조화된 데이터 처리를 가속화하여 기업이 더 효율적으로 운영할 수 있도록 했습니다. 그러나 미래에는 AI가 이러한 데이터 구조를 훨씬 뛰어넘는 속도로 활용하고 AI 에이전트도 구조화된 데이터베이스를 대규모로 호출할 것입니다.
비구조화된 데이터 부분에서는 벡터 데이터베이스, PDF, 비디오, 오디오 등이 전 세계 대부분의 데이터 형태를 구성합니다. 연간 생성되는 데이터 중 약 90%가 비구조화된 데이터입니다. 과거에는 이러한 데이터를 거의 활용할 방법이 없었습니다. 우리는 데이터를 읽고 파일 시스템에 저장할 뿐이었습니다. 쿼리할 수도 없고 검색하기도 어려웠는데 비구조화된 데이터는 간단한 색인 방법이 없으며 의미와 맥락을 이해해야 합니다. 그러나 지금은 AI가 이를 수행할 수 있습니다. - 멀티모달 지각 및 이해 기술을 활용하여 AI는 PDF 문서를 읽고 의미를 이해하며 쿼리 가능한 더 큰 구조체에 임베딩할 수 있습니다.
NVIDIA는 이를 위해 두 개의 라이브러리를 생성했습니다:
· cuDF: 데이터 프레임 및 구조화된 데이터의 가속 처리에 사용됨
· cuVS: 벡터 스토리지, 의미 데이터 및 비구조화된 AI 데이터 처리에 사용됨
이 두 플랫폼은 미래의 주요 기반 플랫폼 중 하나가 될 것입니다.
오늘, 저희는 다수의 기업과 파트너십을 체결했다고 발표합니다. IBM - SQL 언어의 창시자는 cuDF를 사용하여 WatsonX Data 플랫폼을 가속화할 것입니다. Dell은 cuDF와 cuVS를 통합하여 Dell AI 데이터 플랫폼을 공동으로 구축했으며 NTT Data의 프로젝트에서 성능을 대폭 향상시켰습니다. Google Cloud 측에서는 우리가 Vertex AI뿐만 아니라 BigQuery도 가속화하고 있으며 Snapchat과 협력하여 계산 비용을 거의 80% 절감했습니다.
가속 컴퓨팅의 이점은 세 가지 측면에서 나타납니다: 속도, 규모, 비용. 이는 모어의 법칙에 따른 논리를 따르며—가속 컴퓨팅을 통해 성능을 비약적으로 향상시키고 동시에 알고리즘을 지속적으로 최적화하여 전 세계적으로 계속해서 하락하는 계산 비용을 모든 사람이 누릴 수 있도록 합니다.
엔비디아는 가속 컴퓨팅 플랫폼을 구축했으며, 여기에는 다양한 라이브러리가 모여 있습니다: RTX, cuDF, cuVS 등이 있습니다. 이러한 라이브러리는 전 세계의 클라우드 서비스 및 OEM 생태계로 통합되어 전 세계 사용자에게 도달합니다.
클라우드 서비스 업체와의 심층 협력
주요 클라우드 서비스 업체와의 협력
Google Cloud: 우리는 Vertex AI와 BigQuery를 가속화하고, JAX/XLA와 깊게 통합하며, PyTorch에서 우수한 성능을 발휘합니다—엔비디아는 PyTorch와 JAX/XLA에서 우수한 성능을 보이는 전 세계에서 유일한 엑셀러레이터입니다. 우리는 Base10, CrowdStrike, Puma, Salesforce 등 고객을 Google Cloud 생태계로 유입시킵니다.
AWS: 우리는 EMR, SageMaker 및 Bedrock를 가속화하고, AWS와 깊게 통합합니다. 올해 특히 기대되는 사항은 OpenAI를 AWS로 유입시킬 것이며, 이는 AWS의 클라우드 컴퓨팅 소비를 크게 증가시키고, OpenAI의 영역 배포와 계산 규모를 확대하는 데 도움이 될 것입니다.
Microsoft Azure: 엔비디아 100 PFLOPS 초고속 컴퓨터는 저희가 구축한 첫 번째 슈퍼 컴퓨터이자 Azure에 배포된 첫 번째 슈퍼 컴퓨터로, 이는 OpenAI와의 중요한 협력 기반이 됩니다. 우리는 Azure 클라우드 서비스와 AI Foundry를 가속화하고, Azure 지역 확장을 촉진하며 Bing 검색에서 깊이 협업합니다.
강조할 만한 점은 저희의 "기밀 컴퓨팅(Confidential Computing)" 능력입니다—운영 업체조차도 사용자 데이터와 모델을 볼 수 없도록 보장합니다—엔비디아 GPU는 전 세계에서 최초로 기밀 컴퓨팅을 지원하는 GPU 중 하나이며, OpenAI와 Anthropic 모델이 전 세계의 클라우드 환경에서 기밀으로 배포될 수 있도록 지원합니다. Synopsys 같은 경우, 우리는 그들의 모든 EDA 및 CAD 워크플로우를 가속화하고 Microsoft Azure에 배포했습니다.
Oracle: 우리는 Oracle의 최초 AI 고객이며, Oracle에 AI 클라우드 컨셉을 처음 설명할 수 있었음에 자랑스럽게 생각합니다. 그 이후 그들은 급속히 성장했고, 우리는 Cohere, Fireworks, OpenAI 등 다수의 파트너를 소개할 수 있었습니다.
CoreWeave: 세계 최초의 AI 네이티브 클라우드로, GPU 호스팅 및 AI 클라우드 서비스를 위해 설계되었으며, 우수한 고객 기반과 강력한 성장세를 갖고 있습니다.
Palantir + Dell: 셋이 함께 새로운 AI 플랫폼을 개발했으며, Palantir의 온톨로지 플랫폼(Ontology Platform)과 AI 플랫폼을 기반으로 하여 어떤 국가나 환경에서도 완전 로컬라이즈된 AI를 배포할 수 있는 플랫폼을 만들었습니다. 데이터 처리(벡터화 또는 구조화)부터 AI의 완전 가속화된 계산 스택까지 모든 것이 포함되어 있습니다.
NVIDIA와 세계적인 클라우드 서비스 제공업체는 이 특별한 협업을 구축했습니다 - 우리는 고객을 클라우드로 유인하며, 이는 상호 이익을 가져다주는 생태계입니다.
Vertical Integration, Horizontal Openness: NVIDIA's Core Strategy
NVIDIA는 세계 최초의 수직통합, 수평개방 회사입니다.
이 모델의 필요성은 매우 간단합니다: 가속 계산은 칩 문제도 시스템 문제도 아니며, 아플리케이션 가속이라는 완전한 개념으로 표현되어야 합니다. CPU는 컴퓨터를 전반적으로 빠르게 만들 수 있지만, 이 길은 한계에 다다랐습니다. 미래에는 애플리케이션 또는 도메인별 가속으로 성능 향상과 비용 절감을 계속 실현할 수 있습니다.
이것이 바로 NVIDIA가 각각의 라이브러리, 각각의 도메인, 각각의 산업에 깊이 파고들어야 하는 이유입니다. 우리는 수직통합 컴퓨팅 회사이며, 더 갈 길이 없습니다. 우리는 애플리케이션을 이해하고, 도메인을 이해하며, 알고리즘을 깊이 이해하고, 어떤 상황에서든 배포할 수 있어야 합니다 - 데이터 센터, 클라우드, 로컬, 엣지, 심지어 로봇 시스템까지.
동시에, NVIDIA는 수평 개방을 유지하며, 기술을 어떤 파트너 플랫폼으로도 통합하고, 세계 모두가 가속 계산의 혜택을 누릴 수 있도록 합니다.
이번 GTC의 참가자 구성은 이를 충분히 보여줍니다. 금융 서비스 업종의 참가 비율이 가장 높으며- 왔으면 하는 것은 거래자가 아닌 개발자입니다. 우리의 생태계는 상류 및 하류 공급망을 모두 포괄합니다. 50년, 70년 또는 150년이 되는 기업이라도, 지난해가 최고 기록이었습니다. 우리는 매우, 매우 중요한 일의 시작점에 있습니다.
CUDA-X: 각 산업을 위한 가속화 계산 엔진
각 수직 분야에서, NVIDIA는 심층적으로 진출했습니다:
자율 주행: 폭넓게 적용되며 깊은 영향을 미침
금융 서비스: 양자 투자가 인공 특징 엔지니어링에서 초전력 계산 머신러닝으로 전환되며, 그들의 'Transformer Moment'를 맞이하고 있음
의료 보건: 자신만의 'ChatGPT Moment'를 맞이하고 있으며, AI 보조 의약품 발견, AI 지원 진단, 의료 고객 서비스 등을 포함함
산업: 세계 최대 규모의 건설 파도가 전개 중이며, AI 공장, 칩 공장, 데이터 센터 공장이 차례대로 출범
엔터테인먼트 및 게임: 실시간 AI 플랫폼은 번역, 라이브 방송, 게임 상호 작용 및 스마트 쇼핑 대리점을 지원함
로봇: 10년 이상의 긴 시간 동안 심층적으로 연구하여, 기계학습 컴퓨터, 시뮬레이션 컴퓨터, 비행 컴퓨터의 세 가지 컴퓨터 아키텍처가 완비되어 있으며, 본 전시회에서 총 110대의 로봇이 등장함
통신: 약 2조 달러 규모의 산업으로, 기지국은 단일 통신 기능에서 AI 기반 인프라 플랫폼으로 진화하고 있으며, 해당 플랫폼 명칭은 Aerial이며, 노키아, T-Mobile 등 기업들과 깊은 협력을 하고 있음
상기 모든 분야의 핵심은 저희의 CUDA-X 라이브러리입니다—이는 알고리즘 회사로서의 NVIDIA의 근간입니다. 이러한 라이브러리는 회사의 가장 핵심적인 자산으로, 계산 플랫폼이 각 분야에서 실제 가치를 발휘할 수 있도록 합니다.
그 중 가장 중요한 라이브러리 중 하나는 cuDNN(CUDA 심층 신경망 라이브러리)로, 이는 인공 지능을 근본적으로 변혁시키며, 현대 AI의 대폭발을 야기했습니다.
(CUDA-X 시연 비디오 재생)
여러분이 방금 보신 것은 시뮬레이션입니다—물리학 원리 기반 해석기, AI 에이전트 물리 모델, 물리 AI 로봇 모델을 포함한 것입니다. 모든 것이 시뮬레이션으로, 어떠한 수동 애니메이션 또는 조인트 바인딩도 없습니다. 이것이바로 NVIDIA의 핵심 역량입니다: 알고리즘에 대한 심층적 이해와 계산 플랫폼의 유기적 결합을 통해, 이러한 기회들을 끌어내는 것.
AI 원생 기업과 새로운 컴퓨팅 시대
방금 월마트, 로레알, 모건 스탠리, 로슈, 토요타와 같은 오늘날의 산업 거물을 보았습니다. 또한 우리가 듣지 못한 많은 회사들이 존재하는데, 이를 AI 원생 기업이라고 합니다. 이 목록은 상당히 크며, OpenAI, Anthropic 및 다양한 산업 분야를 대상으로 하는 신흥 기업들이 포함되어 있습니다.
지난 두 해 동안이 산업은 놀라운 성장을 경험했습니다. 벤처 투자금 유입이 초기 기업에 1,500억 달러에 이르렀으며, 이는 인류 역사상 최대 규모입니다. 더 중요한 것은, 개별 투자 규모가 수백만 달러에서 십억 달러로, 심지어 수십억 달러로 처음으로 급증했다는 것입니다.
이유는 단 하나뿐입니다: 이것은 역사상 처음으로, 모든 이러한 기업이 방대한 계산 자원과 대량의 토큰이 필요합니다. 이 산업은 토큰을 창조하고 관리하거나, Anthropic, OpenAI 등의 기관에서 제공하는 토큰의 가치를 높이고 있습니다.
마치 PC 혁명, 인터넷 혁명, 모바일 클라우드 혁명이 각각 시대를 앞당기는 기업을 탄생시킨 것처럼, 이 세대의 컴퓨팅 플랫폼 변화 또한 미래 세계에서 중요한 역할을 하는 영향력 있는 기업들을 낳을 것입니다.
이 모든 것을 추진하는 세 가지 역사적인 돌파
지난 두 해 동안 정확히 무슨 일이 있었나요? 세 가지 중요한 일이 있었습니다.
첫 번째: ChatGPT, 생성형 AI 시대 시작 (2022년 말부터 2023년)
그것은 지식을 인식하고 이해할 뿐만 아니라 독특한 콘텐츠를 생성할 수 있습니다. 저는 생성형 AI와 컴퓨터 그래픽의 융합을 보여드렸습니다. 생성형 AI는 컴퓨팅의 방식을 근본적으로 변화시켰습니다 — 계산이 검색에서 생성으로 변화했으며, 이는 컴퓨터 아키텍처, 배포 방식 및 전반적인 의미에 깊은 영향을 미칩니다.
두 번째: 추론 AI (Reasoning AI), o1을 대표로
추론 능력은 AI가 자체를 반성하고 계획하며, 문제를 분해할 수 있도록 합니다 — AI가 직접적으로 이해할 수 없는 문제를 처리 가능한 단계로 분해합니다. o1은 생성형 AI를 신뢰할 수 있게 만들어주며, 실제 정보에 따라 추론할 수 있습니다. 따라서 입력 콘텍스트의 토큰 양과 사고에 사용되는 출력 토큰 양이 크게 증가하고, 계산양은 상당히 증가합니다.
세 번째: Claude Code, 최초의 스마트 에이전트 모델
파일을 읽고 코드를 작성하고 컴파일하고 테스트하고 평가하며 반복할 수 있습니다. Claude Code는 소프트웨어 엔지니어링을 완전히 혁신했습니다. NVIDIA의 엔지니어 100%가 Claude Code, Codex 및 Cursor 중 하나 이상을 사용하고 있으며, 어떤 소프트웨어 엔지니어도 AI의 도움 없이 작업하지 않습니다.
이것은 새로운 전환점입니다. 이제 AI에게 "무엇, 어디, 어떻게"를 묻는 게 아니라 "생성, 실행, 구축"을 시키고, 도구를 적극적으로 활용하고, 파일을 읽고, 문제를 분해하며 행동에 옮기도록 하는 것입니다. AI는 인식부터 생성, 추론, 현재까지 실제 작업을 수행할 수 있는 단계에 이르렀습니다.
지난 2년 동안 추론에 필요한 계산량이 약 10,000배 증가했으며 사용량은 약 100배 증가했습니다. 나는 지난 2년 동안 계산 수요가 1,000,000배 증가했다고 생각해왔습니다. 이것은 모든 사람, OpenAI 및 Anthropic이 공유하는 인식입니다. 더 많은 컴퓨팅 능력을 확보하면 더 많은 토큰을 생성하여 수입이 증가하고 AI가 더 스마트해집니다. 추론의 전환점이 이미 왔습니다.
1조 달러의 AI 인프라 시대
작년 이맘때, 저희는 2026년까지 Blackwell과 Rubin의 수요 및 구매 주문에 대해 매우 높은 신뢰를 갖고 있으며 그 규모는 약 5조 달러일 것으로 예상했습니다.
오늘, GTC에서 1년 후에 여기 서서 여러분께 말씀드리는 것은: 2027년까지 내가 본 숫자는 최소 1조 달러입니다. 게다가, 실제 계산 수요는 훨씬 그 이상일 것이라고 확신합니다.
2025년: NVIDIA 추론 연도
2025년은 NVIDIA의 추론 연도입니다. 우리는 훈련 및 사후 훈련 외에도 AI 수명 주기의 모든 단계에서 우수성을 유지하고 이미 투자한 인프라가 지속적으로 효율적으로 작동하고 수명이 길어지며 개별 비용이 낮아지도록 보장하고자 합니다.
동시에, Anthropic 및 Meta가 공식적으로 NVIDIA 플랫폼에 합류했으며, 세계의 AI 계산 요구 사항의 1/3을 대표합니다. 오픈 소스 모델은 전선 수준에 접근하고 있습니다.
NVIDIA는 현재 모든 AI 영역 - 언어, 생물학, 컴퓨터 그래픽스, 컴퓨터 비전, 음성, 단백질 및 화학, 로봇학 등 - 모든 AI 모델의 플랫폼을 운영할 수 있는 유일한 글로벌 기업입니다. NVIDIA 아키텍처는 이러한 모든 시나리오에 대해 범용성을 갖추고 있으며, 이는 우리를 가장 저렴하고 가장 신뢰할 수 있는 플랫폼으로 만듭니다.
현재 NVIDIA의 60% 비즈니스가 전 세계 상위 다섯 대 권위있는 대규모 클라우드 서비스 제공업체에서 이루어지며, 나머지 40%는 지역 클라우드, 주권 클라우드, 기업, 산업, 로봇, 엣지 컴퓨팅 등 다양한 분야에 걸쳐 있습니다。AI의 광범위한 적용은 그 융통성의 핵심이며, 이것은 의심의 여지 없이 새로운 컴퓨팅 플랫폼 혁명입니다。
Grace Blackwell 및 NVLink 72: 대담한 아키텍처 혁신
Hopper 아키텍처가 전성기에 있을 때, 우리는 시스템을 철저히 재구성하기로 결정했으며, NVLink를 8레인에서 NVLink 72로 확장하여 컴퓨팅 시스템을 완전히 분해하고 재구성하였습니다. Grace Blackwell NVLink 72는 거대한 기술적인 혁신이며, 모든 협력사에게는 쉽지 않은 것이었습니다. 모든 분들께 진심으로 감사드립니다.
동시에, 우리는 NVFP4를 출시하였습니다 — 이는 일반적인 FP4가 아닌 새로운 유형의 텐서 코어와 컴퓨팅 유닛입니다. 우리는 NVFP4가 추론을 손실 없이 수행할 수 있음을 입증했으며, 동시에 큰 성능 향상과 에너지 효율 향상을 가져오며, 훈련에도 동일하게 적용됩니다.
뿐만 아니라 Dynamo 및 TensorRT-LLM과 같은 일련의 새로운 알고리즘이 연이어 등장하였으며, 최적화된 커널을 위해 수십억 달러를 투자하여 DGX Cloud라는 슈퍼 컴퓨터를 구축하였습니다.
결과적으로, 우리의 추론 성능은 눈부시게 우수합니다. Semi Analysis의 데이터 — 지금까지 가장 포괄적인 AI 추론 성능 평가로, NVIDIA가 모든 와트 토큰과 토큰 당 비용 두 가지 측면에서 압도적으로 선도한다는 것을 보여줍니다. 무어의 법칙이 H200에 1.5배의 성능 향상을 가져올 것으로 예상되었지만, 우리는 35배의 성능 향상을 이루었습니다. Semi Analysis의 Dylan Patel은 심지어 이렇게 말했습니다:「황량훈은 보수적이었고, 실제로는 50배입니다.」 그는 맞습니다.
저는 그의 말을 인용하며 말합니다: "젠슨은 손실을 엄격하게 책정했다 (Jensen sandbagged)."
NVIDIA의 토큰 당 비용은 현재 세계 최저 수준으로, 극한의 공동 설계(Extreme Co-design)에 기인합니다.
Fireworks를 예로 들면, NVIDIA가 전체 소프트웨어 및 알고리즘 패키지를 업데이트하기 전에는 평균적인 토큰 속도가 초당 약 700개였으며, 업데이트 이후에는 약 5,000개에 가까워졌으며, 약 7배 향상되었습니다. 이것이 극한의 공동 설계의 힘입니다.
AI 공장: 데이터 센터에서 토큰 공장으로
과거 데이터 센터는 파일을 저장하는 곳이었지만, 지금은 토큰을 생성하는 공장입니다. 모든 클라우드 서비스 공급업체, 모든 AI 기업은 미래에 "토큰 공장 효율성"을 핵심 경영 성과로 삼을 것입니다.
이것이 내 핵심 주장입니다:
· 세로축: 처리량(Throughput) — 고정된 전력으로 매 초 생성되는 토큰 수
· 가로축: 상호작용 속도(Token Speed) — 각 추론의 응답 속도, 속도가 빨라질수록 사용 가능한 모델이 커지고, context가 길어지며, AI가 더 지능적으로 됨
토큰은 새로운 대형 상품이며, 한 번 성숙해지면 계층별로 가격이 책정될 것입니다:
· 무료층 (고 처리량, 낮은 속도)
· 중급층 (~100만 토큰 당 3달러)
· 고급층 (~100만 토큰 당 6달러)
· 고속층 (~100만 토큰 당 45달러)
· 초고속층 (~100만 토큰 당 150달러)
Hopper와 비교하여, Grace Blackwell은 최고가치층에서 처리량을 35배 향상시키고, 새로운 층을 도입했습니다. 모델 추정을 간소화하기 위해, 25% 전력을 네 개의 층에 각각 할당하면서, Grace Blackwell은 Hopper보다 5배 많은 수익을 창출할 수 있습니다.
Vera Rubin: 다음 세대 AI 컴퓨팅 시스템
(Vera Rubin 시스템 소개 비디오 재생)
Vera Rubin은 완전한 엔드 투 엔드 최적화 시스템으로, 에이전틱(Agentic) 워크로드를 위해 설계되었습니다:
· 대규모 언어 모델 계산 코어: NVLink 72 GPU 클러스터, 프리필(Prefill) 처리 및 KV 캐시
· 새로운 Vera CPU: 극한 단일 스레드 성능을 위해 설계되었으며, LPDDR5 메모리를 사용하며 우수한 전력 효율성을 갖추고 있습니다. LPDDR5를 사용하는 전 세계 유일한 데이터 센터 CPU이며, AI 에이전트 도구 호출에 적합합니다
· 저장 시스템: BlueField 4 + CX 9, AI 시대를 위한 새로운 저장 플랫폼, 글로벌 스토리지 산업의 100%가 CPO Spectrum X 스위치에 가입함: 세계 최초의 옵티컬 이더넷 스위치, 이미 대량 생산 중
· Kyber 랙: 새로운 랙 시스템, 144개의 GPU를 지원하는 단일 NVLink 도메인, 프런트엔드 컴퓨팅, 백엔드 NVLink 스위치, 거대한 컴퓨터 생성
· Rubin Ultra: 다음 세대 초고속 컴퓨팅 노드, 수직 삽입식 디자인, Kyber 랙과 함께 사용하여 보다 대규모의 NVLink 연결을 지원함
Vera Rubin은 이미 100% 액체 냉각을 도입해 설치 시간이 2일에서 2시간으로 단축되었으며, 45°C 열 수소 냉각 시스템을 사용하여 데이터 센터 냉각 압력을 크게 줄였습니다. Satya (나들라)가 이미 Vera Rubin 랙이 마이크로소프트 Azure에서 온라인 상태로 가동 중임을 확인하는 글을 게시했으며, 이에 대해 큰 감격을 느낍니다.
Groq 통합: 추론 성능의 극한 확장
우리는 Groq 팀을 인수하고 기술 라이선스를 받았습니다. Groq는 결정론적 데이터 플로우 프로세서로, 정적 컴파일 및 컴파일러 스케줄링을 적용하고 대량의 SRAM을 보유하여 단일 추론 워크로드에 최적화되었으며, 매우 낮은 대기 시간과 높은 토큰 생성 속도를 갖추고 있습니다.
그러나 Groq의 메모리 용량은 제한적이며(500MB 온칩 SRAM), 대규모 모델의 매개변수 및 KV 캐시를 독립적으로 처리하기 어렵다는 제약이 있어 대규모 응용이 어렵습니다.
해결책은 바로 Dynamo - 추론 스케줄링 소프트웨어입니다. 우리는 Dynamo을 통해 추론 파이프라인을 분해합니다:
· 프리필(Pre-fill) 및 어텐션 메커니즘 디코딩(Decode): Vera Rubin에서 완료(대규모 컴퓨팅 및 KV 캐시 저장소 필요)
· 피드포워드 네트워크 디코딩(Feed-Forward Network Decode): 즉, 토큰 생성 부분, Groq에서 완료(매우 높은 대역폭 및 낮은 대기 시간 필요)
두 기기는 이더넷을 통해 밀접하게 결합되어 지연을 대략 절반으로 줄이는 특별한 모드를 활용합니다. 'AI 공장 운영 체제' Dynamo의 통합 스케줄링으로 전반적인 성능이 35배 향상되었으며, 이전에는 접근할 수 없었던 NVLink 72의 새로운 추론 성능 계층이 열렸습니다.
Groq 및 Vera Rubin의 조합 제안:
작업 부하가 대량 스루풋을 중시하는 경우 100% Vera Rubin을 사용하고, 코드 생성 및 고가 값 토큰 생성과 같은 대량 작업 부하가 있는 경우
Groq를 도입하고, 제안 비율은 약 25% Groq + 75% Vera Rubin입니다. Groq LP30은 삼성에서 생산되었으며 현재 양산 중이며, Q3에 선적이 시작될 예정입니다. 삼성의 전력적인 협조에 감사드립니다.
추론 성능의 역사적인 돌파
기술 발전을 양으로 나타냅니다. 2년간 1기가 와트의 AI 공장에서의 토큰 생성 속도가 2,200만 토큰/초에서 70억 토큰/초로 증가하여 350배 향상되었습니다. 이것이 바로 극한 협력 디자인의 힘입니다.
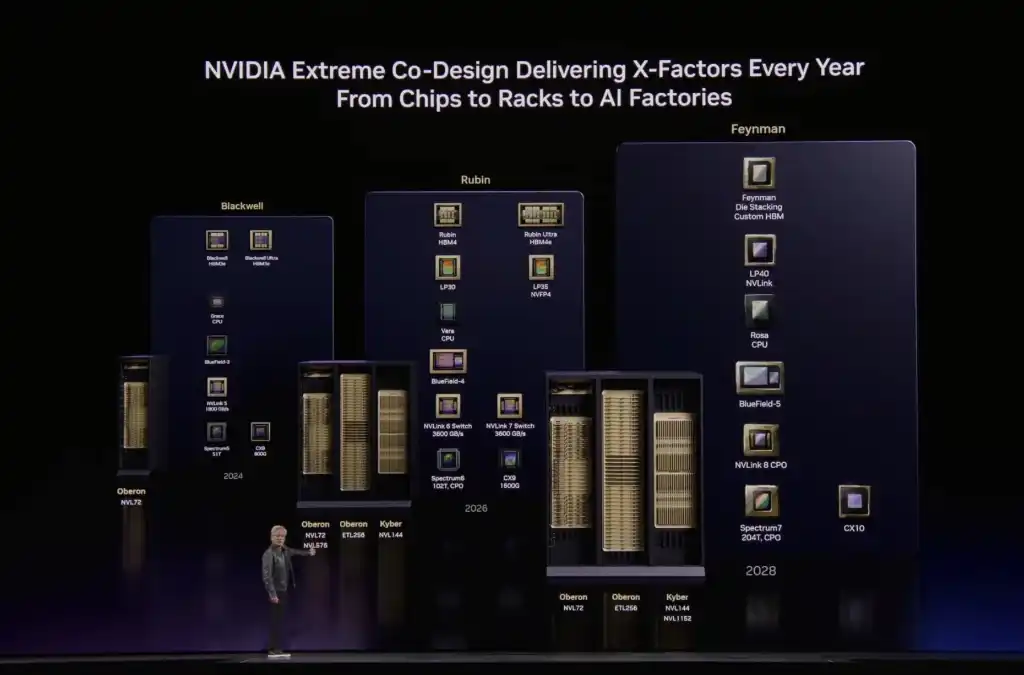
기술 로드맵
· Blackwell: 현재 생산 중, Oberon 표준 랙 시스템, NVLink 72까지 구리 케이블 확장, 옵션으로 NVLink 576까지 광학 확장
· Vera Rubin(현재): Kyber 랙, NVLink 144(구리 케이블); Oberon 랙, NVLink 72 + 광학, NVLink 576까지 확장; Spectrum 6, 세계 최초의 CPO 스위치
· Vera Rubin Ultra(출시 예정): 새로운 세대 Rubin Ultra GPU, LP35 칩(최초 NVFP4 통합), 성능 향상
· Feynman(다음 세대): 새로운 GPU, LP40 칩(NVIDIA 및 Groq 팀이 공동으로 제작, NVFP4 통합); 새로운 CPU - Rosa(Rosalyn); BlueField 5; CX 10; 구리 케이블 및 CPO 2가지 확장 방식 지원 Kyber 랙
로드맵 명확: 구리 [Copper] 케이블 확장, 스케일 업 광 확장, 스케일 아웃 광 확장 세 가지 경로가 병행으로 진행되고 있으며, 모든 파트너가 구리, 광섬유 및 CPO 측면에서 지속적으로 생산 확대가 필요합니다.
NVIDIA DSX: AI 팩토리의 디지털 미러링 플랫폼
AI 팩토리는 점점 더 복잡해지고 있으나 그 구성원들은 과거에는 상호 협력하지 않았으며, 디자인 단계에서는 서로 만날 기회가 없었습니다. 이에 디지털 트윈을 만들었고, 이를 기반으로 한 NVIDIA DSX 플랫폼을 만들었습니다—이는 가짜 인공지능 공장을 가상 세계에서 공동 설계하고 운영할 수 있는 플랫폼입니다.DSX는 다음을 제공합니다:
· 랙 수준의 기계적, 열적, 전기적, 네트워크 시뮬레이션 시스템
· 그리드 연결을 통한 공동 에너지 절약 스케줄링
· 데이터 센터 내부의 Max-Q 기반의 동적 전력 및 냉각 최적화
수용적인 추정에 따르면 이러한 시스템은 에너지 효율성을 약 두 배 향상시킬 수 있으며, 이는 우리가 다루고 있는 규모에서 상당한 이익입니다. Omniverse는 디지털 지구에서 시작하여 다양한 규모의 디지털 미러링을 수용하며, 우리는 인류 역사상 가장 큰 컴퓨터를 공동으로 구축하고 있습니다.
게다가, NVIDIA는 우주로 발을 내딛고 있습니다. Thor 칩은 방사선 인증을 통과하고 있으며, 위성에서 실행 중입니다. 우리는 우주 데이터 센터 구축을 위한 Vera Rubin Space-1을 개발 중이며, 우주 공간에서는 방사선 냉각에 의존해야 하므로 열 관리가 핵심 과제입니다. 우리는 최고의 엔지니어들을 모아 도전하고 있습니다.
OpenClaw: 에이전트 시대의 운영 체제
Peter Steinberger가 개발한 OpenClaw라는 소프트웨어가 있습니다. 이것은 인류 역사상 가장 인기 있는 오픈 소스 프로젝트로, 단 몇 주 만에 30년의 Linux 성과를 뛰어넘었습니다.
OpenClaw는 본질적으로 에이전트 시스템이며, 다음을 할 수 있습니다:
· 리소스 관리, 도구, 파일 시스템 및 대형 언어 모델 액세스
· 실행 스케줄링, 타이머 작업
· 문제를 단계적으로 분해하고 서브 에이전트를 호출합니다
· 음성, 비디오, 텍스트, 이메일 등 임의의 모드의 입력 및 출력을 지원합니다
운영 체제 구문을 사용하여 그것은 실제로 운영 체제입니다 - 에이전트 컴퓨터의 운영 체제입니다. Windows는 개인용 컴퓨터를 가능하게 했고, OpenClaw는 개인용 에이전트를 가능하게 합니다.
모든 기업은 자사의 OpenClaw 전략을 수립해야 하며, 우리가 Linux 전략, HTML 전략, Kubernetes 전략이 필요한 것과 마찬가지입니다.
기업 IT의 전면 재구성
OpenClaw 이전의 기업 IT: 데이터와 파일이 시스템에 입력되고, 도구와 워크플로를 통해 흐르며, 결국 인간이 사용하는 도구로 변환됩니다. 소프트웨어 회사는 도구를 작성하고, 시스템 통합 업체(GSI) 및 컨설팅 회사가 기업이 이러한 도구를 사용하는 데 도움을 줍니다.
OpenClaw 이후의 기업 IT: 모든 SaaS 기업은 AaaS(Agentic as a Service, 에이전트 인 서비스) 기업으로 변모할 것입니다 - 도구뿐만 아니라 특정 AI 영역에 특화된 인공 지능 에이전트를 제공합니다.
하지만 여기에 중요한 도전 과제가 있습니다: 내부 기업 에이전트는 민감한 데이터에 액세스하고, 코드를 실행하며, 외부와 통신할 수 있습니다. 기업 환경에서는 엄격히 통제되어야 합니다.
이를 위해 우리는 Peter와 협력하여 보안을 기업용 버전에 통합하고 다음을 출시했습니다:
· NeMo Claw(참조 설계): OpenClaw를 기반으로 한 기업용 참조 프레임워크, NVIDIA의 전체 에이전트 AI 툴킷 통합
· Open Shield(보안 층): OpenClaw에 통합되어 기업 데이터 안전을 보장하는 정책 엔진, 네트워크 펜스, 프라이버시 라우팅을 제공합니다
· NeMo Cloud: 다운로드하여 사용 가능하며, 모든 SaaS 기업의 정책 엔진과 통합됩니다
이것은 기업 IT의 르네상스, 원래 2조 달러 규모의 산업이 수조 달러 규모로 성장하며, 도구 제공에서 전문화된 AI 에이전트 서비스 제공으로 전환하는 것입니다.
저는 완전히 예견할 수 있습니다: 미래에는 회사의 모든 엔지니어가 연간 토큰 예산을 보유할 것입니다. 그들의 연봉이 수십만 달러일지라도, 저는 그들에게 연봉의 절반에 해당하는 토큰 할당량을 추가로 주어 그들의 생산성을 10배로 증가시킬 것입니다. 「입사 시 얼마나 많은 토큰 할당량이 제공되는가」는 이미 실리콘밸리의 최신 채용 주제가 되었습니다.
미래의 각 기업은 토큰의 사용자(엔지니어용)이자 토큰의 생성자(고객에게 서비스 제공)가 될 것입니다. OpenClaw의 중요성은 과소평가될 수 없으며, 그것은 HTML이나 Linux와 같이 중요합니다.
NVIDIA 오픈 모델 이사회
맞춤형 Claw 측면에서, 우리는 NVIDIA 자체 개발 선도 모델을 제공합니다:
모델 영역 Nemotron 대형 언어 모델 Cosmos 세계 기초 모델(세계 기초 모델) GROOT 일반적 인간형 로봇 모델 Alpamayo 자율 주행 BioNeMo 디지털 생물학 Phys-AIAI 물리
우리는 각 분야에서 기술 선두에 있으며, 지속적인 반복을 약속합니다 — Nemotron 3 이후 Nemotron 4, Cosmos 1 이후 Cosmos 2, Groq도 2세대까지 발전할 것입니다.
Nemotron 3은 OpenClaw에서 세계 3대 최고 모델 중 하나로 꼽혀 있어 최첨단 수준에 있습니다. Nemotron 3 Ultra는 역사상 가장 강력한 기초 모델이 되어 각국이 주권 AI를 구축하는 데 지원이 될 것입니다.
오늘, 우리는 Nemotron 연맹을 설립하고, 수십억 달러를 투자하여 AI 기초 모델 개발을 촉진할 것을 발표합니다. 연맹 구성원으로는: BlackForest Labs, Cursor, LangChain, Mistral, Perplexity, Reflection, Sarvam (인도), Thinking Machines (Mira Murati의 실험실) 등이 포함됩니다.
하나 둘씩 기업 소프트웨어 회사가 NeMo Claw 참조 설계 및 NVIDIA 에이전트 AI 도구 모음을 자사 제품에 통합하고 있습니다.
물리 AI 및 로봇
디지털 인텔리전스는 디지털 세계에서 활동합니다. 코드를 작성하고 데이터를 분석합니다. 한편, 물리적 AI는 존재론적 인텔리전스인 즉, 로봇입니다.
이번 GTC에서는 110대의 로봇이 선보였으며, 거의 모든 세계적인 로봇 개발 기업이 포함되었습니다. NVIDIA는 학습 컴퓨터, 시뮬레이션 컴퓨터, 탑재용 컴퓨터 각각 세 대의 컴퓨터와 완벽한 소프트웨어 스택 및 AI 모델을 제공했습니다.
자율 주행 분야에서는 ChatGPT 시대가 이미 도래했습니다. 오늘, 우리는 비아디, 현대, 닛산, 기리 등 네 개의 새로운 협력사가 NVIDIA RoboTaxi Ready 플랫폼에 합류했으며, 연간 생산량이 1800만 대에 이릅니다. 이전의 메르세데스-벤츠, 토요타, GM을 합치면, 라인업이 더욱 강화되었습니다. 우리는 또한 Uber와의 중요한 협업을 발표했으며, 여러 도시에 RoboTaxi Ready 차량을 배치하고 접속할 것입니다.
산업용 로봇 분야에서는 ABB, 유니버설 로보틱스, 쿠카 등 다수의 로봇 기업과 협력하여 물리적 AI 모델을 시뮬레이션 시스템과 결합하여 글로벌 제조 라인에 로봇을 도입하는 데 기여할 것입니다.
통신 분야에서는 카터피러 및 T-모바일도 참여했습니다. 미래에는 무선 기지국이 단순한 통신 노드가 아니라 NVIDIA Aerial AI RAN이 되어 실시간 트래픽 인지, 빔 형성 조정을 통해 에너지 효율을 높이는 지능형 엣지 컴퓨팅 플랫폼이 될 것입니다.
특별한 세션: Olaf 로봇 등장
(Disney Olaf 로봇 데모 비디오 재생)
황인훈: 눈사람 등장! Newton은 정상 가동 중! Omniverse도 정상 가동 중! Olaf, 안녕하세요?
Olaf: 당신을 만나 정말 행복해요.
황인훈: 네, 그런데 당신에게 Jetson 컴퓨터를 제공해주었거든!
Olaf: 그게 무엇일까요?
황인훈: 당신 몸 속에 있어요.
Olaf: 정말 신기해요.
황인훈: 당신은 Omniverse에서 걷기를 배웠어요.
Olaf: 저는 걷는 걸 좋아해요. 순순한 사슴을 타고 아름다운 하늘을 올려다보는 것보다 훨씬 더 좋아요.
황인훈: 이것이 바로 물리 시뮬레이션의 힘입니다 — NVIDIA Warp 기반의 Newton 솔버로 구동되며, 이는 Disney와 DeepMind와 함께 개발한 것으로, 당신이 실제 세계에 적응할 수 있도록 합니다.
올라프: 나도 정말 그렇게 생각했어.
황인훈: 여기서 네가 똑똑한 거지. 나는 눈사람이지, 눈덩이가 아니야.
황인훈: 상상할 수 있니? 미래의 디즈니랜드 — 공원에 자유롭게 돌아다니는 이 모든 로봇 캐릭터들. 하지만 솔직히 말해서, 네가 좀 더 크다고 생각했어. 나는 이렇게 작은 눈사람을 본 적이 없어.
올라프: (중립적으로)
황인훈: 오늘의 연설을 마무리해 주겠니?
올라프: 좋아요!
주요 연설 요약
황인훈: 오늘, 우리는 다음 핵심 주제를 함께 고찰했습니다:
1. 추론의 전환점: 추론은 이제 AI의 핵심 작업 부하가 되었으며, 토큰은 새로운 상품이 되었으며, 추론 성능이 수익을 직접 결정합니다
2. AI 공장 시대: 데이터 센터는 파일 저장 시설에서 토큰 생산 공장으로 진화했으며, 미래에 모든 기업은 자사의 경쟁력을 "AI 공장 효율"로 측정할 것입니다.
3. OpenClaw 에이전트 혁명: OpenClaw는 에이전트 컴퓨팅 시대를 열었으며, 기업 IT는 도구 시대에서 에이전트 시대로 나아가고 있으며, 모든 기업은 OpenClaw 전략을 수립해야 합니다
4. 물리 AI 및 로봇: 구체적인 지능이 대규모로 실현되고 있으며, 자율 주행차, 산업 로봇, 인간형 로봇이 함께 물리 AI의 다음 중요한 기회를 형성하고 있습니다.
감사합니다, GTC 즐거웠어요!
BlockBeats 공식 커뮤니티에 참여하세요:
Telegram 구독 그룹:https://t.me/theblockbeats
Telegram 토론 그룹:https://t.me/BlockBeats_App
Twitter 공식 계정:https://twitter.com/BlockBeatsAsia

 관련 기사