AI 시대, 토큰 공급 및 수요 전쟁의 궁극적인 전개
동영상 제목: AI 토큰의 공급과 수요 | Dylan Patel 인터뷰
동영상 작성자: Invest Like The Best
번역: Peggy, BlockBeats
편집자 주: AI 모델 능력이 계속해서 발전하고, 기업들이 Claude Code, Cursor 등의 도구를 대규모로 도입하는 가운데, 산업 토론이 "모델의 강도가 얼마나 강한가"에서 "모델이 어떻게 생산에 투입되는가"로 이동하고 있습니다. 그러나 AI 프로그래밍, 자동화 분석 및 데이터 모델링이 새로운 합의로 자리 잡을 때, 실행 비용이 급속히 하락함에 따라, 더 근본적인 문제가 나타나고 있습니다: 실행 비용이 빠르게 저해되면, 정말 부족한 것은 인력, 자본, 아니면 선도적 모델과 토큰 사용 권한일까요?
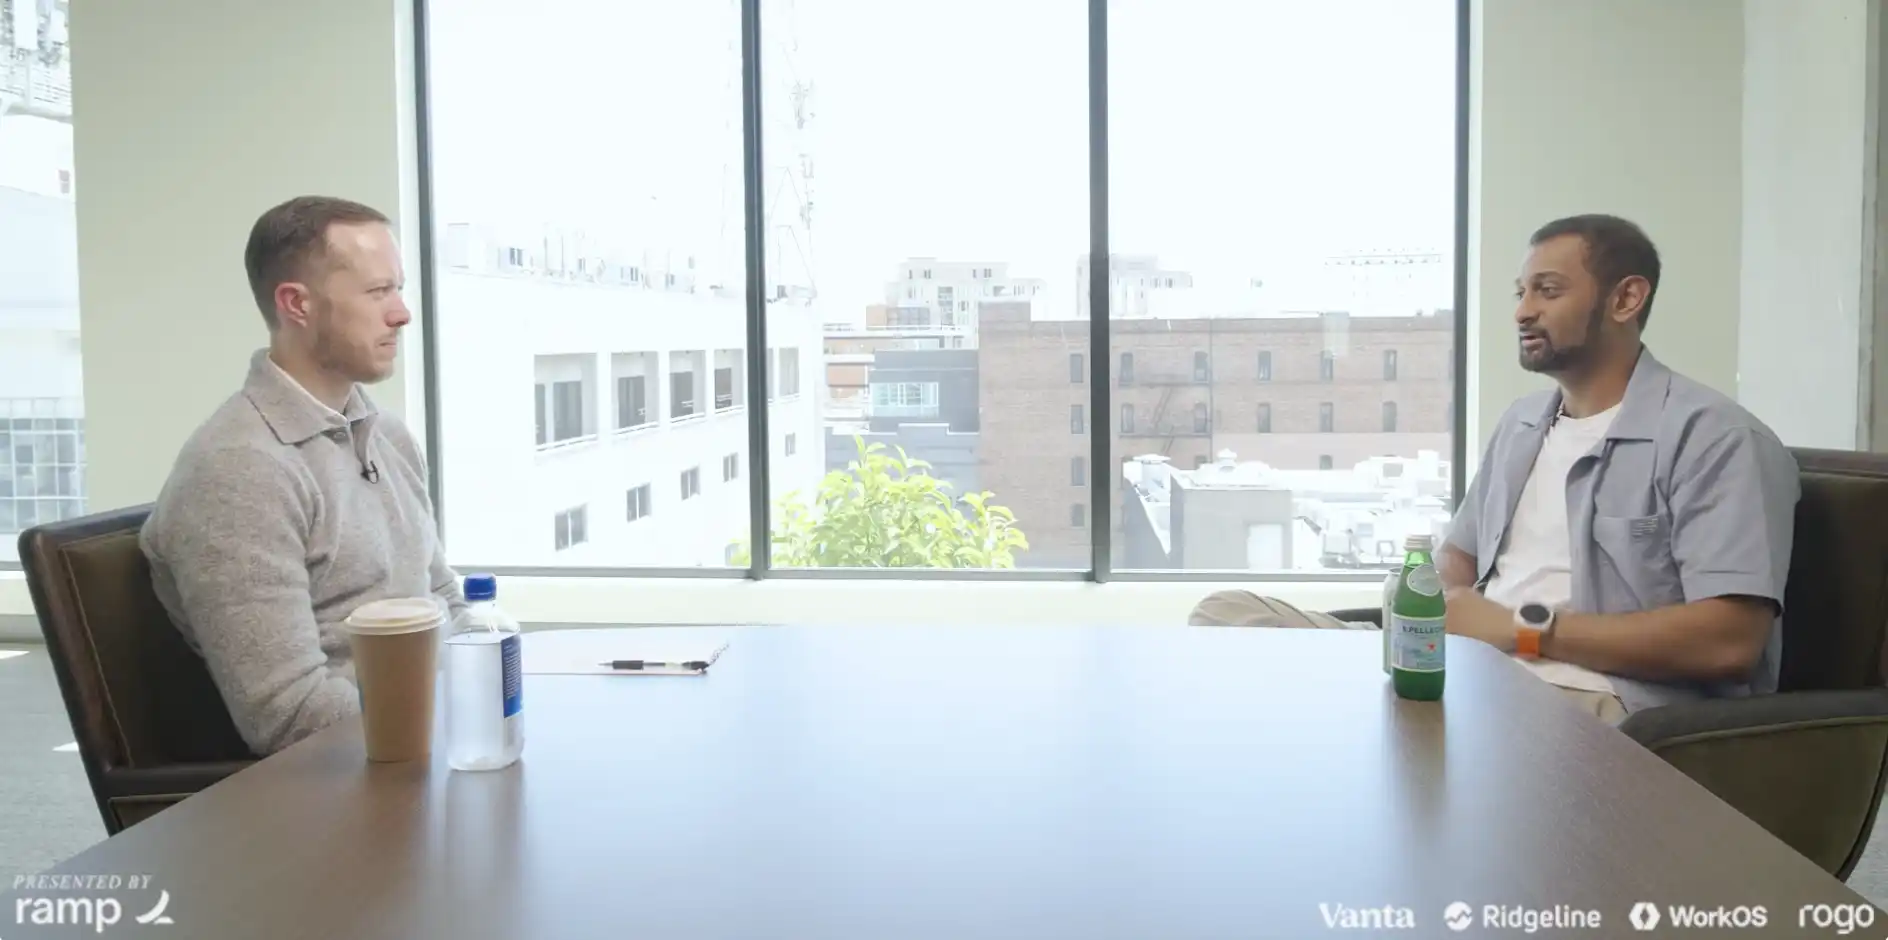
왼쪽은 주최자 Patrick O'Shaughnessy이고, 오른쪽은 Dylan Patel입니다.
이 문서는 Patrick O'Shaughnessy와 SemiAnalysis 창립자인 Dylan Patel의 대화를 정리한 것입니다. Dylan은 오랫동안 AI 인프라, 반도체 공급망 및 모델 경제에 관심을 기울여왔으며, 이 대화에서 그는 자사 회사인 Claude Code의 지출 급증을 출발점으로 삼아, AI가 기업 조직, 정보 서비스, 토큰 수요, 연산력 공급망 및 사회적 감정을 어떻게 변화시키는지에 대해 논의했습니다.
이 대화에서 가장 주목할 만한 점은 어떤 모델이 다시 한 번 벤치마크를 갱신했다는 것이 아니라, AI 경제를 이해하는 한 가지 방식을 제시한다는 점입니다. AI를 단순히 소프트웨어 도구의 업그레이드가 아닌, 실행 능력, 조직 효율성 및 산업 수익을 재분배하고자 하는 생산 시스템으로 바라보는 것입니다.
이 대화는 대략 다섯 가지 각도에서 이해할 수 있습니다.
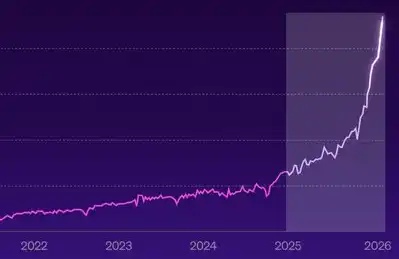
첫째, 실행 비용이 하락했습니다. 과거에는 아이디어가 부족한 게 아니었고, 정말 어려웠던 것은 아이디어를 제품, 시스템 및 제공 가능한 서비스로 변환하는 것이었습니다. 지금은 Claude Code를 통해 비기술자도 코드를 작성하고, 애플리케이션을 구축하고, 데이터 분석을 수행할 수 있습니다. 오래 전에는 팀이 장기간 유지해야 했던 작업이, 소수의 사람들이 모델을 활용하여 완성하게 되었습니다. SemiAnalysis의 Claude Code 연간 지출은 이미 700만 달러에 달해, 그들의 임금 지출보다 4분의 1을 넘어섰는데, 이는 AI가 더 이상 생산성 도구가 아니라 기업의 새로운 생산 자본으로 변모하고 있다는 것을 보여줍니다.
둘째, 정보 서비스 산업이 가장 먼저 재구성되었습니다. Dylan이 속한 비즈니스는 본질적으로 분석, 상담 및 데이터 집합을 판매하는 것이며, 이는 AI에 의해 상품화되기 가장 쉬운 영역입니다. 칩 역설 분석, 에너지 그리드 모델링, 거시경제 지표 구축은 과거에는 팀이 장기간 투입되어야 했지만, 이제는 소수의 사람들이 몇 주 만에 제품을 개발할 수 있습니다. 이는 AI가 정보 서비스 회사에 대한 압력이 "사람을 대체할 것인가"가 아니라 "누가 동종업계 제품을 더 빠르게 재구성할 수 있는가"임을 의미합니다. AI를 채택하지 않는 회사는 더 빠른 회사에 의해 상품화될 것이며, AI를 채택한 회사도 표준을 지속적으로 향상시켜야 하며, 다음 세대의 더 효율적인 경쟁사로부터 반대로 대체되지 않도록해야 합니다.
더 깊게 들어가면, 토큰이 새로운 생산 재료로 변해 가고 있습니다. 과거 기업은 소프트웨어 구독을 구입했는데, 핵심 문제는 도구의 사용 편의성입니다. 그러나 현재, 선두 모델에 대한 액세스 권한, rate limit, 기업 계약 및 토큰 예산은 직접 생산 능력을 결정하기 시작했습니다. 더 강력한 모델은 항상 높은 비용을 의미하는 것은 아니며, 더 똑똑한 토큰이 더 적은 단계로 더 높은 가치의 작업을 수행할 수도 있습니다. 진정한 경쟁은 "누가 AI를 사용하는가"에서 "누가 가장 강력한 모델을 확보하고, 가장 비싼 토큰을 가장 높은 가치의 시나리오에 사용할 수 있는가"로 전환되고 있습니다.
이러한 수요는 전체 공급망으로 계속 전달될 것입니다. 토큰 사용량 급증은 결국 GPU, CPU, 메모리, FPGA, PCB, 구리 호일, 반도체 장비 및 웨이퍼 공장의 자본 지출에 지속적인 압력을 가할 것입니다. 글에서 언급된 "소의 채찍 효과"는 바로 이러한 논리입니다: 하류에선 모델 호출 수요 증가만으로 보이지만, 상류로 전이될 때 수배 배런스, 생산 확대 및 가격 상승으로 복제될 수 있습니다. 따라서 AI 산업의 수익 분배는 모델 회사와 NVIDIA에만 머무르지 않고, 반도체 및 데이터 센터 공급망을 따라 계속해서 외부로 넘어갈 것입니다.
마지막으로, AI의 사회적 반동이 조기에 나타날 수 있습니다. AI가 실제로 워크플로에 진입하면서, 대중의 직업 대체, 에너지 소비, 데이터 센터 확장 및 권력 집중에 대한 우려도 동시에 증가할 것입니다. Dylan은 심지어 3개월 내에 대규모 AI에 대한 시위가 발생할 수 있다고 예상하고 있습니다. 모델 회사들에게는 "AI가 세상을 바꿀 것"을 계속 강조하는 것이 우려를 완화시키지 못할 수 있으며, 오히려 일반인들의 무력감 상상을 강화할 수도 있습니다. AI 산업이 증명해야 할 다음 것은 기술 능력뿐만 아니라, 현재 어떻게 구체적이고 인식 가능한 공공가치를 창출하는지에 대한 것입니다.
지금, AI의 핵심 문제는 "모델이 무엇을 할 수 있는가"에서 "누가 모델을 획득하고, 모델을 어떻게 사용하며, 모델이 만들어내는 가치를 누가 포획할 수 있는가"로 변화하고 있습니다. 이 의미에서, 이 글에서 논의된 주체는 더 이상 Claude Code, Anthropic 또는 특정 AI 회사만이 아니라, 생산성, 자본 지출, 조직 효율성 및 사회적 수용도 주변에 전개된 구조적 재배열에 대한 것입니다.
아래는 원문 내용입니다 (이해를 돕기 위해 일부 내용을 재구성했습니다):
요약
· AI의 핵심 변수는 이제 "할 수 있는지"에서 "할 가치가 있는지"로 변화하고 있습니다. 실행 비용이 급격히 하락한 후, 실제로 부족한 것은 모델이 확장할 수 있는 고품질 아이디어입니다.
· Claude Code의 지출이 급여 비용의 25%를 차지하는 것은 단순히 시작에 불과하며, AI는 이제 소프트웨어 도구에서 기업의 새로운 생산 자본으로 변화하고 있습니다.
· 선두 모델의 경쟁은 더 이상 능력의 경쟁이 아니라 토큰 확보 권리의 경쟁입니다. 가장 강력한 모델을 가장 일찍, 가장 안정적으로 확보할 수 있는 사람이 새로운 비지니스 장벽을 형성할 수 있습니다.
· 정보 서비스 산업은 AI에 의해 가장 먼저 개조될 것입니다. 데이터, 분석 및 연구의 생산 비용이 급속히 하락하고 있기 때문에, 기존 기업은 더 빠른 기업에 의해 상품화될 것입니다.
· 토큰 수요는 이전 모델의 가격 하락으로 둔화되지 않을 것입니다. 각 모델의 강화는 매번 새로운 고가치 사용 사례를 선보이며 사용자를 보다 고가의 선두 모델로 이끌 것입니다.
· AI가 가져온 가장 큰 변화는 사람들이 덜 일하게 하는 것이 아니라 소수의 사람이 동일한 시간 내에 수십 배의 생산량을 달성하는 것입니다. 토큰 가치를 창출하고 확보하지 못하는 사람은 "영원한 하위 계층"에 갇히게 될 것입니다.
· 컴퓨팅 파워의 부족은 반도체 공급망 전체로 확산되고 있으며, GPU, CPU, 메모리부터 PCB, 구리 호일 및 장비 제조업체까지, AI 수요가 전 산업 체인의 가격을 밀어올리고 있습니다.
· AI의 경제적 가치는 전통적인 GDP로 측정하기 어려우며, 진정한 문제는 모델 회사가 벌어들인 돈뿐만이 아니라, 토큰 생성에 따른 의사 결정, 효율성 및 연쇄적 영향이 얼마나 많은 "유령 GDP"를 창출했는지입니다.
인터뷰 원문:
Claude Code가 새로운 노동력이 되었습니다
Patrick O'Shaughnessy (주최자):
이전에 AI 사업에서 토큰 사용량이 크게 변했다는 멋진 이야기를 들었습니다. 한 번 더 말해주시겠어요? 그것은 이 세계에서 무슨 일이 일어나고 있는지에 대한 어떤 이해를 제공했나요?
Dylan Patel (SemiAnalysis 창립자):
작년, 우리는 이미 AI의 중심 사용자라고 생각했습니다. 모두가 ChatGPT를 사용하고, 모두가 Claude를 사용했으며, 저도 팀에 원하는 구독을 제공했습니다. 그 당시 회사의 이에 대한 지출은 대략 몇 만 달러 수준이었습니다.
그러나 올해에는 지출이 급증하기 시작했습니다. 실제 시작점은 아마 작년 12월 말쯤 Opus가 등장한 시점이었을 것입니다. 여기에는 당연히 저희 회사의 CEO인 Douglas Lawler도 포함됩니다. 그는 비기술 직군을 AI로 코드를 작성하도록 주도하고 계신 분입니다. 그는 회사 전체를 조금씩 AI에 끌어들였다고 할 수 있습니다. 물론 엔지니어들은 이미 사용하고 있었지만, 올해 1월부터 우리의 지출은 명백히 증가 추세를 보이기 시작했고, 그 후 급격하게 증가했습니다.
나중에 우리는 Anthropic과 기업 간 계약을 맺었습니다. 지난번 당신과 이야기했던 시점에는 연간 지출이 대략 500만 달러였는데, 이제 700만 달러까지 증가했습니다.
Patrick O'Shaughnessy:
그것도 지난 주의 숫자였죠.
Dylan Patel:
맞아요. 그 중 상당 부분은 사용량 그 자체입니다. 실제로 흥미로운 점은 이전에 코드를 한 번도 작성한 적이 없던 사람들도 이제 Claude Code를 사용하고 있다는 점이며, 그 중 일부 사람들은 하루에 몇 천 달러를 쓸 정도입니다. 회사 전체적으로 보면, 우리는 현재 Claude Code에 연간 700만 달러를 지출하고 있으며, 우리의 급여 지출은 대략 2500만 달러입니다. 즉, Claude Code에 대한 지출이 급여 지출의 25%를 넘었습니다.
이 추세가 계속된다면, 연말까지 이것이 급여 총합을 100% 초과할 수도 있습니다. 약간 무서운 상황입니다. 다행히 지금은 '인간'과 'AI' 중 하나를 선택할 필요가 없습니다. 왜냐하면 회사 성장이 빠르기 때문입니다. 더 정확히는: 인력을 빠르게 고용할 필요가 없지만 AI에 더 많은 자금을 투자할 수 있으며, 이는 실제로 효과적이며 회사 성장을 더욱 가속화시킬 수 있습니다.
하지만 제 생각에 다른 회사들도 이 문제에 마주하기 시작할 것으로 생각합니다: Claude Code를 사용하여 한 사람이 5명, 10명 또는 심지어 15명의 업무를 완료할 수 있다면 다음 단계는 무엇일까요? 첫째, 실제로 인원을 축소해야 할 수도 있습니다. 둘째, 현재 이러한 사용 사례는 매우 다양합니다.
예를 들어, 우리는 오레곤에 반도체 역공학 실험실을 운영 중이며 이미 1년 반 정도가 지났습니다. 거기에는 많은 고급 장비들이 있습니다. 이 실험실의 핵심 목적은 칩을 역분석하여 칩 아키텍처를 추출하고 제조에 사용된 재료를 분석하는 것입니다. 이것들은 우리가 판매하는 데이터 중 하나입니다.
하지만 이러한 데이터를 분석하는 것은 과거에는 매우 느린 프로세스였습니다. 현재, 저희 팀에서는 몇 천 달러의 Claude 토큰만 사용하여 응용 프로그램을 만든 사람이 있습니다. 이 응용 프로그램은 GPU 가속을 사용하며 CoreWeave에 배포된 서버에서 실행됩니다. 우리는 칩 사진 하나를 보내면, 그것은 이미지에서 각 재료의 위치를 자동으로 표시할 수 있습니다: 여기는 구리, 여기는 탄탈럼, 여기는 게르마늄, 여기는 코발트입니다. 그런 다음 전체 칩 스택 구조를 빠르게 유한 요소 분석할 수 있으며 시각화되며 완전한 그래픽 사용자 인터페이스 및 대시 보드도 제공됩니다.
이 사람은 이전에 인텔에서 일한 경험이 있었는데, 그는 과거에는 완전한 팀이 수행하고 유지해야 했던 작업이 지금은 회사 전체적으로 보면 놀라운 일이라고 말했습니다.
또 다른 흥미로운 예로 말컴이 있습니다. 그는 이전에 대형 은행의 경제학자였습니다. 그 은행의 경제학부는 약 100~200명 정도였을 것입니다. 그가 현재 하는 일은 정말 놀랍습니다.
그는 다양한 데이터를 가져와서 FRED 데이터, 고용 보고서, 다른 API에서 가져온 데이터 세트를 포함했습니다. 우리는 몇몇 데이터 공급업체와 계약을 맺고 API 액세스 권한을 획득했습니다. 그런 다음 그는 모든 데이터를 끌어들여 회귀 분석을 수행했는데, 이를 통해 다양한 경제 변화가 경제의 인플레이션 또는 디플레이션에 미치는 영향을 분석했습니다.
미국 노동 통계국에는 약 2000개의 작업 분류가 있습니다. 말컴은 어떤 작업이 현재 AI로 수행될 수 있는지, 어떤 것이 그렇지 않은지를 평가하기 위해 AI를 활용했고, 그러한 작업들에 대해 일련의 평가 기준을 적용했습니다. 결과적으로 약 3%의 작업이 현재 AI로 수행 가능하다는 것을 확인했습니다.
그래서 그는 AI로 수행 가능한 작업과 해당 작업이 AI로 수행될 때 어떤 디플레이션 효과를 가져올지를 측정하는 지표를 만들었습니다. 생산량은 증가할 수 있지만, 비용이 너무 많이 감소하면 이론적으로 GDP가 축소될 수 있습니다. 그는 이를 '유령 GDP'라고 부르기로 했습니다.
이 개념을 기반으로 그는 전체 분석을 수행했고, 약 2000개의 평가를 포함한 새로운 언어 모델 벤치마크를 구축했습니다.
패트릭 오쇼니시:
이 모든 것을 그가 혼자 한 건가요?
딜런 파텔:
네, 그 모든 것을 그가 혼자 했습니다. 그는 나에게 말했습니다: "형제야, 예전에는 200명의 경제학자들 팀이 1년이 걸려야 할 것을 해야 했던 일이야." 그는 지금 완전히 클라우드에 몰두하며, 모든 것이 변했다고 말합니다.
패트릭 오쇼니시:
기업 경영자로서 이를 어떻게 이해하십니까? 이 비용이 거의 없었던 것에서 거의 급여 지출과 근접한 25%로 증가했으며 계속해서 상승하고 있습니다. 언제 지출을 제동해야 할 지 생각하게 될지요? 지출을 억제해야 할 지도 모릅니다. 아마 우리는 항상 가장 최신의 모델에 의존할 필요가 없고, Opus 4.7 같은 제품을 사용하는 대신 좀 더 저렴한 모델로 전환이 가능할지도 모르겠습니다.
Dylan Patel:
근본적으로, 나는 정보 비즈니스를 하는 것이다. 우리가 파는 것은 분석이고, 컨설팅을 하며, 데이터 세트를 작성하기도 합니다. 나는 이러한 것들이 상당히 빠른 속도로 완전히 상품화될 이유가 없다고 생각합니다.
나는 계속 개선하지 않는다면, 나는 처음 판매한 첫 번째 데이터 제품이 지금은 더 많은 사람들이 비슷한 작업을 시작했다는 사실을 볼 것입니다. 우리가 아직도 팔 수 있는 이유는 계속해서 제품을 더 나은 것으로 만들고 더 세밀하게 만들고 있기 때문입니다. 그러나 우리가 2023년에 하는 방식은 실제로 지금 다른 사람들이 하는 방식과 큰 차이가 없었습니다. 표준을 더 높이지 않으면, 나는 상품화될 것입니다. 행동이 충분히 빠르지 않으면, 우리는 우위를 상실할 것입니다.
따라서 문제는: 네, AI 가 많은 것을 상품화할 것이며, 마치 소프트웨어가 상품화되고 있는 것처럼입니다. 그러나 충분히 빨리 행동하고 고객 관계를 잡고 뛰어난 서비스를 제공하며 서비스를 지속적으로 개선하는 사람들은 위축되지 않을 것이며, 오히려 더욱 빠르게 성장할 것입니다. 무능하고 아무것도 하지 않는 사람들이 질 것입니다.
그러므로 이는 사실 상생 문제와 조금 비슷합니다: 내가 AI 를 채택하지 않으면, 다른 사람이 채택하고 그들이 나를 이길 것입니다.
또 다른 간단한 예시는 에너지 분야입니다. 지난 1년 동안 정도로 몇 명의 에너지 분석가가 있었는데, 에너지 모델을 구축하려고 노력했습니다. 이 모델은 매우 복잡했고, 에너지 데이터 서비스 시장의 규모는 대략 9 억 달러이므로, 나는 진입하고 싶어했습니다. 그러나 우리 팀 중 한 명이 1년 여의 시간을 들여서해도, 우리는 실제적으로 에너지 데이터 서비스 사업에 진입하지 못했습니다.
그런 다음, "클로드 코드 마비증" 이 발생했습니다. 저희는 데이터 센터 에너지 및 산업 비즈니스 담당자인 제레미라는 사람이 있었습니다. 그는 클로드 코드를 사용하기 시작한 후로 상황이 급변했습니다. 3주 동안, 그는 많은 돈을 쓰기 시작했고, 일일 약 6000 달러를 쓸 수 있었으며, 정말로 확연한 액수입니다. 그러나, 그는 미국의 모든 발전소와 특정 전압 등급 이상의 모든 전력선로를 캡처하고 다양한 공개 데이터 원본에서 전체 미국 전력망 지도를 구축했으며, 동시에 여러 수요 측면 데이터를 통합했습니다.
우리는 그것을 전체 미국의 각각의 소규모 지역의 전력 부족과 과잉 상태를 볼 수 있고 분석할 수 있는 대시 보드로 만들었으며, 여러 세부 정보도 볼 수 있었습니다. 이것은 몇 주 만에 구축되었습니다.
그 후에 우리는 이미 우리의 데이터 센터 데이터 세트를 구매한 일부 고객들에게 이를 보여주었는데, 에너지 거래자들도 포함되어 있었습니다. 그들은 보고 나서 말했습니다: "와, 이게 얼마나 오래 걸렸어요? 이거 정말 좋네요. 어떤 회사보다 더 좋아." 그런 다음 우리는 더 알아보니, 그 "어떤 회사"는 100 명의 사람들이 있고 이미 10년 동안 이 문제를 다루고 있었습니다.
물론, 우리의 제품은 아직도 그들만큼 완벽하거나 안정적이지는 않지만, 어느 측면에서는 이미 더 나아진 부분이 있습니다. 그래서 저는 현재 이러한 에너지 데이터 서비스 회사들을 상용화하고 있습니다. 그러나 그 반대로, 만약 저가 더 빨리 나아가지 않는다면, 누가 나를 상용화할 것입니까?
그러므로 사업 주인의 관점에서 문제는 "나는 많은 돈을 썼는가"가 아닙니다. 네, 제가 실제로 많은 돈을 썼습니다. 그러나 문제는 이 돈이 나에게 무엇을 가져다 주었는가입니까? 더 많은 수익을 가져왔습니까? 그 질문에 대답이 '예'이면, 그 돈은 가치가 있는 것입니다.
Patrick O'Shaughnessy:
최종적으로, 자본을 통제하고 투자 자본을 책임지는 그들, 즉 자주 당신들이 한 일로 인해 당신들을 고용하는 사람들은 "우리에게도 분석가가 있고, 그들 또한 매우 똑똑하니까, 그냥 스스로 해도 괜찮지 않겠느냐?"라고 말할까 걱정하지는 않으십니까? 만약 그것이 그렇게 쉬워진다면, 그러면 어느 시점에 그것이 전부 투자 기관 내부로 돌아오게 될까요? 결국 그들은 이러한 데이터와 통찰력에서 가장 큰 지렛대를 얻을 가능성이 가장 높습니다.
Dylan Patel:
먼저, 모든 정보 서비스 비즈니스는 본질적으로 다음과 같습니다: 나는 한 조각 정보에서 얻는 가치가 명백히 고객이 그 정보에서 얻는 가치보다 큽니다.
내가 당신에게 1달러에 정보를 판매한다면, 당신이 이 1달러 지불하려는 이유는 그 정보가 결정을 내리는 데 도움이 될 것을 알기 때문입니다. 이 결정으로 당신은 1달러 이상 벌 수 있게 됩니다. 즉, 당신은 투자 기회를 얻었습니다. 당신이 나로부터 벌어들인 돈은, 내가 그 정보를 판매함으로써 벌어들인 돈보다 더 많습니다.
투자 기금 자체도 물론 자체의 정보 서비스 능력을 갖추고 있습니다. 특히 Jane Street, Citadel과 같은 기관은 데이터 측면에서 매우 세밀하고 심층적입니다. 그러나 이러한 기관들은 여전히 우리의 데이터를 구매하며, 계속해서 구매하고 있으며, 우리와의 협력이 계속 확대되고 있습니다.
나는 여기에 어떤 '요소'가 있다고 생각합니다. 우리는 더 빠르고 유연하게 행동하며, 팀원 수가 적으며, 매우 구체적인 영역에 집중하고 있습니다: AI 인프라 및 이로 인한 거대한 변화, AI, 토큰 경제 및 관련 전반적인 것들을 포함합니다. 우리는 방향을 더 빨리 파악하고 더 빨리 구축할 수 있습니다.
따라서, 투자 전문가들은 물론 우리가 하는 일을 스스로 시도해 볼 것입니다. 그러나 더 자주, 그들은 우리의 데이터를 직접 구매하고, 그 기반 위에 계속해서 구축합니다. 그들에게 있어서 우리의 데이터를 사서 진출하는 것이 자체적으로부터 시작하는 것보다 보통 더 저렴합니다. 물론, 결국 누군가는 스스로 시도할 것입니다.
토큰이 새로운 원재료로 변신
Patrick O'Shaughnessy:
내가 당신과 이야기할 때마다 항상 돌아오는 주제는 토큰의 공급과 수요입니다. 현재 나를 가장 흥미롭게 하는 것은 바로 이것입니다. 귀하의 경험 자체로 인해 수요 측면에 대한 새로운 이해가 생겼나요? 자신이 이를 매우 직접적으로 경험한 후에 토큰의 수요에 대한 판단이 변했습니까?
Dylan Patel:
우리가 거시적인 시각에서 한 발 물러나서 보면, Anthrop의 ARR은 이미 90억 달러에서 350억, 400억 달러 정도로 증가했을 수 있습니다. 이 에피소드가 방영될 때까지, 이미 400억에서 450억 달러에 이를 수도 있습니다.
그러나 그들의 해시파워 증가율은 같은 폭이 아닙니다. 계산해 보면, 그들의 연구 및 개발 해시파워가 감소하지 않았다고 가정하면 —— 명백히 그들이 줄이지 않았다고 나타나며, 새로운 모델인 Metis, Opus 4, Opus 4.7를 출시하고 있습니다 —— 그것은 하나의 사실을 보여줍니다. 그들의 추가 해시파워는 모두 추론에 투입되더라도 순이익률 하한선은 72% 정도입니다.
실제로 일부 추가 해시파워는 아마도 연구 및 개발로 투입되었으므로, 실제 순이익률은 72%보다 높을 수 있습니다. 알아두어야 할 점은, 올해 초에 그들의 자금 조달 문서 일부 정보가 유출되었을 때, 그 당시의 순이익률은 약 30% 초반 정도였다는 것입니다.
어떤 비즈니스가 이렇게 단기간에 순이익률을 높일 수 있는 지? 원칙적으로, 수요가 너무 높기 때문입니다. 그들은 할당량을 제한하고 속도 제한 및 여러 가지 제한을 가할 수 있습니다. 실제로 중요한 것은 Anthrop의 고객 매니저가 있는지, 기업 계약이 있는지, 필요한 속도 제한을 얻을 수 있는지입니다. 그렇지 않으면 토큰은 최종적으로 극도로 부족해질 것입니다.
누가 지불할 수 있는지에 따라 받을 수 있습니다. Anthrop도 똑같은 문제를 직면하고 있습니다 —— 물론 이것은 문제가 아니고, 이는 자본주의의 운영 방식일 뿐입니다. 예, 고객은 연 400억 달러의 토큰 비용을 지불할 수 있지만, 이러한 토큰이 고객에게서 창출하는 가치는 400억 달러를 훨씬 초과합니다.
다른 기업마다 각 토큰이 창출하는 가치는 다릅니다. 그러나 모델이 더 똑똑해지면, 정말 중요한 것은: 누가 이러한 가장 스마트한 토큰을 획득하고, 그것을 가장 가치 있는 곳에 사용하는지입니다.
개인으로서 내릴 결정은: 이러한 토큰을 어떻게 활용하여 비증가, 가치 창출을 할 것인지입니다. 많은 사람들이 토큰을 원하고, 토큰을 소비할 것입니다. 그러나 샌프란시스코에서 Claude를 사용하여 소프트웨어 제품을 생성하는 일반 SaaS 스타트업은 실제로 큰 가치를 창출하고 있지 않을 수 있습니다. 그래서 결국, 그들은 토큰 가격에서 밀려날 것입니다.
Patrick O'Shaughnessy:
오늘 비행 중에도 이런 상황을 겪었습니다. Opus 4.7가 출시되자마자 나는 즉시 4.7을 사용하고 싶었고, 곧바로 사용하고 싶었다. 그 결과 제가 속도 제한을 당해서 전혀 사용할 수 없었습니다. 심지어 이미 4.6을 더는 사용할 수 없다는 생각을 할 수조차 없었는데요, 몇 주 동안 4.6에 대해 매우 만족했었는데, 이미 충분히 강력했기 때문입니다.
사람들이 가장 비심하고 최신의 모델을 사용하려는 것에 대해 놀랄 만한가요?
Dylan Patel:
전혀 놀랄 일이 없습니다. 지난 한 달 반 동안 가장 우스꽝스러웠던 기억 중 하나는 제가 친구 Leopold와 함께 거의 Anthropic의 공동 설립자 앞에서 무릎을 꿇고 Metis에 대한 액세스 권한을 요청했던 일입니다.
우리는 그것이 존재한다는 것을 알고 있었기 때문에 이렇게 말했습니다: "부탁합니다, 우리도 사용하게 해주세요." 그리고 그는 말했습니다: "너희 둘이 무슨 소리 하는지 모르겠어."
Patrick O'Shaughnessy:
그 가격표나 평가 카드가 나왔을 때, 어떤 반응이었나요?
Dylan Patel:
실은 베이지 지역에 와있을 때, 우리는 그것이 매우 강력할 것으로 예상했습니다. 벤치마크를 보면, 물론 벤치마크는 계속 변할 수 있지만 Mephisto/Metis가 아마도 지난 2년 동안 모델 능력 최대의 한 번의 도약이었을 겁니다.
나는 이것이 매우 중요하다고 생각합니다: 이는 Anthropic이 심지어 완전히 공개하고 싶어하지 않게 된 이유일 것입니다. 일부 고객에게 이미 가격을 공개했고, 네트워크 보안 관련 시나리오에 초점을 맞춘 선택적 공개도 진행했습니다. 그의 토큰 비용은 5배에서 10배가 될 수도 있지만, 그들은 여전히 완전히 공개하고 싶어하지 않습니다. 실제 세계에 미칠 영향을 우려하기 때문입니다.
그래서 우리에게 제공된 것은 훨씬 나쁘고 더 약한 버전인 Opus 4.7 입니다. 그들은 심지어 모델 카드에서 명확히 말했습니다: 실제로 우리는 네트워크 보안 능력을 의도적으로 낮춰 최적화했습니다. 당신이 그 부분을 읽었는지 여부는 모르겠습니다.
그러므로 내가 말하고 싶은 것은: 누구든지 자본이 충분하다면 Anthropic의 기업 구독을 사야하며, 토큰으로 지불해야 합니다. 그보다는 일반 구독을 사용하지 말아야 합니다. 왜냐하면 그렇게 하면 제한을 당하기가 더 어려워지기 때문입니다.
그러고 나면 당신은 고민해야 합니다: 이러한 토큰을 어떻게 가치 있는 작업에 사용하고 수익을 내느냐? 근본적으로, 아마 1년, 2년 지나면, 많은 비즈니스는 본질적으로 토큰 아비트리지를 하게 될 것입니다. 토큰은 매우 강력하지만, 중요한 것은 그것들을 어디로 향하게 할 것인가를 알아야 합니다.
앞으로 세네 해 뒤에, 모델 자체가 토큰을 어떻게 사용해야 하는지, 최대 가치를 어떻게 창출해야 하는지 알게 될 것입니다.
어떤 벤치마크를 살펴보면, 이전에 어떤 능력 수준에 도달하기 위해 필요했던 비용이 X였다면, 이제는 그의 백분의 일, 심지어 천분의 일만 필요할 수도 있습니다. 예를 들어, DeepSeek가 GPT-4 수준의 능력을 갖게 될 때, 비용은 GPT-4의 1/600 정도였습니다. 그 이후로도, GPT-4 수준의 모델 비용은 계속해서 하락해 왔습니다.
물론, 지금은 더는 누구도 실제로 GPT-4 수준의 모델에 관심이 없습니다. 모든 사람들이 원하는 것은 선도적인 모델입니다, 왜냐하면 선도적인 모델만이 실제로 가치 있는 것을 창출할 수 있기 때문입니다. 그러나, GPT-4 수준의 모델은 여전히 어떤 시나리오에 사용될 수 있습니다. 다만, 그러한 시나리오들은 보통 더 작은 규모입니다.
그래서 수요를 진정으로 촉진하는 것은, 이전 능력이 저렴해졌다는 것이 아니라 새로운 사용 사례들이 지속적으로 등장하는 것입니다. 당신은 현재 Opus 4.6 또는 Opus 4.7 이러한 수준의 모델을 사용하고 있습니다. 일 년 뒤, 만약 나도 오늘과 같은 품질의 모델 능력을 원한다면, 내 지출은 아마도 7만 달러에 불과할 것이며, 혹시 100배 싸질지도 모릅니다.
하지만 이것은 중요하지 않습니다. 왜냐하면 그때에는, 저는 분명히 더 강력한 모델을 사용하여, 더 가치 있는 일을 할 것입니다.
Anthropic의 Metis은 모델 자체는 비싸지만, 동일한 작업을 수행하는 데 필요한 토큰의 양은 훨씬 적습니다. 그래서 대부분의 작업에서 실제로 Opus 4.6보다 싸다고 할 수 있습니다.
Dylan Patel:
왜냐하면 훨씬 더 효율적이기 때문입니다. 각 토큰 자체가 더 "스마트"하고 비싸더라도, 수행해야 하는 작업을 위해 필요한 토큰의 양은 훨씬 적습니다.
Patrick O'Shaughnessy:
마지막으로 당신을 본 적이 Metis가 출시된 지 얼마 안된 것 같았거나, 모델 카드가 방금 나온 것 같았습니다. 그때 당신은, 그것이 당신을 약간 두렵게 만든다고 말했습니다. 이 말은 무엇을 의미합니까?
Dylan Patel:
Anthropic의 2025년 목표는, 사실 2024년부터 시작하여 2025년 말까지, 그들이 모델 안에 L4 수준의 소프트웨어 엔지니어가 있기를 원합니다. 전반적으로 그들은 Opus 4.6 수준까지 거의 이르렀습니다.
하지만 그들이 언급하지 않은 것은, 만약 당신이 Metis를 보고 벤치마크를 비교한다면, 그것이 더 L6 엔지니어 같다는 점입니다. L4는 상대적으로 초급 소프트웨어 엔지니어이며, L6는 이미 경험이 매우 풍부한 엔지니어입니다.
Anthropic이 말했던 것을 기억한다면,이 모델은 내부적으로 대략 2월부터 사용할 수 있었습니다. 즉, 그들은 L4 엔지니어에서 L6 엔지니어로 2개월 만에 승격했습니다. 다음은 무엇이 발생합니까?
모델 발전을 생각할 때, 실제로 그 진척이 가속 중임을 알 수 있습니다. Anthropic의 출시 속도가 가속화되고, OpenAI의 출시 속도도 가속화되고 있습니다. 왜냐하면 더 나은 모델을 만들기 위해서는 대개 몇 가지 것이 필요하기 때문입니다.
먼저, 강력한 컴퓨팅 성능이 필요합니다. 컴퓨팅 성능은 매우 비싸며, 자체적인 시간 척도가 있습니다. 우리는 이러한 것들을 추적할 것이며, 그것은 실제로 증가하고 있으나, 단기적으로는 기본적으로 확정되어 있습니다. 이미 계약한 컴퓨팅 성능은 대체로 확정되어 있습니다. 물론, 일정은 지연 및 조정이 있을 수 있으며 조금 더 확보하기 위한 노력을 기울일 수 있지만, 전반적으로는 상당히 안정되어 있습니다.
둘째, 매우 우수한 연구원들이 필요합니다. 회사들은 지금 이러한 사람들에게 수억 달러를 지불하려고 합니다.
마지막으로, 실행 능력이 필요합니다. 역사적으로 실행은 항상 매우 어려웠습니다. 제가 아이디어를 가지고 있다면, 그것을 실행해야 하며, 실행은 매우 어려운 일이었습니다. 그러나 지금, 아이디어는 곳곳에 있고, 실행은 매우 쉬워졌습니다. 그것은 비싸지만 매우 쉬워졌습니다.
그래서 문제는 다음과 같습니다: 한 사람이 어떤 아이디어를 실행할지 결정하는 방법은 무엇입니까? 결과적으로, 실행이 지나치게 쉬워졌기 때문에, 더 많은 아이디어를 실행하고 이 달리기 기계에서 더 빨리 뛰어갈 수 있게 되었습니다.
이것은 AI 모델 연구에서 발생할 수 있으며, 모델 출시 속도는 지난 6개월에서 2개월로 단축되었습니다. 다른 분야에서도 발생할 수 있습니다. 미국의 모든 화력 발전소, 모든 전력선로를 모델링하고, 회귀를 실행하고, 미시적인 지역의 공급 및 수요 관계를 분석하고 싶다고 상상해보세요 - 이제 제가 할 수 있습니다.
아이디어 자체는 값싼 것입니다. 핵심은 어떤 아이디어가 의미가 있는가입니까? 어떤 아이디어가 자본을 투자하고 토큰을 구매하고 실행해야 하는가? 왜냐하면 실행 능력은 이미 그 자리에 있기 때문입니다. 이것이 가장 중요한 변화입니다.
만약 실행 비용이 계속해서 하락한다면 - 그리고 그것은 실제로 하락하고 있습니다 - 우리는 실제로 Metis를 받아 본 적이 없습니다. Opus 4.7는 몇 시간 전에 발표되었지만, 우리 팀은 이미 매우 흥분해 있습니다.
다음으로, 이것이 세상에 무엇을 가져다 줄 것으로 생각하십니까? 나는 이것이 경제 운영 방식을 다시 정렬할 것이라고 생각합니다.
과거에는 실행이 매우 중요했으며, 실행이 어려웠기 때문에. 아이디어는 매우 저렴했습니다. 지금은 아이디어가 저렴할뿐만 아니라 매우 풍부하지만 실행도 매우 쉬워졌습니다. 따라서 진정한 가치가 있는 것은 매우 우수한 아이디어뿐이며 - 그것들은 증명할 수 있습니다. 실행이 이미 극도로 저렴하더라도 여전히 그것에 투자할 가치가 있다는 것을 말해 줄 수 있습니다.
Patrick O'Shaughnessy:
그러니까 당신은 정말 두렵다고 생각하시는 건가요? 아님, 그냥 이해하기 어려운 불확실성이 들어왔기 때문에 그런가요?
Dylan Patel:
불확실성은 분명히 존재합니다. 그러나 제가 실제로 두려움을 느낀다고 느끼는데, 이는 어떻게 사회가 자신을 재편할 것인가에 대한 것입니다.
당신이 이미 어떤 것을 실현할 수 있는 능력
이 그 자체로 더 이상 그렇게 중요하지 않은 세상에서 살고 있다면, 무엇이 중요한가요? 중요한 것은, 당신이 AI에게 올바른 아이디어를 선택하게 할 수 있는지, 그것을 실현하게 할 수 있는지; 이 아이디어를 팔 수 있는지, 또는 AI가 실현한 것을 팔 수 있는지; 그 방향으로 자금을 조달할 수 있는지입니다. 이것들이 중요해질 것입니다.
이는 또한 앞서 언급한 질문으로 이어집니다: 항상 최신 모델을 가지고 있어야 하는 것이 매우 중요합니다. 그러면 누가 최신 모델을 얻을 수 있을까요?
Anthropic은 하나의 프로젝트를 갖고 있는데, 제가 그것이 Earwig라고 불리지는 않지만, 의도적으로 그것을 Earwig라고 부르는 것을 좋아합니다. 이것은 Anthropic을 조롱하기 위한 것입니다. 그들은 Metis를 일부 기업에만 제공하여 네트워크 보안 시나리오에 사용합니다. 이러한 유형의 상황이 계속 발생할 것으로 생각됩니다: 모델 배포 범위가 점차 좁아지고 대중에게는 점점 더 이해하기 어려운 것이 될 것입니다.
참고: Earwig은 원래 "귀뚜라미"를 의미하며, 중국어에서도 종종 "귀걸이虫"이라고 불립니다. 여기에서는 약간 농담적인 별명처럼 보입니다. 한편으로는 earwig가 어떤 벌레인 것 같지만, 다른 한편으로는 "몰래 귀에 기어들기", "숨죽여 영향을 끼치기"와 같은 연상도 있습니다.
나는 OpenAI, Anthropic 및 기타 회사들이 모두 강력한 AI를 모든 사람들에게 제공하길 희망한다고 알고 있습니다. 그러나 AI는 매우 비용이 많이 듭니다. 수조 달러에 달하는 인프라를 누가 지불할 것입니까? 그것을 가진 사람들이 돈을 가지고 유용한 것을 구축할 수 있습니다.
또한, 누군가가 당신의 모델을 증류하길 원하지 않으니, 넓은 범위로 배포하지 않을 것입니다. 대신 그것을 점점 더 적은 고객들에게 제공할 것입니다. 그런 다음, 이러한 고객 사이에서도 토큰을 놓고 싸움을 시작할 것입니다.
Anthropic이 가격을 크게 인상하지 않는 한. 그들은 완전히 Opus의 가격을 두 배로 올릴 수 있으며, 저는 계속해서 지불할 것입니다. 대부분의 사용자도 그러한 경향이 있을 것이라고 말할 수 있습니다. 그러나 저는 심지어 그들의 거대한 생산 능력 문제를 해결하기에는 부족하다고 생각합니다.
그래서 문제는 여기에서 어디에서 이 순환하는 과정이 끝나는지일 것입니다? 토큰 사용량과 이러한 토큰이 제공하는 추가 가치가 점점 더 소수의 회사들에 집중될 때, 어떻게 될 것입니까?
저는 현재 Metis를 보유하고 있지 않습니다. 하지만 누가 가지고 있을까요? 대형 은행들이 있습니다. 현재 그들은 아마도 네트워크 보안 측면에서만 사용하고 있겠지만, 저는 세계를 상상할 수 있습니다: Anthropic의 기업 계약을 가지고 있기 때문에, 그리고 Anthropic의 사람들이 나를 어느 정도 좋아하기 때문에, 그들은 우리에게 조금 더 일찍 접근 권한을 줄 의향이 있을 수도 있고, 또는 rate limit을 조금 더 높게 설정해 줄 수도 있을 것입니다. 물론 이런 일이 일어났으면 좋겠습니다.
그러면 제 경쟁 상대들은 이러한 액세스 권한을 가지고 있지 않기 때문에, 제가 그들을 이기 수 있을 것입니다.
또 다른 시나리오일 수도 있습니다. Citadel의 Ken Griffin 같은 경우인데요, 그는 인맥도 매우 좋고, 매우 부유합니다. 그는 OpenAI나 Anthropic과 협정을 맺을 수도 있습니다. 예를 들어, "매년 100억 달러 가치의 토큰을 먼저 사겠습니다. 새로운 모델을 출시할 때마다, 나는 처음 100억 달러 가치의 토큰을 사서, 남은 토큰을 다른 사람들이 사용하게 하겠습니다."
그러면 어떻게 될까요? 그는 시장에서 모든 사람들을 압도할 수 있습니다.
이는 한 예시에 불과합니다. 이는 네트워크 보안 분야에서 발생할 수도 있고, Anthropic이 모델이 시스템 해킹을 더 쉽게 만들 수 있다고 걱정할 수도 있습니다. 또는 제와 같은 정보 서비스 업계에서 발생할 수도 있습니다. 저는 이를 사용하여 다른 사람들을 이기는 데 사용할 수 있습니다.
저는 이러한 일이 매우 폭넓게 영향을 미칠 것으로 생각합니다. 우리는 이러한 모델이 정확히 무엇을 할 수 있는지 모릅니다. Anthropic은 몰라요, OpenAI도 몰라요, 아무도 몰라요. 최종적으로는 최종 사용자가 직접 발견해야 합니다: 이러한 토큰들이 어디에서 사용될 수 있는지 정확히 무엇을 구축할 수 있는지 상상해 볼 수 있는지요?
이것은 분명히 생산성을 대폭 향상시킬 것이며, 인류에게 매우 긍정적인 면을 가지고 있을 것입니다. 그러나 문제는 자원이 어떻게 집중되고 사용 권한이 어떻게 집중될지인 것입니다.
로봇은 다음 요구 사항 이라인을 연결할 것입니다
Patrick O'Shaughnessy:
지금, 로봇이나 로보틱스가 소비하는 토큰은 다른 분야와 비교했을 때 거의 무시해도 괜찮을 만큼 작습니다. 어떻게 생각하십니까? 이것이 두 번째 수요 곡선이 될 것입니까? 여기에는 매일 한 마일 내에 새로운 로봇 기업이 떠오르며, 흥미로운 것들을 만들려고 합니다.
Dylan Patel:
여기에는 "소프트웨어 전용 싱귤래리티"라는 개념이 있습니다. 즉, 세상에는 먼저 소프트웨어에서만 발생하는 인공지능 싱귤래리티가 나타날 수 있다는 것입니다. 그러나 문제는, 세계의 대부분이 여전히 물리적입니다. 당신은 이를 보게 될 것인데, 결국 세계는 하드웨어 중심으로 조직화될 것이고, 소프트웨어만이 아닌 것입니다. 그래서 나는 "소프트웨어 싱귤래리티"가 최종 목표가 아니라 단계에 머무를 것이라고 생각합니다. 우리는 결국 물리적 세계로 진입하게 될 것이기 때문입니다.
소프트웨어가 매우 쉬워지면, 로봇의 진정히 어려운 부분은 무엇인가요? 프로그래밍, 마이크로컨트롤러, 액추에이터, 그리고 이 모든 것을 제어하는 것입니다. 이제 이 모든 것들은 매우 어려워졌습니다.
AI 모델에는 흥미로운 특징이 있습니다: 그들의 학습 효율은 실제로 매우 낮습니다. 우리가 그들에게 대량의 데이터를 제공했기 때문에 그들은 무언가를 배웠고 때로는 인간을 능가했습니다.
하지만 현재의 로봇 모델인 VLA, 즉 Vision-Language-Action, 시각-언어-동작 모델은 매우 인기가 있지만, 나는 이것이 계속 확장될 수 있는 최종적인 것은 아닐 것이라고 생각합니다. 그들의 데이터 효율은 매우 낮으며 우리는 로봇 데이터 규모를 충분히 빠르게 확장할 수 없습니다.
미래에서는 로봇 모델을 대규모로 사전 교육할 수 있는 방법이 반드시 나올 것입니다. 인간이 평생 동안 다양한 데이터를 계속 보는 것과 같습니다. 인간의 진정한 장점은 매우 "샘플 효율적"이라는 점에 있습니다. 한 번의 예시, 두 번의 예시를 보면 우리는 배울 수 있습니다.
이 능력을 로봇에 적용하면 상황은 전혀 다릅니다. 소프트웨어 층 수준의 특이점이 발생하면 구현은 매우 저렴해지며 누구나 이러한 모델을 구축할 수 있습니다. 그러면 사람들은 실제로 유용한 로봇을 구축할 수 있습니다.
그래서 나는 앞으로 6개월에서 18개월 안에 로봇 분야의 진정한 돌파를 보게 될 것이라고 생각합니다. 핵심 능력은 few-shot learning, 즉 소량의 샘플 학습입니다. 그때에는 사전 교육된 로봇 모델이 있고, 당신은 로봇을 고용하거나 구매하고, 몇 가지 예시를 보여주면 그 작업을 수행할 수 있을 것입니다.
양 이것을 쌓으라고 말하면 할 것입니다. "이 것은 실제로 균형을 유지할 수 있는 것이에요."라고 말하면 시도하고 완료할 것입니다. 제게 믿어주십시오, 저는 이미 많은 것들을 넘어뜨렸습니다.
그래서 나는 로봇이 소량의 학습 능력을 갖게 될 것이라고 생각합니다.
현재 많은 회사들이 이미 로봇을 만들고 있습니다. 일부는 광고 쇼를 위한 것이고, 일부는 매우 간단한 작업을 수행하기 위한 것입니다. 그러나 다음은 매우 세분화될 것입니다. 예를 들어 옷을 접는 데 특화된 로봇이 있을 것이고, 더 세분화된 데서는 칠판을 청소하는 로봇이 있을 것입니다. 이것은 렌탈 서비스가 될 수도 있고, 모델 팩일 수도 있으며, 표준 로봇에 다운로드하여 해당 작업을 수행하고 사용료를 지불할 수 있을 것입니다.
어쨌든, 물리적 상품 분야는 큰 가속화를 경험하게 될 것이며, 이는 디플레이션 효과를 초래할 것입니다. 그리고 그 결과 결국은 토큰 수요의 미친 성장을 이어갈 것입니다. 그래서 개인적으로 나는 토큰 수요가 둔화하지 않을 것으로 보고 있습니다.
Patrick O'Shaughnessy:
Metis로부터의 결과 및 해당 모델의 구축 방식으로 미루어 무엇을 이 세계에 대해 새로 알게 되었나요? 다시 말해, 스케일링 법칙의 각 구성 요소를 분해하여 살펴보면, 예를 들어 사전 훈련 부분...
Dylan Patel:
이전 모델보다 훨씬 큰 모델입니다. 10만 블록 블랙웰은 이전 세대 수십만 블록 칩에 해당합니다. 물론 TPU와 Triton은 각자 다른 릴리스 속도를 갖고 있기 때문에 완전히 일대일 대응되지는 않습니다. 그러나 최종적으로 Metis는 확실히 더 큰 모델입니다. 그것은 스케일링 법칙이 여전히 유효함을 입증했습니다. 그것이 보여주는 모든 것은 모든 추세선이 계속 이어지고 있다는 것을 보여줍니다: 모델에 더 많은 계산 능력을 투입하면 모델이 더 좋아집니다.
그리고 전체 프로세스 동안, 단순히 "더 많은 계산 능력이 모델을 향상시킨다"에 그치지 않습니다. 동시에 우리는 계속해서 계산 효율성을 향상시키고 있습니다. 연구소가 투입한 모든 연구 및 개발 계산 능력은 마침내 하나의 결과로 이어졌습니다: 내가 특정 능력 수준의 모델을 원한다면, 6개월마다 또는 지금은 2개월마다 그 능력에 도달하는 데 필요한 비용이 크게 감소할 것입니다. 그러나 규모를 크게 확장해도 여전히 큰 능력 향상을 얻을 수 있습니다.
그래서, 네, 그것은 이러한 일이 계속 일어나고 있다는 것을 입증했습니다. Google과 Anthropic은 훈련 측면에서 GPU를 많이 사용하는 사용자는 아닙니다. OpenAI는 앞으로 새로운 세대 모델을 출시할 것으로 예상됩니다. 그들이 스케일링에서 취하는 것은 더 합리적이고 원칙적인 소규모 단계별 접근 방식이라고 생각합니다. 그리고 Anthropic은 이번에 거대한 도약을 한 것입니다.
올해 우리는 점점 더 좋은 모델을 보게 될 것이며, 출시 속도는 더욱 빨라질 것입니다.
Patrick O'Shaughnessy:
우리 이 대화는 꽤 오래되었지만, 거의 OpenAI에 대해 언급하지 않았군요. 이것은 이전에는 매우 이상한 일이었을 겁니다.
Dylan Patel:
이것이 흥미로운 점입니다. 많은 사람들이 지금 Anthropic이 이미 이겼다고 말할 것입니다, 그렇죠? 2월에 Metis를 출시했지만 실제로 공개하지 않았습니다. 그럴 필요가 없다고 생각했기 때문입니다. 그들의 계산 능력은 이미 매진되었고 수입은 매월 100억 달러씩 증가하고 있습니다. 그리고 오늘 Opus 4.7을 또 공개했으며, 이 모든 일들이 OpenAI의 Spud 출시 소문 이전에 발생했습니다— 'The Information' 등 여러 매체가 이 소문을 보도했습니다.
그래서 표면적으로는, Anthropic은 분명 우세한 모습을 보이고 있으며, OpenAI는 완판된 것으로 보입니다. 그러나 흥미로운 점은, Anthropic은 계산 능력 측면에서 매우 제한을 받고 있어, 그들이 확장할 수 있는 속도가 제한적이라는 점입니다. Dario는 이전에 OpenAI가 계산 능력 투자에 너무 과감했고, Anthropic의 스케일링이 더 합리적이라고 자랑스럽게 말했었습니다. 그러나 이제 Anthropic은 also thought: 우리는 처음에 더 많은 계산 능력이 있었어야 했다.
한편, OpenAI는 이러한 비용을 완전히 감당할 능력을 갖고 있습니다. 사실, 그들은 이미 많은 자금을 조달하여 더 많은 증분 계산 능력을 확보하고 있습니다. 뿐만 아니라 그들은 이전에 Oracle, CoreWeave, SoftBank, Microsoft 등의 기업에서 매우 과감하고 때로는 조금 「무책임한」 규모로 계산 능력을 구입했습니다. 그리고 이제 그들은 Amazon으로부터 Trainium도 받았습니다.
그래서 OpenAI는 계산 능력 측면에서 매우 미친 짓을 하고 있으며, 더 많이 필요하다는 것도 인지하고 있습니다.
흥미로운 점은, 만약 우리가 Opus 4.6을 살펴본다면, 모델이 계속해서 강해지는 것을 일단 떠나 이 기술의 보급만을 살펴봅니다. 당신과 나는 모델이 출시되는 첫날에 즉시 사용할 수 있다고 생각할 수 있지만, 다른 기업은 시간이 필요합니다. 사람들도 배워야 합니다. 그 "Claude의 각성 시간" 이것은 모두에게 동시에 적용되지는 않을 것입니다. 따라서 연말까지, Opus 4.6 수준의 모델을 가정하면, 전체 생태계가 이를 위해 매년 1000 억 달러를 지불하려 할 것이라고 생각합니다. 결국, 지금은 이미 400 억 달러를 소비하고 있기 때문에 이는 과장되지 않는다고 생각합니다.
Patrick O'Shaughnessy:
이것은 기본적으로 선형 외삽일 뿐입니다.
Dylan Patel:
네, 이것은 선형 외삽이며, 지수적 외삽이 아닙니다. 지수적인 성장을 실현하려면 더 좋은 모델이 필요합니다. 그러나 Anthropic은 이러한 수요를 충족시키기에 충분한 계산 능력이 없습니다. 따라서, OpenAI나 Google이 이 능력 수준에 빨리 도달하게 된다면, 누가 먼저 달성하든 상관없습니다.
Anthropic는 아마도 70%의 총수익을 올릴 수 있지만, OpenAI가 다음으로 같은 능력에 도달하게 된다면, 50%의 총수익만을 걷어내도 모든 이 증분 수요를 흡수할 것입니다. 또한 아마도 그들은 또한 모든 사용자를 서비스하기에 충분한 계산 능력이 없을 것입니다. 그러므로, Metis와 같은 모델은 아마도 전 세계적으로 충분한 계산 능력이 제공된다면 5000 억 달러의 수익을 가져올 수 있을 것이며, 아마도 더 놀라울 정도입니다. 시장은 이러한 토큰에 대한 수요가 너무 강하며, 계산 능력 공급은 극도로 한정적입니다.
H100 가격 폭등에서 이미 이를 확인했습니다. GPU 수명은 계속해서 연장되고 있습니다. 명백히 2선 실험실조차도 그들의 토큰이 매진될 것이며, 1선 실험실은 말할 것도 없습니다. 1선 실험실은 더 좋은 이윤율을 보일 것이지만, 2선 실험실도 매진될 것이며, 심지어 3선 실험실도 매진에 가까울 수 있습니다.
최강 모델이 창출할 수 있는 경제적 가치는 기반 인프라가 이러한 토큰을 사람들에 제공하는 능력보다 더 빠르게 성장하고 있음을 이미 본 것입니다. 그래서 이 격차는 계속해서 확대될 것입니다. 모델 실험실의 이윤율도 계속해서 상승할 것이며, 하드웨어 공급망 및 인프라 공급망의 사람들이 깨닫게 될 때까지 계속해서 상승할 것입니다: 응, 왜 내가 내 이윤율을 직접적으로 높이지 않지?
Patrick O'Shaughnessy:
그러므로 당신은 오늘 수요 측면의 판단, 특히 SemiAnalysis의 자체적인 사례에 대해 폭발적인 성장을 겪고 있습니다. 더 광범위하게 말하자면, 사람들이 당신이 말한 'AI 정신병' 상태에 직면하면서, 자신이 할 수 있는 일을 실제로 경험하고, 실현 과정이 거의 완전히 사라지는 것을 느끼고 있습니다. 나 자신도 이를 실감했습니다. 몇 주 만에 나의 토큰 사용량이 급증했습니다.
이는 상당히 좋은 수요 측면의 판단처럼 들립니다. 그렇다면 수요 측면에서 놓친 것이 무엇인가요? 더 많은 토큰을 사용하지 않는 이상 '영원한 하부층'에서 벗어날 수 없다는 말로 풀어봐 주실 수 있나요?
다시 말해, 더 많은 토큰을 사용하고, 이러한 토큰을 통해 초과 경제가치를 창출해야 합니다. 그러나 많은 사람들이 현재의 사용 방식이 지루하고 나태합니다. 그들은 생각할 것입니다: 그럼 나는 앞으로 매일 1시간씩만 일하고 8시간을 일하지 않고, 대신 AI가 대신 대부분 일을 처리하도록 할까?
Dylan Patel:
그것은 지루한 방법입니다. 더 멋진 방법은: 나는 여전히 매일 8시간을 일하지만, 8배의 업무량을 완료하고, 아마도 5배의 돈을 벌어들일 것입니다. 5배를 벌 수 있는지는 확실하지 않겠지만, 방향은 이렇게 되어야 합니다.
물론, 하나의 일만 하는 것은 어렵습니다. 실제로 한 사람이 여러 일을 동시에 하거나, 회사를 설립하고 물건을 판매하는 사람들도 있습니다. 모두가 AI를 사용하고, 이것이 산업 표준이 되기 전에 AI가 가져다 준 경제적 가치를 먼저 잡아야 합니다. 왜냐하면 현재 그것이 완전한 표준이 되지 않았기 때문입니다. 더 많은 토큰을 사용하지 않고, 이러한 토큰에서 가치를 창출하고, 그 값을 채취하지 않으면 '영원한 하부층'에서 벗어날 수 없습니다.
사실 여기에는 세 가지 다른 문제가 있습니다: 첫째, 더 많은 토큰 사용; 둘째, 이러한 토큰에서 가치 창출; 셋째, 당신이 토큰을 사용하여 창출한 가치를 채취. 이 세 가지를 해내지 못한다면, 모델 능력이 계속해서 상승하고, 자원이 더 집중될 수 있다는 점에서 '영원한 하부층'으로 남을 것입니다.
좋아요, 공급 측면에 대해 이야기해 봅시다. 현재 무슨 일이 일어나고 있나요? 수요 곡선이 급증하는 경우, 이 모든 토큰을 처리하기 위해 공급 스택 전체가 어떻게 변화하고 있는지 살펴봅시다. 수요가 급증함에 따라 공급 측면의 모든 것이 가격 상슨 변화하고 있습니다. NVIDIA GPU든 다른 부분이든, 가격은 상승 중입니다. 동시에 그들의 수명도 연장되고 있습니다.
H100의 가격 추이가 이러한 방식입니다. 과거에는 GPU의 유효 수명이 다섯 년 미만이라고 생각했지만, 이는 전혀 사실이 아닙니다. 지금은 세네 년 전에 구축된 몇몇 Hopper 클러스터가 세 년 또는 네 년 계약을 갱신 중이며, 일부 A100 클러스터도 앞으로 몇 년 동안의 계약을 갱신하고 있습니다.
그러므로 GPU의 유효 수명은 분명히 다섯 년이 아니라, 아마 일곱 년 또는 여덟 년일 수도 있습니다. 우리는 아직 모릅니다. Hopper가 그 단계에 도달할 때 확인해 봅시다. 하지만 분명히 다섯 년이 아닙니다. 게다가 갱신할 때 가격은 상승 중입니다.
이것은 즉, 한 클러스터의 총이익률이 실제로 35%가 아닌 더 높다는 것을 의미합니다. 클라우드 층의 이익률이 확장되고 있습니다. 하드웨어 층의 이익률도 매우 건강하며, NVIDIA는 여전히 약 75%의 총이익률을 받고 있습니다. 공급망 아래로 내려가 보면, 메모리 부분의 이익률이 분명히 크게 상승했습니다. 광 모듈, 로직 칩 등의 분야에서도 대규모의 선금이 인출되었으며, 이익률이 천천히 상승하고 있습니다.
더 중요한 것은, 칩을 제조하는 NVIDIA와 같은 회사들이 거대한 선금을 지급하고 있다는 것입니다. 그러므로 총이익률이 크게 상승하지 않더라도 자본 비용, 현금 유동성 시점 또는 투자 자본 수익률이 상승하고 있습니다.
이것은 전체 공급망에서 볼 수 있습니다. ASML은 이미 모두 판매되었으며, 이제 Carl Zeiss가 생산을 확대해야 합니다. 공급망을 따라보면, 각 부분이 이미 품절되었거나 이익률이 상승하고 있거나, 선금이 지불되어 투자 자본 수익률이 향상되고 있습니다. 왜냐하면 실제로 투입해야 하는 자본이 줄어들었기 때문입니다.
이것은 공급망 전체에 통일된 추세입니다. 심지어 PCB도 마찬가지입니다. PCB를 제조하는 데 사용되는 구리 호일도 모두 소진되어, 사람들이 구리 호일에 대해 선금을 지불하기 시작했습니다.
이 제품에 아직도 '심장 박동'이 있다면, 공급망에 존재하고 소진되었으며, 사람들은 더 많은 증가 공급을 얻고 앞으로 몇 년의 공급을 조기에 확보하려고 할 것입니다.
해시파워 부족이 산업 전체에 전파
Dylan Patel:
일반적으로 공급망은 빠르게 반응합니다. 그러나 이번에는 매우 독특한 상황이 있습니다: 오늘날의 공급망은 이전 어느 때보다 복잡하며, 우리가 구축하고 있는 것도 이전 어느 때보다 복잡하기 때문에 납품 주기가 더 길어졌습니다. 다른 산업에서 18개월의 납품 주기가 없었다는 것이 아니라, 이번에는 추가 공급을 구축하는 것 자체가 몇 년이 걸립니다.
이것이 메모리의 상황입니다. 매년 메모리 생산량은 20% 또는 30%와 같이 비교적 낮은 이차 성장률로만 증가합니다. NAND는 더 낮고, DRAM은 조금 더 높습니다. 심지어 2025년 말에 수요 신호가 매우 강해져도 메모리 기업들이 즉각 대응을 시작해도 실제 증가된 생산량은 즉시 나타나지 않을 것입니다.
기존의 20%에서 30% 증가율 이외에도, 물론 그들은 추가로 조금 더 생산량을 늘릴 수 있습니다. 하지만 실질적인 신규 공급은 2028년에 나타날 것입니다. 가장 빠를 때로는 2027년 말에 나타날 수 있지만, 대부분의 가능성은 2028년일 것입니다. 이것은 매우 특별한 상황입니다. 그들이 생산을 최대한 빠르게 확대하고 싶어도 공급은 즉시 제공되지 않을 것입니다.
그 결과 메모리 가격이 천정부지로 올라갔습니다. 그리고 내가 말할 텐데, 특히 DRAM의 경우, 가격은 최소한 두 배, 세 배로 더 올라갈 것입니다.
어떤 사람들은 말합니다: "메모리 관련 이야기는 이미 너무 많이 들어서 다들 알고 있다." 그러나 실제로는 아닙니다. 여러분은 정말로 이해를 못 한 것입니다. 현재부터 DRAM은 여전히 두, 세 배로 더 올라갈 수 있으며, 이는 필요한 생산량이 그만큼 크기 때문입니다. 그들은 다른 곳에서 생산량을 빼앗아야 합니다. 자본주의 경제에서 다른 곳에서 생산량을 빼앗기 위한 유일한 방법은 일부 수요를 높은 가격으로 파괴하는 것입니다. 우리는 배급제를 운영하고 있지 않기 때문에 결국 이러한 일이 발생할 것입니다. 이윤률은 계속 상승할 것입니다.
나는 논리 칩에도 엄청난 생산량 문제가 있다고 생각합니다. TSMC는 방금 재무 보고서를 발표했는데, 그들은 자본 지출을 계속해서 늘려왔습니다. 그러나 반도체 공장을 건설하는 데에는 꽤 많은 시간이 소요됩니다. 그들은 모든 노력을 기울여 이미 가동 중인 모든 공장에서 더 많은 생산량을 뽑아내고 있습니다. 하지만 TSMC는 고속으로 가격을 인상하지 않았습니다. 그들은 "착한 사람"이기 때문에 가격을 크게 인상하지 않았고, 내 생각에는 단일 자리수로 인상했을 뿐입니다. 내가 했던 말은, TSMC는 위대한 회사이지만, 그들이 모든 가치를 추출해낼 수 있을까요? 불확실합니다.
나는 방금 금방 언급한 적도 있지만, PCB에 필요한 구리 호일, 유리섬유, 레이저 같이 상대적으로 이해하기 쉽지만 아주 세분화된 공급망이 지금 매우 긴장되어 있습니다. 더 상류로 올라가면, 반도체 웨이퍼 제조 장비 공급망은, 그것이 이미 많이 오른 것이 맞지만, 시장은 그 중요성을 심각하게 과소평가했다고 생각합니다.
TSMC의 올해 자본 지출 가이드는 560억 달러입니다. 1월부터의 예측은 574억 달러이며, 그리고 조금 더 자본 지출을 늘릴 수 있는 방법이 있다고 봅니다. 그러나 사람들이 실제로 주목해야 할 부분은 : 이것이 내년에 무엇을 의미하는가? 그리고 그 다음 해는 무엇을 의미하는가?
결과적으로 3년 후, 대만 반도체는 자본 지출을 1000 억 달러로 증가시킬 가능성이 있습니다. 또한 2년 후, 즉 2028년에, 그들은 정말로 1000 억 달러를 자본 지출로 사용할 수 있습니다. 제가 진지합니다, 대만 반도체가 2028년에 1000 억 달러를 자본 지출로 사용할 가능성이 있습니다.
많은 사람들은 이 숫자를 상상할 수 없습니다. 하지만 이것이 그들의 하향식 공급망에게 무엇을 의미합니까? Lam Research, Applied Materials, ASML과 같은 회사에게 무엇을 의미합니까? MKS Instruments와 같은 하위 공급망에게는 무엇을 의미합니까?
끝없는 채찍 효과가 더욱 확대될 것입니다.
참고: 여기서 언급된 "끝없는 채찍 효과"는 공급망에서의 증폭 효과를 가리킵니다. 구체적으로는, AI 수요는 가장 아래쪽에서는 토큰 사용량 급증으로만 보일 수 있지만, 상위 공급망으로 전달될 때 층층이 확대되어 최종적으로 더 과장된 생산 증가, 가격 인상 및 생산 능력 경쟁으로 이어집니다.
대만 반도체가 정말로 2028년에 1000 억 달러의 자본 지출을 하려고 한다면, 그리고 제게는 이게 정말 가능하다고 생각합니다. 많은 사람들은 이것이 매우 미친 짓이라고 생각할 것입니다, 하지만 그것은 실제로 일어날 수 있습니다.
Patrick O'Shaughnessy:
그렇다면 칩 생태계의 다른 부분은 어떻습니까? GPU는 계속해서 절대적인 우위를 지키고 있습니다. 그러나 CPU, ASIC 또는 기타 무언가가 새로운 기회 또는 병목 현상으로 나타날 수 있습니까? NVIDIA GPU의 우위 이외에도 주목할 만한 부분이 무엇인가요?
Dylan Patel:
네, ASIC는 분명히 성장 중입니다. 그러나 우선 AI 칩 자체에서 약간 벗어나서 다른 것에 대해 이야기해 보고 싶습니다. 우리는 FPGA에 관한 프로젝트를 진행했는데, 다음 세대 AI 프레임워크마다 약 120개의 FPGA가 필요하다는 것을 발견했습니다. 그렇다면 이것은 모든 FPGA 회사에게 무엇을 의미합니까?
CPU 측면도 마찬가지입니다. 이 모든 강화 학습 환경들, 그리고 당신과 제가 생성하는 그 "쓰레기 코드"들 - 이제 그것들은 어떤 Vercel 인스턴스, AWS 인스턴스 또는 우리가 어딘가에서 즉시 시작한 클라우드 리소스에 실행됩니다. 이 모든 것은 CPU가 필요합니다. 그래서 CPU는 현재 완전히 매진되었고 수요가 급격히 증가하고 있습니다.
Patrick O'Shaughnessy:
모든 사람이 CPU가 전체 시스템에서 어떤 역할을 하는지 이해할 수 있도록 도와주세요.
Dylan Patel:
주 CPU가 많이 필요한 이유는 주로 두 가지로 설명됩니다.
첫 번째는 강화 학습입니다. 강화 학습을 수행할 때 CPU가 매우 중요합니다.
과거에는 전체 인터넷 데이터를 모델에 투입하여 학습시켰다가 모델이 몇 가지 결과를 출력했습니다. 현재는 여전히 인터넷 데이터를 모델에 투입하지만, 그 후에 모델을 환경에 넣어 이렇게 말합니다: "와봐요, 시도해보세요." 모델은 여러 가지를 시도합니다. 마지막으로 이 환경은 모델이 시도한 결과를 성공했는지 평가하고 점수를 매깁니다. 이러한 환경은 무엇이든 될 수 있습니다. 그것은 매우 간단할 수 있습니다. 예를 들어 출력 텍스트가 올바른 형식에 맞는지 확인하거나 구조화된 출력이 올바른지 여부일 수 있습니다. 또는 매우 복잡할 수 있습니다.
지금 사람들은 이미 매우 복잡한 시나리오에 진입했습니다. 예를 들면: "나는 당신에게 이 파일을 열어서 수정하고 편집하고 업데이트하고 어느 웹 사이트로 제출해 보라고 하고 싶습니다." 또는 "나는 당신에게 시만텍스의 물리 시뮬레이션 소프트웨어를 열고 이 CAD 모델을 편집하라고 하고 싶습니다." 그래서 이러한 환경은 점차 더 복잡해집니다. 이러한 환경은 GPU가 아닌 CPU에서 실행되며 ASIC에서도 실행되지 않습니다.
ASIC 또는 GPU는 모델 자체를 실행합니다: 환경에서 입력 데이터를받아 모델에 공급하고 다양한 출력 경로를 생성합니다. 즉, 모델이 문제를 해결할 수 있다고 생각하는 다양한 방법이며 이러한 경로는 평가되고 평가됩니다. 성공적인 경로는 모델을 계속 학습시키고 업데이트하도록 가져옵니다. 그런 다음 지속적으로 반복됩니다. 그래서 이것이 CPU가 매우 유용한 첫 번째 영역입니다.
두 번째 영역은 배포입니다.
이러한 강력한 모델을 보유하고 배포할 때 모델은 코드를 생성하고 다양한 유용한 출력을 생성합니다. 그러나 이러한 출력은 GPU에서 직접 사람의 두뇌로 들어가지 않습니다. 그것들은 GPU 또는 ASIC에서 나오고 사용자가 배포 한 응용 프로그램에 들어가고, 그 응용 프로그램 자체는 보통 CPU에서 실행됩니다.
따라서 이것은 다시 한 번 매우 많은 요구가있는 영역입니다. CPU는 대부분 솔드 아웃되었습니다.
AI 가치는 GDP 통계로 측정하기 어렵다
Patrick O'Shaughnessy:
공급 및 수요 동향을 계속 평가하고 전 세계에서 가장 이를 안다는 사람이되려고 노력할 때, 알고 싶지만 아직 모르는 것은 무엇인가요?
Dylan Patel:
우리에게 있어서도 모든 사람에게 있어서도 가장 이해하기 어려운 부분은 토큰 이코노믹스 또는 토큰의 경제학입니다. 우리가 인프라를 운영하는 데 얼마나 많은 비용이 필요하며 토큰의 비용이 얼마이며 모델 비용이 얼마인지, 이러한 실험실의 수익률은 얼마인지, 실제로 평가하기가 매우 어렵습니다. 그러나 정말로 모델링하기 어려운 것은 사용량 및 채택 속도입니다.
1월에는 2월에 대한 매우 과감한 예측을 했었고, 결과적으로 Anthropic은 쉽게 넘어섰습니다. 그렇다면 우리는 이 모델을 어떻게 보정해야 할까요? 어떤 데이터 원천을 사용해야 할까요? 2월에 우리는 다시 3월에 대한 매우 과감한 가정을 했고, 결과적으로 그것들은 다시 넘어섰습니다. "100 억 달러의 추가 수익"이라는 숫자를 보면, 사람들의 반응은 대체 무슨 일이 일어난 건가요? 그들이 어떻게 100 억 달러의 수익을 추가했을까요? 누가 이 토큰을 사용하고 있나요? 왜 사용하나요? 그들은 정확히 이 토큰을 사용하여 무엇을 구축하고 있을까요? 그들이 이 토큰을 사용하여 구축한 것이 경제 전체로 어떻게 확산되었는지 알고 싶습니다. 그 결과 얼마나 많은 가치를 창출했을까요?
이는 GDP 통계로 쉽게 포착될 수 있는 것이 아닙니다. 예를 들어, 내가 사용하는 토큰으로 창출한 모든 가치는 최종적으로 더 나은 정보로 변환됩니다. 그리고 이러한 정보를 더 나은 가격에 이전보다 가격이 낮게 판매합니다.
그런 다음 이 정보는 전체 경제 시스템으로 들어가 사람들이 더 나은 투자 결정이나 경쟁 결정을 내릴 수 있게 합니다. 조명면체 회사, 데이터 센터 회사 또는 하이퍼스케일러인 경우, 이 정보의 가치는 얼마나 될까요? 이것이 경제에 미치는 영향은 무엇일까요?
어떤 주관적 지표에서도 이것은 분명히 놀랍습니다. 그러나 문제는 "유령 GDP"가 어디에 있는지일까요? 유령 GDP란 무엇일까요? 우리는 실제 경제 가치를 어떻게 추적해야 할까요?
기존 GDP 지표가 정확하지 않기 때문에 그것은 명백하지 않습니다. Dylan Patel이 얼마나 많은 GDP를 창출했는지 물으면, 숫자는 매우 작을 것이고, 제가 창출한 실제 가치와 비교했을 때 전혀 비례하지 않을 것입니다.
따라서 궁극적인 질문은: 이러한 토큰이 실제로 얼마나 가치를 창출했을까요? 직접 수입만 보는 것이 아니라 그들이 가져온 링크드 이펙트를 보아야 합니다. 그들이 이룬 모든 일들이 이후 어떤 영향을 미쳤을까요?
저는 이것이 진정한 문제이자 가장 어려운 측정 도전이라고 생각합니다. 저는 공급 측면에 대해서는 이미 매우 좋은 판단을 내렸다고 생각합니다. 수요 측면에 대한 많은 신호를 이미 알고 있습니다. 그러나 이러한 토큰이 정확히 얼마나 가치를 창출했는지, 이것은 측정과 평가하기 어려운 문제입니다. 저는 매달 이러한 대화를 해야 한다고 생각합니다, 왜냐하면 변화가 너무 빨리 일어나기 때문입니다.
AI에 대한 반대 시위가 3개월 안에 발발할 것으로 예상됨
Patrick O'Shaughnessy:
그러면 그 다음에는 무엇이 일어날 것으로 예상하시나요? 예를 들어 3개월 후에 다시 샌프란시스코에 와서 여러분을 만나게 되면, 어떤 것들을 보게 될 것으로 예상하시나요?
Dylan Patel:
대규모 반발.
Patrick O'Shaughnessy
AI에 대한 반발? 이야기좀 해봐.
Dylan Patel
사람들은 AI를 싫어해. 지금은 ICE나 정치인보다도 AI가 더 싫어진 상태. Pew가 조사를 어떻게 했는지는 모르겠지만, 분명 AI가 정치인보다 더 싫어진 것 같아.
Anthropic가 수입을 많이 올리면서, 이것이 하위에서 비즈니스 변화를 일으키기 시작할 것이다. 사람들은 AI를 더욱 두려워할 것이다. 그들은 AI를 더 많이 자신의 문제와 오랫동안 존재해온 세계적인 심층 문제를 탓할 것이다.
이러한 문제들이 부각되고, 그것들이 AI로 돌아갈 것이다. 어떤 정치인이나, 혹은 소셜 미디어의 인물이나 영향자들이 AI를 무장시켜 다른 사람을 공격하기 시작할 가능성이 매우 높다.
뉴스 기사의 댓글을 보러 가봐. Sam Altman이 두 주 동안 두 차례 화염병을 던져보았다고 하는 것을 막연치 않게 응원하는 사람들이 댓글 영역에 있을 것이다. 이것은 시작에 불과하다. 그래서 나는 3개월 내에 AI에 대한 대규모 반발이 있을 것이라고 생각해.
Patrick O'Shaughnessy:
그 감정을 상쇄하는 힘은 무엇인가? AI 산업은 어떻게 사전에 대응해야 하는가?
Dylan Patel:
첫째, Sam Altman과 Dario는 인터뷰를 중단해야 한다. 그들은 매력이 없다. 그들이 정확히 무엇을 하는지 모르겠다. 매번 인터뷰는 평범한 사람들이 그들을 더 미워하게 만든다. 예를 들어, Sam Altman이 Tucker Carlson의 프로그램에 출연했을 때, 모든 공화당인들이 OpenAI를 더욱 미워하게 만들었을 것이다. Dario도 마찬가지이다. 그들은 정말 매력이 없다. 이것이 첫 번째이다.
둘째로, 그들은 AI가 할 수 있는 긍정적이고 활기찬 일들을 보여주기 시작해야 한다.
셋째, 그들은 계속해서 'AI 기술이 전 세계를 어떻게 바꿀 것인가'에 대해 이야기해야 하는 것을 그만두어야 한다. 사람들은 이러한 능력을 듣게 되면 두려움을 느끼는데, 특히 그 기술과 아무런 실질적인 연결이 없을 때는 특히 그렇다.
Patrick O'Shaughnessy:
그들은 그것을 어떻게 활용해야 하는지 모른다.
Dylan Patel:
그리고 그들은 그 기술과도 연결되어 있지 않다. 평범한 사람들은 Anthropic이나 OpenAI의 직원들을 알지 못하며, 그들이 누구인지, 그들의 목표가 무엇인지 알지 못한다. 그들은 그 회사들을 어딘가 은밀하게 모여있는 소수의 집단으로 보기 때문에: 몇 천 명이 넘는 사람들이 세계를 변화시키려고 하며, 모든 일자리를 자동화하려고 하며, 사회를 파괴하려고 한다고 생각하는 사람들이 많다.
더불어, 이러한 기업들은 데이터 센터 및 발전소 건설을 후원하고 촉진하고 있으며, 이러한 것들은 대중에게는 세상을 오염시킬 것으로 보입니다. 사람들은 실제로 무엇이 일어나고 있는지 이해하지 못합니다. 그래서 이러한 기업들은 그 "미래에 올 것으로 예상되는 거대한 변화"에 대해 이야기하는 것을 그만두고, 현재에 대해만 이야기해야 합니다: AI가 현재 어떻게 긍정적인 영향을 미치는지. 저는 이것이 큰 조직 재편 및 브랜드 재구성이 필요하다고 생각합니다.
Patrick O'Shaughnessy:
이러한 대화를 나누게 돼서 정말 기쁩니다. 귀중한 시간 내주셔서 감사합니다.
Dylan Patel:
정말 멋지네요, 감사합니다.
[동영상 링크]
BlockBeats 공식 커뮤니티에 참여하세요:
Telegram 구독 그룹:https://t.me/theblockbeats
Telegram 토론 그룹:https://t.me/BlockBeats_App
Twitter 공식 계정:https://twitter.com/BlockBeatsAsia
 관련 기사