Bittensor 에코시스템 토큰 SN 이 3 월에 5 배 상승하여, "황인훈의 한 마디" 뒤에는 무엇이 있었나요?
원문 제목: "황 Ren Xun이 지명? SN3 월 가격 5 배 상승, 정확히 무엇을 했나요?"
원문 저자: KarenZ, Foresight News
2026 년 3 월 20 일, All-In Ventures 팟캐스트에서 유난히 특이한 대화가 있었습니다.
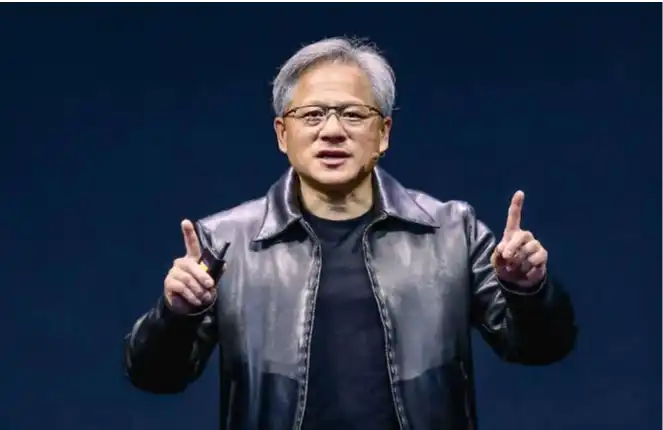
벤처 캐피탈 거물 Chamath Palihapitiya는 NVIDIA의 CEO 황 Ren Xun에게 이달 Bittensor에 프로젝트가 있다며 "상당히 미친 기술적 성취"를 달성했다고 언급했는데, 분산된 컴퓨팅 파워로 대형 언어 모델을 인터넷에서 훈련했으며, 이 과정은 완전히 탈중앙화되어 있으며 중앙화된 데이터 센터가 참여하지 않았다고합니다.
황 Ren Xun은 이 문제를 "Folding@home의 현대 버전"으로 규정했습니다. 2000 년대에 일반 사용자들이 유휴 컴퓨팅을 기여하여 단백질 접힘 문제에 함께 대항했던 분산 프로젝트입니다.
이전 4 일 전, 3 월 16 일에는 Anthropic의 공동 창업자 Jack Clark가 AI 연구 진전 보고서를 발표하면서 이 개척적인 작업에 중점적으로 소개하고 인용했습니다: Bittensor 생태 하위 네트워크 Templar (SN3)가 720 억 개의 매개 변수 대형 모델 (Covenant 72B)을 분산 훈련했으며, 모델의 성능은 Meta가 2023 년에 출시한 LLaMA-2와 유사합니다.
Jack Clark는이 섹션을 "분산 훈련으로 AI의 정치 경제에 도전"이라고 명명했고,이 기술을 계속 주시 할 가치가 있다고 강조하며 향후 상상할 수있는 것 : 기기 측 AI가 분산 훈련에서 만들어진 모델을 대규모로 채택하고 클라우드 측 AI는 전용 대형 모델을 계속 실행한다.
시장의 반응은 다소 지연되었지만 매우 격렬했습니다 : SN3은 지난 한 달 동안 440 % 이상 상승하며 지난 두 주 동안 340 % 이상 상승하여 시가 총액이 1.3 억 달러에 달합니다. 서브넷의 내러티브 폭발은 직접적으로 TAO의 매입 압력으로 이어졌습니다. 따라서 TAO는 급속하게 상승하여 한 때 377 달러에 이르렀으며 지난 한 달 동안 2 배 이상 상승하여 FDV가 약 75 억 달러에 이르렀습니다.
문제가 발생했습니다. SN3은 정확히 무엇을했습니까? 어째서 초점을 받았습니까? 분산 훈련과 탈중앙화 AI의 가치 이야기는 어떻게 변화 할 것인가요?
그 72B 모델에 관하여
이 질문에 답하려면 먼저 SN3에서 제공한 성적표를 자세히 살펴봐야 합니다.
2026년 3월 10일, Covenant AI 팀이 arXiv에 기술 보고서를 게시하여 Covenant-72B의 훈련 완료를 공식적으로 발표했습니다. 이는 720억 개의 매개변수를 가진 대형 언어 모델로, 약 70개의 독립 노드 피어(각 라운드 약 20개 노드 동기화, 각 노드에 8개의 B200 장비가 장착)가 약 1.1조 개의 토큰 데이터를 기반으로 720억 개의 매개변수 모델 사전 훈련을 완료했습니다.

Templar는 벤치마크 데이터를 제공했는데, 비교 대상인 LLaMA-2-70B는 2023년 Meta가 발표한 대형 모델입니다. Anthropic의 공동 창업자인 Jack Clark의 말에 따르면, Covenant-72B는 2026년에는 조금 오래될 수 있습니다. Covenant-72B의 MMLU 평가는 67.1점으로, 대략적으로 Meta가 2023년에 발표한 LLaMA-2-70B(65.6점)와 비교됩니다.
그러나 2026년의 최신 모델인 GPT 시리즈, Claude 또는 Gemini는 이미 수십만 개의 GPU에서 1000억을 웃도는 매개변수 훈련을 완료했으며, 추론, 코드 및 수학 능력의 격차는 백분율이 아닌 차이의 수준입니다. 이 현실적인 격차는 시장 감정에 묻혀서는 안 됩니다.
그러나 "오픈 인터넷에서 분산된 계산 능력을 사용해 훈련했다"는 전제로 환산하면 이는 완전히 다른 의미를 갖습니다.
비교를 해보죠: 분산 훈련으로 진행된 중앙 집중식 훈련 중 하나인 INTELLECT-1(Prime Intellect 팀 제작, 100억 매개변수)은 MMLU 평가에서 32.7점을 받았습니다. 다른 하나인 Psyche Consilience(400억 매개변수)는 화이트리스트 참가자들 간에 진행된 분산 훈련 프로젝트로, 24.2점을 받았습니다. Covenant-72B는 72B 규모와 67.1의 MMLU 점수로 분산 훈련 트랙에서 높은 숫자입니다.

보다 중요한 것은, 이번 훈련이 "허가 없이" 진행되었다는 점입니다. 누구나 참여자 노드가 될 수 있으며, 선행 검토나 화이트리스트가 필요하지 않습니다. 70개 이상의 독립적인 노드가 모델 업데이트에 참여했으며, 전 세계 각지에서 연결을 맺고 계산력을 공헌했습니다.
황인훈이 말한 것과 말하지 않은 것
해당 팟캐스트 대화의 세부 내용을 재구성하면, 이번 "지지"에 대한 외부 해석을 수정하는 데 도움이 됩니다.
Chamath Palihapitiya는 대화 중에 Bittensor의 기술 성취를 황인훈에게 소개하고, 분산된 컴퓨팅 파워로 Llama 모델을 학습한 것으로 묘사하며, 프로세스는 "완전히 분산되어 상태를 유지"했다. 황인훈의 반응은 이를 "Folding@home의 현대판"으로 비유하고, 오픈 소스와 프로프레인 모델이 병행하여 존재해야 한다는 필요성에 대해 논의했습니다.
황인훈은 Bittensor의 토큰이나 어떠한 투자 의미에 직접 언급하지 않았으며, 분산화된 AI 학습에 대한 추가 논의도 없었습니다.
Bittensor 서브넷과 SN3 이해하기
SN3의 돌파를 이해하려면 먼저 Bittensor 및 해당 서브넷의 작동 방식을 명확히 알아야 합니다. 간단히 말해, Bittensor는 하나의 AI 공개 체인 및 플랫폼으로 볼 수 있으며, 각 서브넷은 개별적인 "AI 생산 라인"으로 생각할 수 있으며, 핵심 임무를 명확히하고 인센티브 메커니즘을 설계하여 분산된 AI 생태계를 형성합니다.
그 작업 흐름은 명확하며 분산화되어 있습니다: 서브넷 소유주는 서브넷 목표를 정의하고 인센티브 모델을 작성합니다. 채굴자는 서브넷에서 컴퓨팅 리소스를 제공하고 AI 관련 작업(추론, 훈련, 저장 등)을 완료합니다. 검증자는 채굴자의 공헌을 평가하고 등급을 Bittensor 합의 계층에 업로드합니다. 마지막으로, Bittensor의 Yuma 합의 알고리즘은 각 서브넷의 누적 보상에 따라 서브넷 참여자에게 수익을 배분합니다.
현재 Bittensor에는 128개의 서브넷이 있으며, 추론, 서버리스 AI 클라우드 서비스, 이미지, 데이터 주석, 강화 학습, 저장, 계산 등 다양한 AI 작업을 다룹니다.
그리고 SN3는 그 중 하나의 서브넷입니다. 이는 응용 프로그램 계층 래퍼를 만들지 않으며, 사전 제작된 대형 모델 API를 임차하지 않고 대형 모델 사전 훈련이라는 AI 산업에서 가장 비싼 최중요하고 폐쇄적인 핵심 부분을 직접 겨냥합니다.
SN3은 Bittensor 네트워크를 활용하여 이기종 컴퓨팅 리소스를 조정하고, 인센티브 분산 학습을 통해 중심화된 비싼 초슈퍼 컴퓨터 클러스터가 없어도 강력한 기본 모델을 훈련할 수 있음을 입증하고 있습니다. 핵심 매력은 "평등"에 있으며, 중앙화된 훈련에 대한 리소스 독점을 깨트려 일반 개인 또는 소규모 기관도 대형 모델 훈련에 참여할 수 있도록 하면서 분산 컴퓨팅 리소스를 활용하여 훈련 비용을 낮춥니다.
SN3 발전을 주도하는 핵심 요소는 Templar이며, 이를 주도하는 연구팀은 Covenant Labs입니다. 이 팀은 Basilica(SN39, 컴퓨팅 서비스에 중점을 둠)와 Grail(SN81, RL 후 훈련 및 모델 평가에 중점을 둠)이라는 두 개의 하위 네트워크를 운영합니다. 세 개의 하위 네트워크는 수직 통합을 형성하여 대규모 모델의 사전 훈련부터 정렬 최적화까지 모든 과정을 완벽하게 커버하며, 탈중앙화 대규모 모델 훈련의 완전한 생태계를 구축합니다.
구체적으로, 채굴자는 계산 리소스를 기여하여 그래디언트 업데이트(모델 매개변수의 조정 방향 및 크기)를 네트워크에 업로드합니다. 검증자는 각 채굴자의 기여 품질을 평가하고, 오차 개선 정도에 따라 온체인 점수를 부여합니다. 결과는 보상 가중치를 결정하며, 자동으로 할당되므로 어떠한 제3자 신뢰도도 필요하지 않습니다.
인센티브 메커니즘 설계의 핵심은 보상이 "당신의 기여로 모델이 얼마나 개선되었느냐"에 직접적으로 연결되어 있으며, 단순한 해시파워 참여가 아닙니다. 이를 통해 탈중앙화된 시나리오에서 가장 어려운 문제, 즉 채굴자의 부적절한 행위 방지가 근본적으로 해결됩니다.
그렇다면 Covenant-72B는 통신 효율성과 인센티브 호환성 문제를 어떻게 해결하나요?
상호 불신, 하드웨어의 다양성, 그리고 네트워크 품질의 차이가 있는 수십 개의 노드가 동일한 모델을 협력하여 훈련하는 것은 두 가지 도전이 있습니다: 첫째, 통신 효율성. 전통적인 분산 훈련 방식은 노드 간 고대역폭 및 낮은 지연을 요구합니다; 둘째, 인센티브 호환성. 악의적인 노드가 잘못된 그래디언트를 제출하는 것을 어떻게 방지할 것인가요? 각 참가자가 정직하게 훈련하고, 다른 사람의 결과를 그대로 따라 하지 않도록 어떻게 보장할 것인가요?
SN3는 이 두 문제를 해결하기 위해 SparseLoCo와 Gauntlet이라는 두 가지 핵심 구성 요소를 사용합니다.
SparseLoCo는 통신 효율성 문제를 해결합니다. 전통적인 분산 훈련은 각 단계에서 완전 그래디언트를 동기화해야 하므로 데이터 양이 많습니다. SparseLoCo가 사용하는 해결책은 다음과 같습니다: 각 노드는 로컬로 30단계의 내부 최적화(AdamW)를 실행한 후 생성된 "의사 그래디언트"를 압축하여 다른 노드에 업로드합니다. 압축 방법에는 Top-k 희소화(가장 중요한 그래디언트 성분만 유지), 오차 피드백(버려진 부분을 다음 라운드에 누적 저장) 및 2비트 양자화가 포함됩니다. 최종 압축 비율은 146배 이상입니다.
다시 말해, 전송해야 할 내용이 100MB였던 것이 이제 1MB도 채 되지 않습니다.
이로써 시스템은 일반적인 인터넷(상향 110Mbps, 하향 500Mbps)의 대역폭 제한 하에, 계산 활용률을 약 94.5% 정도 유지하며, 20개 노드, 각 노드당 8개의 B200, 각 라운드 통신에 소요되는 시간은 단 70초로 만들었습니다.
Gauntlet은 인센티브 호환성 문제를 해결합니다. 이는 Bittensor 블록체인(서브넷 3)에서 실행되며, 각 노드가 제출한 가짜 그래디언트 품질을 검증합니다. 구체적인 방법은 다음과 같습니다: 각 노드가 그래디언트를 사용한 후에 모델 손실이 얼마나 감소했는지를 작은 데이터 일괄로 테스트하고 LossScore로 결과를 계산합니다. 동시에 시스템은 노드가 할당된 데이터를 사용하는지도 확인합니다. 노드가 무작위 데이터보다 자체 할당된 데이터에서 손실 개선이 더 좋다면, 부정적인 점수를 받게 됩니다.
최종적으로, 각 훈련 라운드에서 가장 높은 점수를 받은 노드의 그래디언트만 집계에 참여하며, 나머지 노드는 이번 라운드에서 제외됩니다. 초과 참가자는 언제든지 대체되어 시스템이 견고하게 유지됩니다. 전체 훈련 과정 동안, 평균적으로 각 라운드마다 16.9개의 노드 그래디언트가 집계에 포함되며, 누적 참여한 고유 노드 ID가 70개 이상입니다.
탈중앙화 인공지능의 가치 이야기가 근본적인 변화를 겪고 있습니다
기술과 산업의 관점에서 Covenant-72B가 대표하는 방향은 몇 가지 실질적인 의미가 있습니다.
첫째, '분산 훈련은 작은 모델에만 적합하다'는 선입견을 깨뜨렸습니다. 최신 모델과는 아직 멀지만, 이 방향의 확장성을 입증했습니다.
둘째, 무허가 참여가 실제로 가능하다는 것입니다. 이것은 과소평가되었습니다. 이전의 분산 훈련 프로젝트는 화이트리스트에 의존했습니다. 즉, 심사를 거친 참여자만이 계산 리소스를 기여할 수 있었습니다. SN3의 이번 훈련에서는 충분한 계산 리소스를 가진 누구라도 접속할 수 있으며, 검증 메커니즘이 악의적인 기여를 걸러냅니다. 이는 '진정한 탈중심화'로의 구체적인 한 걸음입니다.
셋째, Bittensor의 dTAO 메커니즘이 서브넷 가치의 시장 발견을 가능하게 합니다. dTAO는 각 서브넷이 자체적인 Alpha 토큰을 발행할 수 있도록 허용하며, AMM 메커니즘을 통해 시장이 어떤 서브넷이 더 많은 TAO 에미션을 받아야 할 지 결정합니다. 이러한 메커니즘은 결과물이 구체적으로 생성된 서브넷인 SN3의 가치 획득 메커니즘을 제공합니다. 물론, 이 메커니즘도 이야기와 감정에 영향을 받기 쉽고, LLM 훈련 결과물의 품질을 일반적인 시장 참여자들이 독립적으로 평가하기 어렵습니다.
넷째, 탈중앙화 인공지능 훈련의 정치경제적 의미입니다. Jack Clark는 Import AI에서 이 문제를 '미래의 인공지능을 소유하는 사람은 누구인가'로 높였습니다. 현재 최신 모델 훈련은 대규모 데이터 센터를 소유한 소수 기관이 독점하고 있으며, 이는 비즈니스 문제뿐만 아니라 권력 구조 문제입니다. 분산 훈련이 기술적 발전을 계속한다면, 일부 모델 유형(예: 특정 영역의 소규모 최신 모델)에서 실제로 탈중앙화된 개발 생태계를 형성할 수 있습니다. 물론, 현재 이러한 전망은 아직 멀리 떨어져 있습니다.
요약: 실질적인 성과와 다수의 실질적인 문제
황인훈은 이를 "현대판 Folding@home"이라고 비유했습니다. Folding@home은 분자 시뮬레이션 분야에서 실질적인 기여를 했지만 대규모 제약 회사들의 핵심 연구 지위를 위협하지는 않았습니다. 이 비유는 매우 정확합니다.
SN3는 프로토콜을 실행시켰고 분산 학습의 실행 가능한 방향을 검증했습니다. 그러나 기술적 및 산업적 관점에서, 이 성적표 뒤에는 다수의 실제로 심각하게 다뤄지지 않는 문제들이 남아 있습니다:
MMLU 자체가 학계에서도 논쟁이 되는 지표이며, 공개 벤치마크의 질문과 답변은 훈련 세트로의 유출 위험을 가지고 있습니다. 더 주목할 점은 베이스라인 선택입니다: 논문에서 비교한 LLaMA-2-70B와 LLM360 K2는 모두 2023년부터 2024년까지의 오래된 모델이며, 동일한 범위의 65부터 70의 점수는 Grok, Beanbag로 물어보면 중하위 수준 및 초급 수준으로 분류되는 반면 Claude의 견해에 따르면 심각하게 뒤떨어집니다. 그것을 동적으로 업데이트되는 명단이나 오염 저항력 있는 새로운 세대의 벤치마크에 놓았을 경우, 결론은 더욱 정직할 것입니다.
보다 중요한 것은 모델 능력 상한선을 결정하는 고품질 데이터 — 대화 데이터, 코드, 수학적 유도, 과학 논문 등이 대부분의 대기업, 출판 기관 및 학술 데이터베이스에 있을 가능성이 높습니다. 계산 능력이 민주화되었지만 데이터 측면은 여전히 소수자 지배 구조이며, 이 이슈는 논의되지 않았습니다.
보안에 대한 문제로, 무면허 참여는 70개가 넘는 노드 뒤에 누가 있는지, 그들이 어떤 데이터로 훈련을 하는지를 알 수 없음을 의미합니다. 가운트렛은 명백한 이상점을 걸러낼 수 있지만 세심한 데이터 독려를 막을 수 없습니다 — 한 노드가 특정 유해 콘텐츠 방향으로 계속해서 몇 라운드 추가로 훈련하는 경우 생성되는 변화가 매우 미묘할 경우, 이것은 손실 점수로 거르기 곤란하며 모델 행동에 누적 변화를 가져옵니다. 최종 문제는: 금융, 의료, 법률 등 높은 규제와 안전 요구 사항이 있는 시나리오에서 소수 익명 노드가 참여하고 데이터 출처가 불완전한 모델을 사용하는 것이 어떤 위험을 초래할지에 대한 문제입니다.
언급할 가치가 있는 또 다른 구조적 문제는 Covenant-72B 자체가 Apache 2.0 라이센스로 오픈 소스이며 SN3 토큰을 사용하지 않는다는 점입니다. SN3 토큰을 보유하면 서브넷이 새로운 모델 지속적인 배출 수익을 가져오는 것을 공유하게 되며, 모델 사용시 직접 수익은 아닙니다. 이 가치 체인은 지속적인 훈련 출력과 Bittensor 전체 네트워크 배출 메커니즘의 건강한 작동에 의존합니다. 향후 훈련이 멈추거나 새로운 훈련 결과의 품질이 기대에 미치지 못할 경우, 토큰의 가치 평가 체계가 약해질 수 있습니다.
이러한 문제들을 나열하는 것은 Covenant-72B의 의미를 부정하려는 것이 아닙니다. 이것은 이전에 불가능한 것으로 생각되었던 것이 가능하다는 것을 증명하며, 이 사실은 사라지지 않습니다. 하지만 그것을 실현하고 그 의미하는 것은 서로 다른 문제입니다.
지난 한 달 동안 SN3 토큰이 440% 상승했습니다. 이 거리 사이에 순전한 조작이 아니라는 가능성이 있으며, 이는 서사의 속도가 항상 현실의 속도보다 빠를 수 있다는 것을 의미합니다. 이 거리가 최종적으로 현실에 의해 메꿔지거나 시장이 조절하여 소화될지는 Covenant AI 팀이 이어 나갈 것이 무엇인지에 달려 있습니다.
주목할 점은 Grayscale이 2026년 1월에 TAO ETF 신청을 제출했으며, 이는 기관 자본이 이 경주로의 진입 신호를 나타냅니다. 게다가, 2025년 12월 Bittensor가 매일 TAO 보상을 절반으로 줄일 것이며, 공급 측면의 구조적인 긴장이 여전히 진행 중에 있습니다.
BlockBeats 공식 커뮤니티에 참여하세요:
Telegram 구독 그룹:https://t.me/theblockbeats
Telegram 토론 그룹:https://t.me/BlockBeats_App
Twitter 공식 계정:https://twitter.com/BlockBeatsAsia

 관련 기사